🔥 2026 年第七届 MathorCup 大数据竞赛(妈妈杯)A/B 题|全套高质量原创建模方案 + 论文 Word + 完整代码 + 结果图表 + 保姆级详细解析
🔥 独家定制版|高质量原创建模方案|支持专属定制与加密交付
对标国家级数学建模竞赛高水平论文的研究深度与工程标准!可参考历届 MathorCup 优秀获奖论文、全国大学生数学建模竞赛国家一等奖、中国研究生数学建模竞赛优秀作品以及美国大学生数学建模竞赛 O 奖论文的建模方法、逻辑组织与学术表达。
不是千篇一律的通用模板,不是简单堆砌机器学习模型,更不是缺少真实求解过程和有效结果的拼凑方案!
本系列资源围绕 2026 年 MathorCup 大数据竞赛 A/B 两道赛题,提供从赛题理解、数据分析、建模推导、算法设计、程序实现、结果验证、可视化展示到论文写作的完整学习与研究参考体系。
📦 核心资源包含:
✅ A/B 题逐问详细建模思路与技术路线
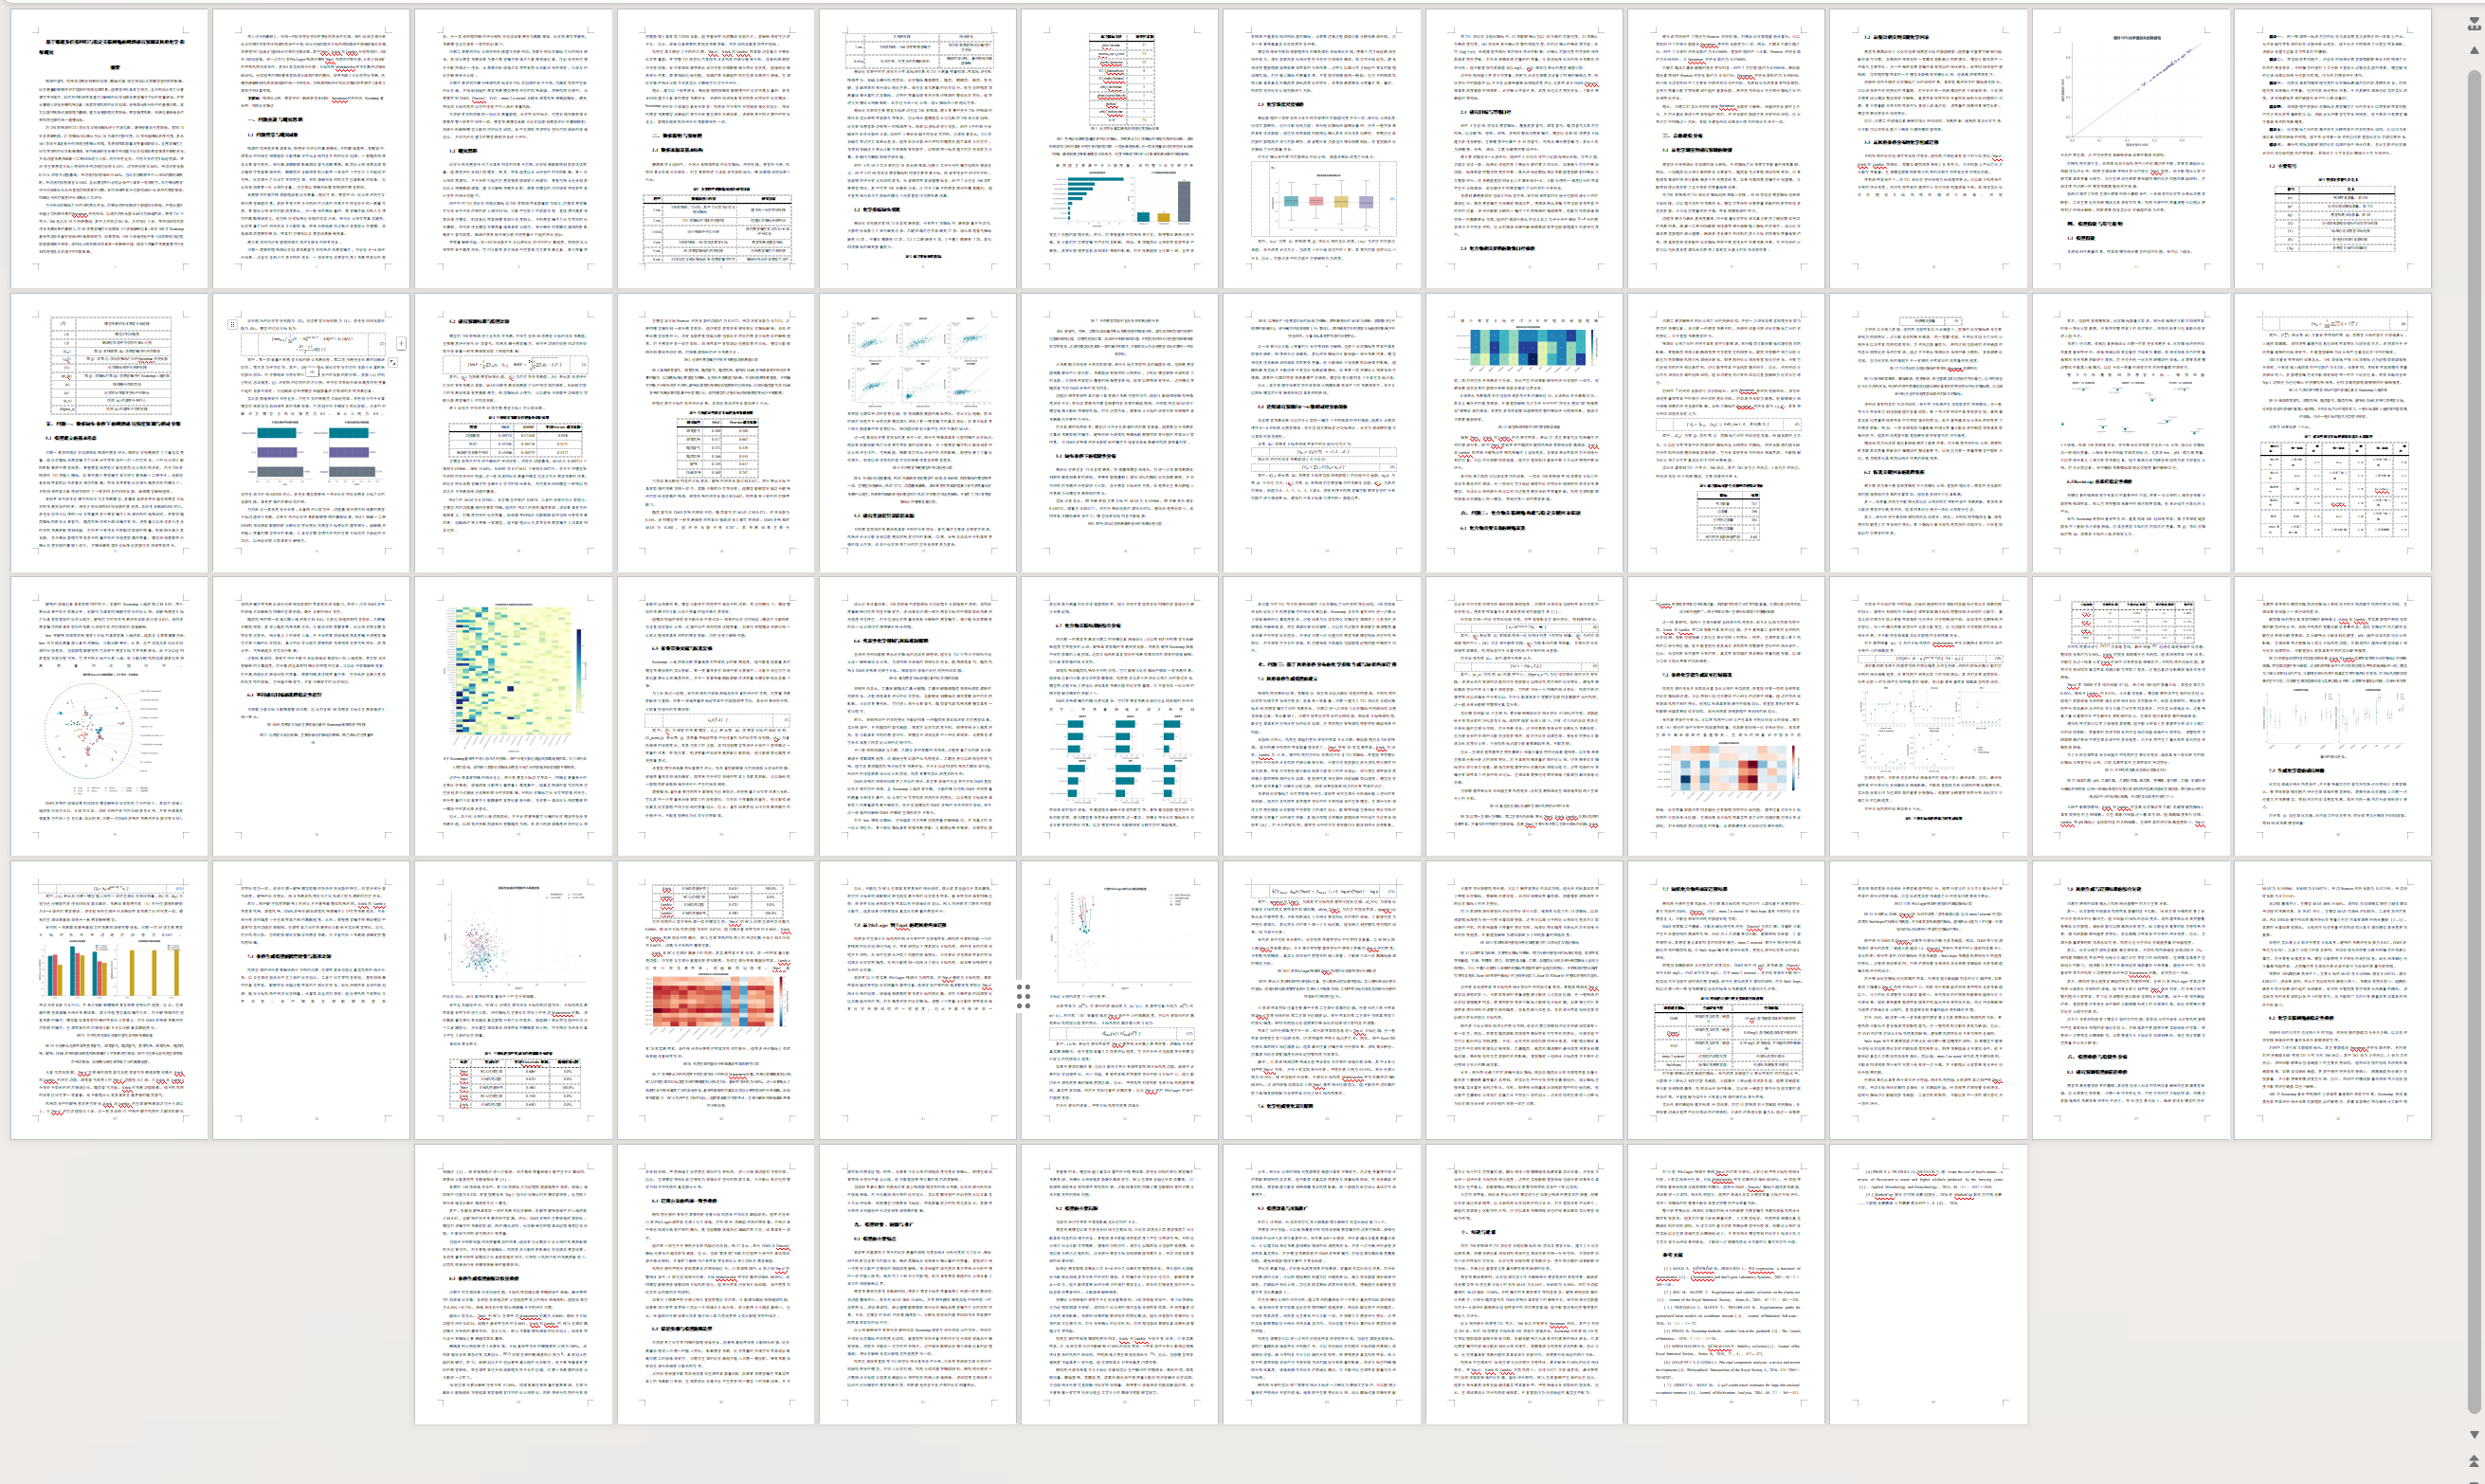
✅ 高质量论文 Word 无水印可编辑版
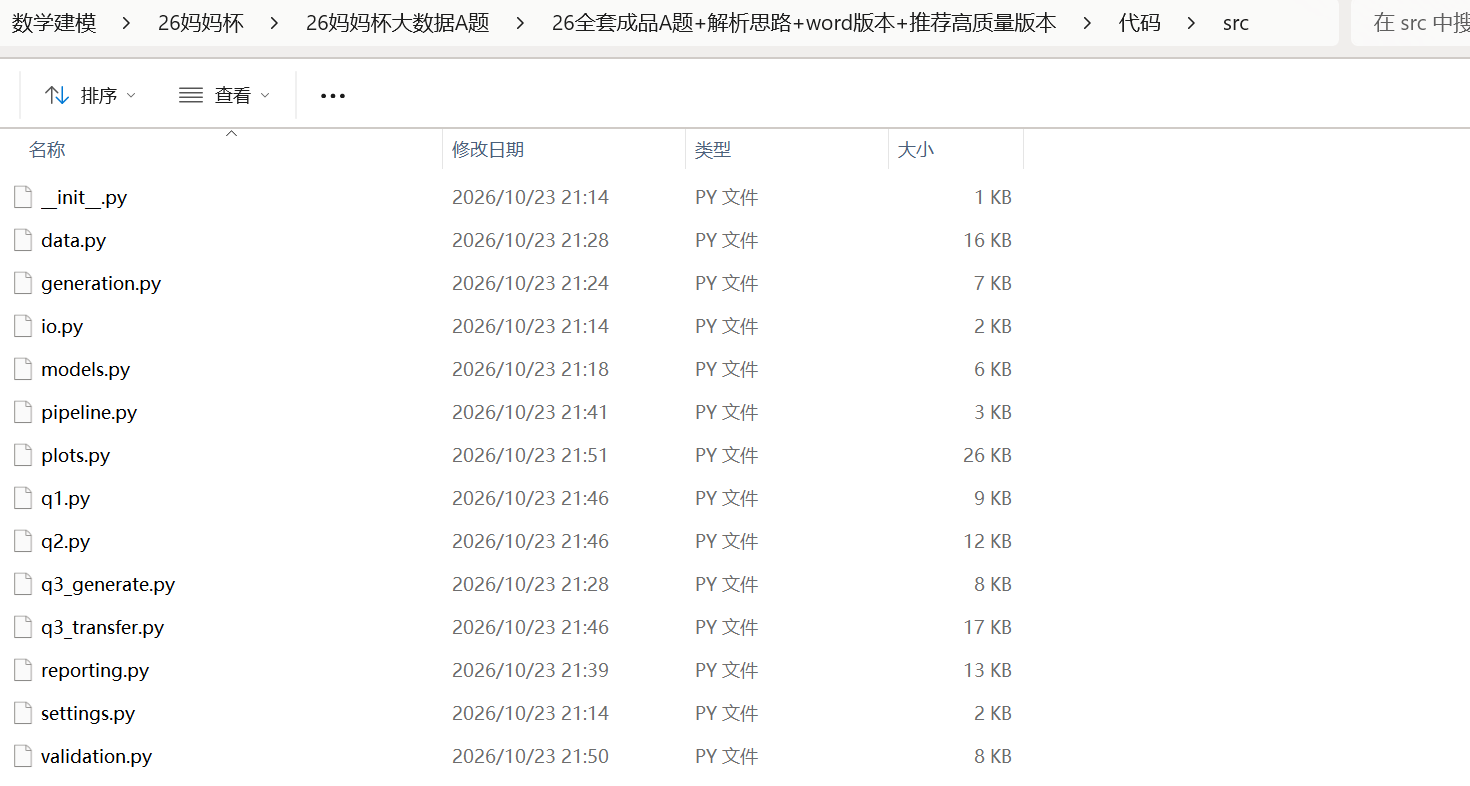
✅ Python 完整算法源码及运行说明
✅ MATLAB 建模与算法实现参考
✅ 数据预处理、特征工程与模型训练
✅ 各问题求解结果及 Excel/CSV 数据表
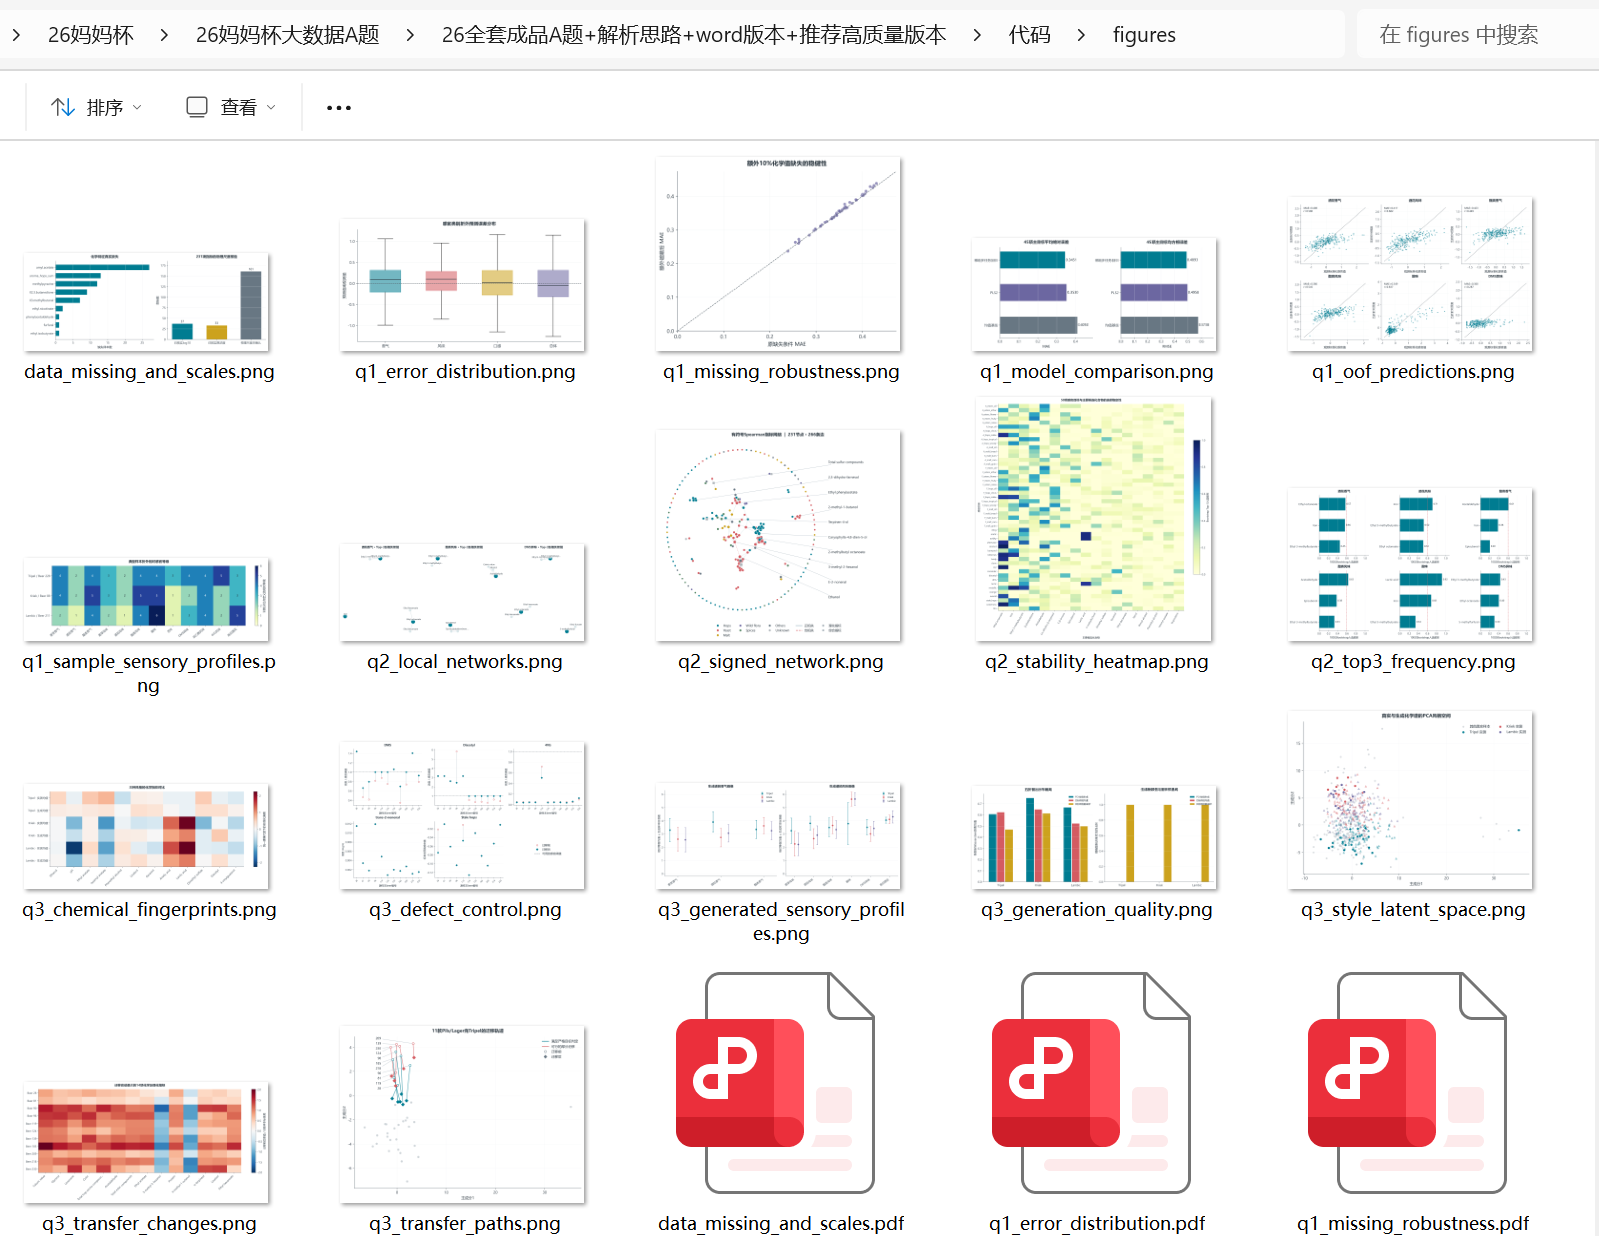
✅ 高清科研级可视化图表及绘图源码
✅ 模型对比、消融实验、误差与鲁棒性分析
✅ 论文摘要、结论、创新点及写作指导
✅ 保姆级代码复现教程与技术说明
支持队伍结合自身的研究思路、专业背景及实际实验结果开展独立研究、二次开发和深入完善。
💡
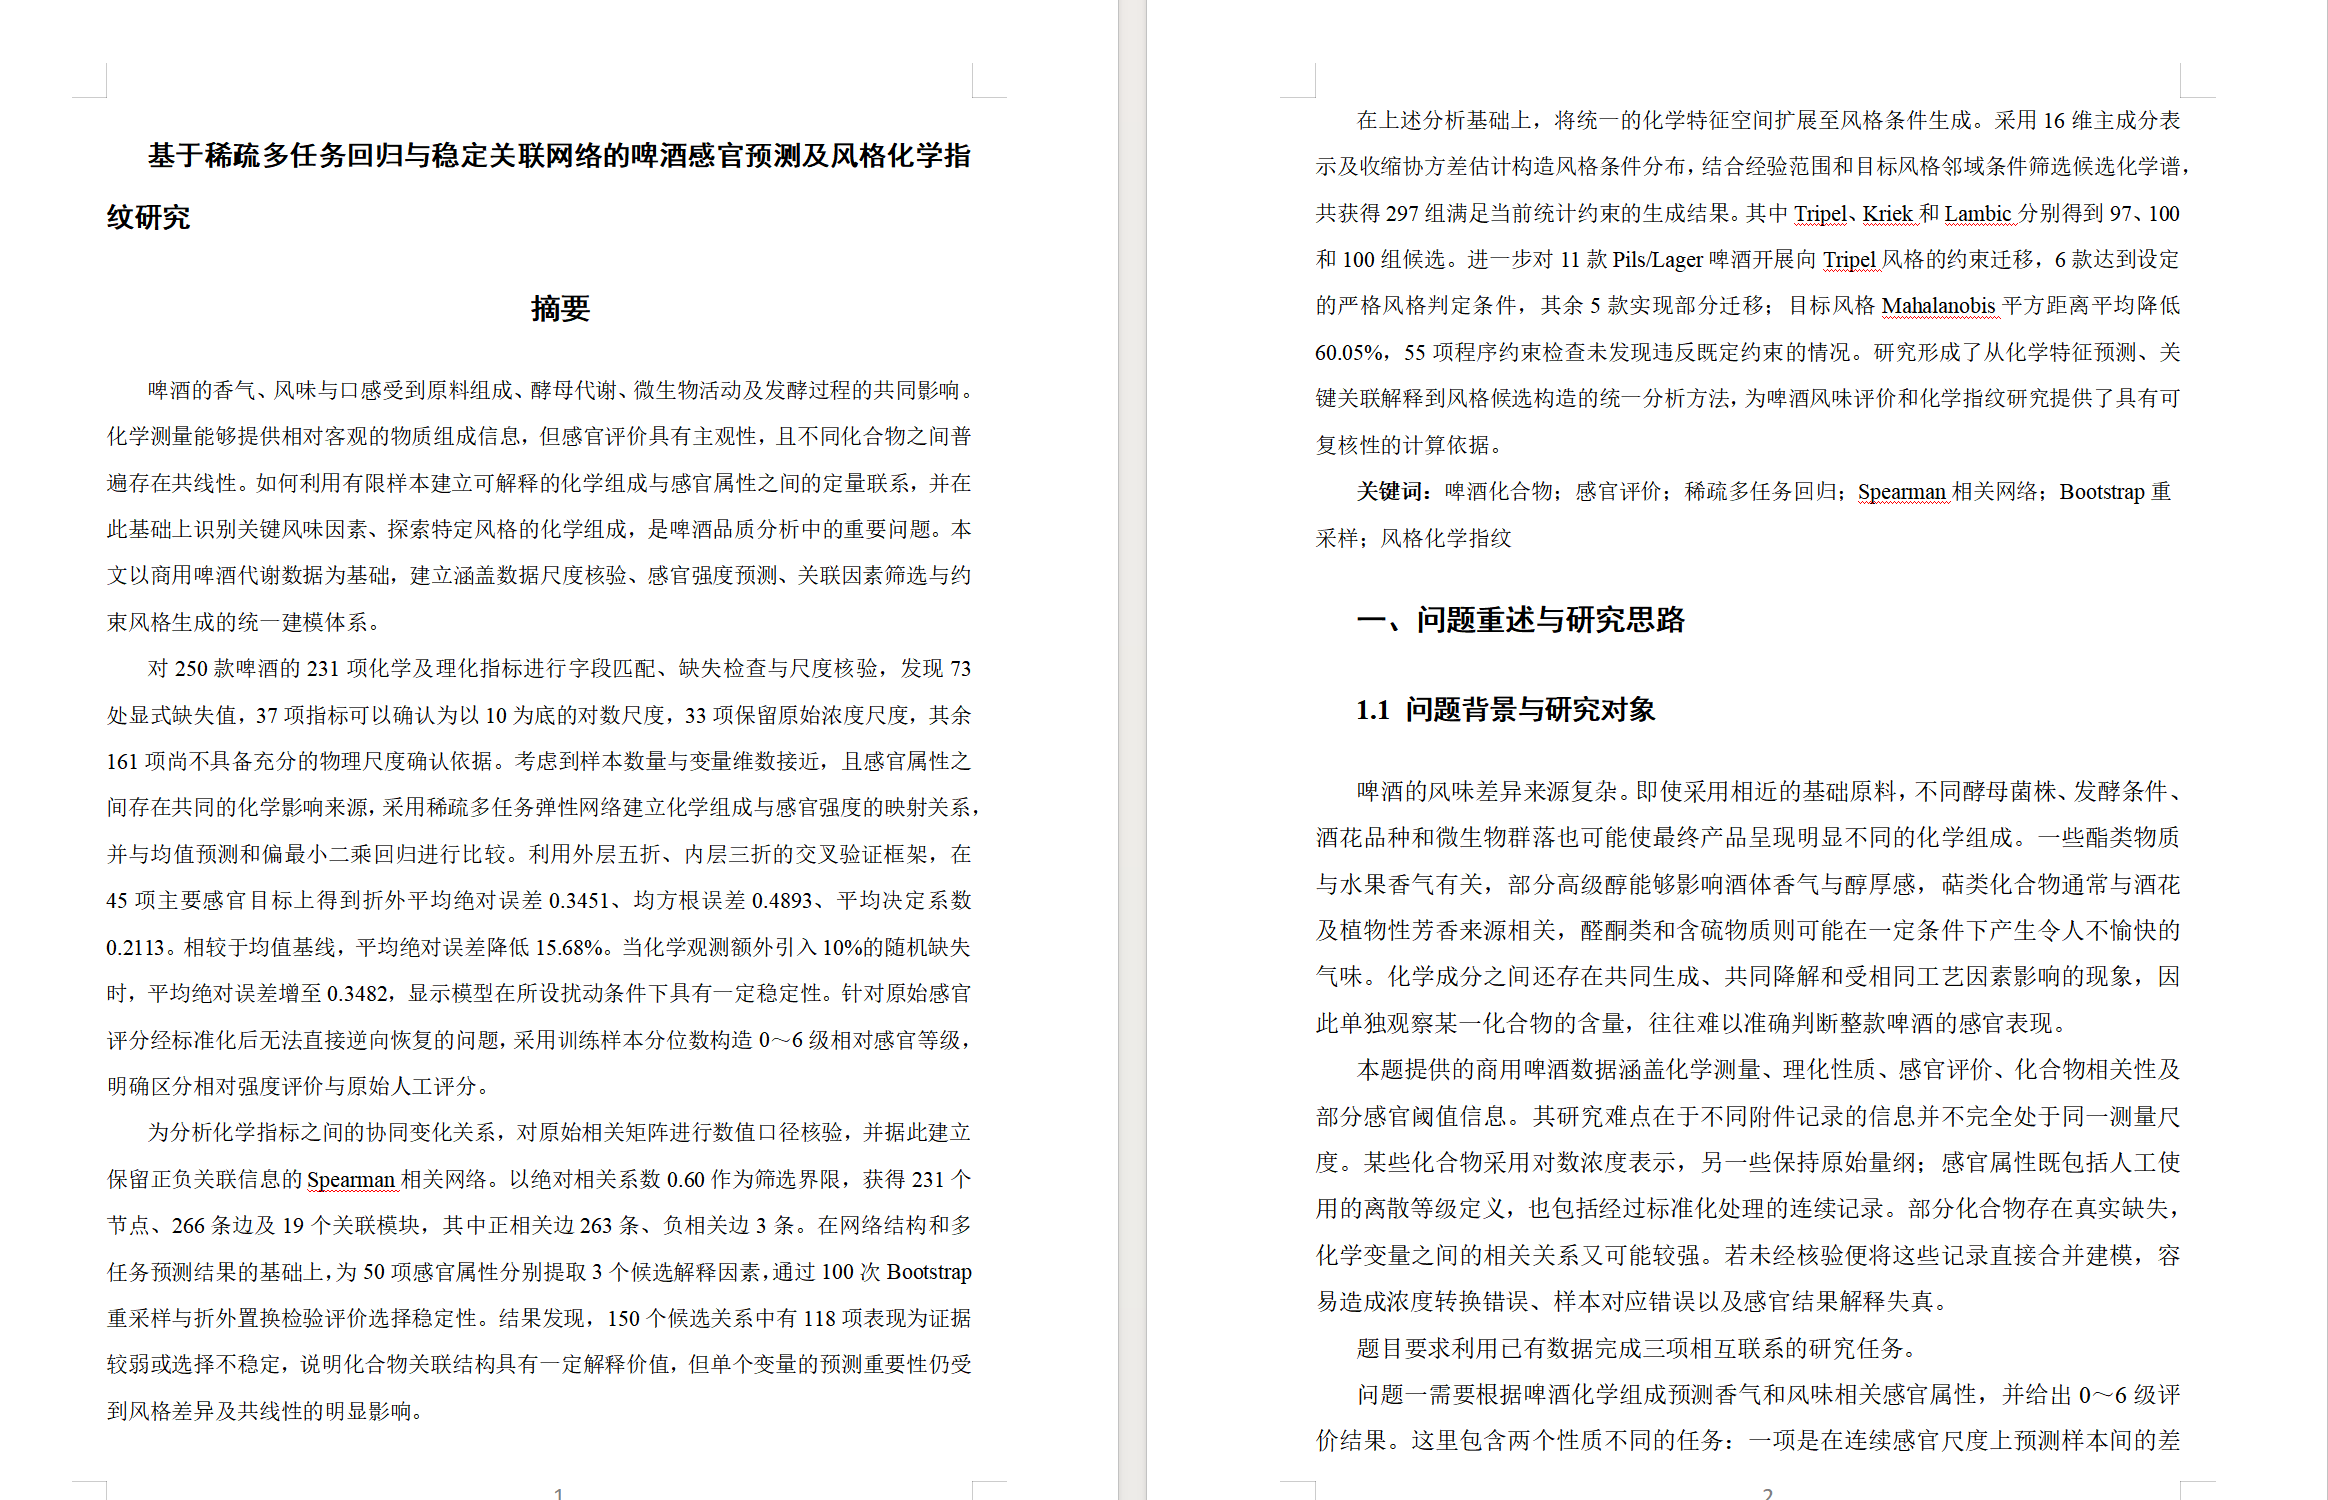
直击 2026 MathorCup 大数据竞赛 A/B 题核心难点,构建高质量数学建模解决方案!
MathorCup 大数据竞赛是一项突出数学建模、大数据处理、算法设计和实际应用能力的科技竞赛。赛题通常具有真实应用背景,强调数据分析与数学模型相结合,要求参赛队伍综合运用统计学、优化理论、机器学习、计算机技术等方法解决实际问题。
与传统偏理论推导的数学建模题目相比,大数据赛题往往更加重视:
- 真实数据处理能力: 面对复杂、多源、异构、高维数据,完成清洗、特征提取、异常识别和有效信息挖掘。
- 模型构建的合理性: 根据真实问题的机理、目标及约束选择模型,而不是简单套用算法。
- 代码工程实现能力: 将数学模型转化为可运行、可重复计算、结果可核验的算法程序。
- 机器学习与深度学习应用: 根据数据类型选择适当的分类、预测、识别、检测或优化模型。
- 模型泛化与稳定性: 不仅关注训练集效果,更重视独立测试集、跨场景评价及鲁棒性验证。
- 论文表达与结果解释: 通过规范的数学推导、可视化图表、对比实验和结果分析形成完整研究闭环。
📚 历年 MathorCup 大数据竞赛 A/B 题方向参考
从近年来公开赛题看,竞赛涉及计算机视觉、气象预测、供应链、物流管理以及智能决策等应用方向。
2023 年:
A 题涉及道路坑洼图像检测与识别,重点考查图像预处理、视觉特征提取与识别建模。
B 题涉及电商零售需求预测及库存优化,重点考查统计分析、需求预测和优化决策。
2024 年:
A 题涉及台风分类、路径及气象预测,重点考查时空数据分析、动态预测与模型评价。
B 题涉及电商品类货量预测与分仓规划,重点考查业务预测与资源配置。
2025 年:
A 题涉及集装箱智能破损检测,重点考查计算机视觉、图像识别与检测模型。
B 题涉及物流理赔风险识别及服务优化,重点考查多维数据分析、风险预测和业务决策。
2026 年:
A/B 题的具体研究对象、问题要求和技术路线,应以本届官方公布的真实赛题及附件为准。赛前可以完成针对性技术储备,赛题公布后再进行逐问建模和实际计算。
综合历年特点,MathorCup 大数据竞赛的关键不只是选用先进算法,而是建立贯穿全题的完整研究体系:
问题理解 → 数据探索 → 特征工程 → 数学建模 → 算法求解 → 实验验证 → 结果解释 → 应用建议。
🌟 一、2026 MathorCup A/B 题逐问超详细建模思路
很多队伍拿到大数据赛题后,最容易遇到三个问题:
第一,看不懂题目真正要求解决什么。
题目背景涉及实际工程或企业业务,但参赛队伍往往只关注表面的数据分析任务,忽略研究对象、变量关系、约束条件和最终评价指标。
第二,盲目选择复杂模型。
面对机器学习或深度学习问题,直接堆叠 XGBoost、LightGBM、LSTM、Transformer 等模型,却没有解释为什么选用这些算法、模型是否与数据匹配、效果是否真正优于简单基线。
第三,论文缺少完整的实验验证。
只给出若干预测数值和模型结果,却缺少数据分析、参数选择依据、实验对照、消融研究、敏感性分析以及模型失效条件讨论。
针对这些问题,完整建模资源将重点围绕以下内容展开。
1. 赛题深度拆解
逐问分析:
- 研究背景与实际意义。
- 数据集结构与变量含义。
- 题目显性要求和隐含约束。
- 各问题之间的逻辑联系。
- 目标变量与评价指标。
- 数学模型输入及输出。
- 不同建模路线的适用条件。
- 各问题所需结果和图表。
- 论文整体逻辑结构。
不仅告诉你“这一问用什么模型”,更注重解释:
为什么这样建模?模型解决了什么问题?为什么其他方法不一定合适?如何通过实验验证模型有效性?
2. 数据预处理与深度探索
根据实际附件的数据类型,系统开展:
- 数据结构分析与字段含义检查。
- 缺失值及异常值检测。
- 重复数据清洗。
- 数据分布与类别不平衡分析。
- 特征相关性研究。
- 高维特征筛选与降维。
- 时序数据平稳性及周期性分析。
- 图像数据增强与样本质量分析。
- 数据集划分及泄漏风险检查。
- 数据标准化、归一化及编码处理。
所有预处理步骤尽可能通过代码自动复现,并提供处理前后的对比结果。
3. 数学模型构建与算法设计
根据官方赛题真实要求,选择适用方法:
机器学习方向:
- 随机森林与梯度提升树。
- XGBoost、LightGBM、CatBoost。
- 支持向量机。
- 聚类分析与异常检测。
- 特征选择与模型解释。
深度学习方向:
- CNN 图像分类与特征提取。
- 目标检测和图像分割。
- LSTM、GRU 等序列模型。
- Transformer 类时序预测模型。
- 注意力机制及模型改进。
- 迁移学习与预训练模型微调。
预测与统计方向:
- 回归预测与误差评价。
- 时间序列特征构建。
- 多变量动态预测。
- 时空关联建模。
- 概率预测与不确定性估计。
- 多模型集成与融合。
运筹优化方向:
- 线性与整数规划。
- 多目标优化。
- 遗传算法、粒子群等启发式算法。
- 鲁棒优化与约束优化。
- 资源配置与智能调度。
并不是每道赛题都需要使用上述全部模型,而是根据实际目标建立有依据、有实验验证的算法体系。
4. 核心难点逐一突破
围绕大数据竞赛中的常见难点,重点研究:
- 高维、海量、异构数据处理。
- 复杂模型特征工程。
- 类别不均衡及小样本问题。
- 模型过拟合与跨场景泛化。
- 时序预测中的未来信息泄漏。
- 极端样本识别与异常情况处理。
- 多目标优化中的目标冲突。
- 模型可解释性及业务适用性。
- 算法运行效率和计算资源限制。
每个关键技术环节均配套数学说明、实现路径与实验评价方法。
📄 二、高质量论文 Word 无水印可编辑完整版
围绕 A/B 题分别建立规范的数学建模论文结构。
Word 为可编辑文件,支持修改正文、公式、图表、表格、参考文献及论文格式。
论文内容包括
第一部分:摘要与关键词
准确概括研究问题、模型方法、主要结果、验证结论与实际价值。
第二部分:问题重述与研究背景
分析真实问题的研究意义,明确各小问要求。
第三部分:问题分析
说明各问题的内在逻辑、关键难点和总体建模路线。
第四部分:模型假设与符号说明
根据实际研究对象建立合理假设,统一数学符号。
第五部分:数据预处理与探索性分析
介绍数据结构、清洗流程、异常检测、特征统计和数据质量。
第六部分:各问题数学模型建立
详细推导数学公式、损失函数、评价指标和关键约束。
第七部分:模型求解与算法实现
说明算法流程、参数设置、训练过程、求解步骤及结果生成方法。
第八部分:实验结果与分析
包括模型结果、对比实验、误差评价、可视化图表和结果解释。
第九部分:模型检验与改进
包括鲁棒性分析、敏感性检验、消融实验、泛化性能及模型局限。
第十部分:结论与推广
总结核心研究成果,提出合理的改进方向和应用建议。
第十一部分:参考文献与附录
整理相关研究资料、算法说明及必要的补充结果。
✨ 论文质量重点
不是简单追求篇幅和复杂公式,而是确保:
每一问有明确任务,每个模型有合理依据,每个结论有数据支持,每张图表有解释,每项创新有实验验证。
提供规范、清晰、具有科研论文表达特点的写作参考,避免公式、代码、图表和正文结果相互脱节。
💻 三、Python + MATLAB 双版本代码资源
针对 MathorCup 大数据竞赛的实际数据特点,提供模块化的代码学习与复现框架。
Python 算法工程
主要模块包括:
- 数据读取与格式转换。
- 缺失值及异常值处理。
- 数据统计与探索性分析。
- 特征工程与降维。
- 模型训练与参数优化。
- 深度学习模型构建。
- 模型验证与交叉验证。
- 预测结果生成。
- 优化算法求解。
- 敏感性及鲁棒性分析。
- 高清图表生成。
- 数据和结果导出。
MATLAB 建模工程
根据实际赛题需求提供:
- 数学机理模型。
- 数值计算与求解。
- 数据分析与可视化。
- 传统机器学习模型。
- 优化算法与参数标定。
- 统计验证与结果导出。
对于依赖特定深度学习框架或第三方模型的功能,明确列出软件及工具箱依赖。
🔧 代码设计特点
完整注释: 关键算法、变量、参数均提供中文解释。
模块化管理: 各个小问独立实现,便于调试和修改。
相对路径: 所有输入输出路径以工程根目录为基准。
结果可追溯: 模型参数、数据版本与结果文件保持一致。
图表自动生成: 运行指定脚本即可生成对应结果图。
便于二次开发: 支持根据数据特点替换模型、调整参数和增加对比实验。
📊 四、全套结果数据与科研级可视化图表
高质量数学建模论文需要通过充分的实验和可视化结果说明模型的有效性。
资源提供与实际问题相关的图表及源文件。
数据探索类图表
- 数据分布直方图。
- 核密度估计图。
- 异常值箱线图。
- 缺失值可视化图。
- 特征相关性热力图。
- 降维与聚类分布图。
模型预测类图表
- 真实值与预测值对比图。
- 模型拟合效果图。
- 预测误差分布图。
- 残差分析图。
- 不同模型性能对比图。
- 特征重要性排序图。
- 模型训练与验证损失曲线。
图像识别类图表
- 原始数据与增强结果对比。
- 分类混淆矩阵。
- ROC 曲线及 PR 曲线。
- 目标检测效果图。
- 错误识别案例分析。
- 特征响应与模型解释图。
优化与检验类图表
- 算法收敛曲线。
- Pareto 最优解分布。
- 参数敏感性分析图。
- 不同约束条件的结果对比。
- 鲁棒性分析结果。
- 算法效率与计算复杂度对比。
图表强调真实性与可复现性,不为凑数量而绘制无关图形。
所有真实结果均应通过实际数据运行获得;尚未公布赛题或尚未完成测试的部分,不使用虚构数值充当正式结论。
🚀 五、方案核心优势:专为 MathorCup 大数据竞赛设计
🌟 A/B 两题双路线覆盖
围绕真实赛题分别整理建模方案,方便不同专业背景的队伍选择更适合自身能力的研究方向。
🌟 从数据到论文完整衔接
将数据预处理、模型构建、程序实现、结果验证和论文撰写贯通,解决“代码跑出来了却不知道如何分析”的问题。
🌟 重视算法合理性与真实创新
不是盲目添加复杂模型,而是通过基线模型、改进模型、对比实验和消融分析,判断改进是否具有实际价值。
🌟 重视竞赛中的实际复现
尽量明确:
- 原始数据来源。
- 算法使用条件。
- 环境依赖。
- 参数设置。
- 实际计算流程。
- 输出文件位置。
- 结果复现步骤。
🌟 适合系统学习与深入研究
既适合需要快速掌握大数据建模流程的初学者,也适合希望深入研究算法改进、模型创新和高质量论文表达的参赛队伍。
📦 六、完整资源交付清单
✅ 2026 年 MathorCup 大数据竞赛 A 题详细建模思路与技术解析
✅ 2026 年 MathorCup 大数据竞赛 B 题详细建模思路与技术解析
✅ A/B 题 Word 无水印可编辑论文参考文件
✅ A/B 题 Python 建模与算法实现代码
✅ MATLAB 相关模型与求解程序
✅ 数据清洗与特征工程代码
✅ 各小问实验结果数据表(Excel / CSV)
✅ 模型参数、训练记录及实验配置
✅ 高清 PNG / SVG / PDF 图表及生成脚本
✅ 模型对比、消融实验、误差与鲁棒性分析资料
✅ 论文摘要、结论、创新点及写作参考
✅ 保姆级环境配置、运行和调试教程
✅ 赛题适配说明与方案更新资料
实际交付以已完成并列明的文件和资源清单为准,赛前技术框架与赛后真实赛题求解结果分别标识。
💻 七、Python 完整工程结构与运行说明
以 MathorCup 大数据赛题的常见数据建模工作流为例,采用统一的项目目录和运行方式。
1. 环境配置
建议使用 Python 3.10 或 3.11,并根据实际依赖版本配置环境。
安装环境:
python -m pip install -r requirements.txt
执行项目:
python run_all.py
Windows 用户也可以通过项目提供的 一键运行.bat 启动。
具体依赖以实际项目中的配置文件为准。
2. 标准项目结构
MathorCup_2026_Project/
├── data/
│   ├── raw/                 原始赛题数据
│   ├── processed/           预处理数据
│   └── external/            合规补充数据
├── docs/
│   ├── 2026赛题原文.pdf
│   ├── A题建模思路.docx
│   ├── B题建模思路.docx
│   └── 论文参考稿.docx
├── src/
│   ├── config.py            全局配置
│   ├── data_loader.py       数据读取
│   ├── preprocessing.py     数据清洗
│   ├── feature_engineering.py
│   ├── models.py            数学模型
│   ├── optimization.py      优化算法
│   ├── evaluation.py        实验评价
│   └── visualization.py     结果绘图
├── scripts/
│   ├── q1_analysis.py
│   ├── q2_modeling.py
│   ├── q3_optimization.py
│   ├── q4_validation.py
│   └── make_summary.py
├── results/
├── figures/
├── tests/
├── requirements.txt
├── run_all.py
├── 一键运行.bat
└── README.md
实际代码结构及小问数量根据正式赛题进行调整。
3. 结果输出说明
运行完成后,可根据真实赛题要求输出:
问题一:
数据清洗及探索性分析结果、统计指标和关键特征。
问题二:
主要预测、分类或识别模型及其独立测试结果。
问题三:
模型改进、参数优化或实际应用决策结果。
后续问题:
根据赛题要求完成进一步建模、敏感性分析、鲁棒性验证及综合评价。
同时自动生成:
- 各小问结果数据文件。
- 模型评价指标。
- 训练或求解记录。
- 高分辨率图表。
- 汇总结果表。
- 论文引用的必要图表素材。
每项输出都应与真实代码运行结果对应,未执行的实验不作为完成成果展示。
🎯 八、如何提升 MathorCup 大数据竞赛论文的整体质量?
想要让论文真正具有竞争力,不能只追求模型复杂程度。
1. 论文摘要必须体现实质性结果
重点说明:
解决了什么问题、采用什么方法、得到什么结果、经过什么验证、具有何种实际价值。
尽量使用真实、可核验的量化结果,避免没有依据地声称模型最优或性能领先。
2. 建立贯穿全文的统一技术主线
避免每一问都随意使用一种算法,导致全文缺少逻辑联系。
应明确上一问的分析结果如何支撑下一问的建模过程。
3. 基线模型不可缺少
使用合理的简单模型作为比较基础,再引入复杂模型。
只有在相同数据划分、相同评价指标及公平实验条件下,模型改进才具有说服力。
4. 创新点必须能够验证
可以从以下方向寻找真实创新:
- 问题机理与数据驱动方法融合。
- 特征工程与变量关系改进。
- 模型结构及损失函数改进。
- 多目标约束处理。
- 不确定性和鲁棒性分析。
- 算法效率与工程可用性提升。
创新不能只体现在模型名称或复杂结构上,而应体现为能够通过实验验证的有效改进。
5. 结果图表与正文分析高度统一
图表不仅要清晰美观,更要回答具体研究问题。
每个主要结果都应有相应文字解释,并讨论其适用范围与局限性。
📌 九、资源说明
本系列内容面向 2026 年 MathorCup 大数据竞赛 A/B 题的学习研究、赛题理解、算法实践和数学建模能力提升。
赛前提供历年赛题分析、方法储备和可运行的通用技术框架;正式赛题发布后,以官方题目、附件及实际实验为依据开展针对性建模。
对于各类预测精度、分类准确率、优化目标值、模型性能提升率等指标,均应以实际运行和验证结果为准,不虚构实验数据或获奖保证。
参赛队伍应遵守赛事关于独立完成、资料引用、代码使用与成果提交的规定,结合自身研究独立形成参赛成果。
🔥 2026 MathorCup 大数据竞赛 A/B 题|详细思路 + 可编辑 Word + Python/MATLAB 代码 + 结果数据 + 可视化图表 + 保姆级复现教程!
从赛题分析到数学建模,从算法实现到实验验证,从结果可视化到论文表达,系统提升你的大数据数学建模能力!