面向汽车市场销量榜单的分析系统:真实采集汽车之家「全车型销量总榜」12 个月 7786 条月度销量,完成价格区间解析、去重、CR10 与 HHI 集中度、价格带与能源结构分析,并给出「翻页失效 / 旧月份静默回退」两个采集陷阱的对比实验。第 21 套「工业规格书风」界面。
技术栈
Python、Django、Scrapy、pandas、NumPy、ECharts、MySQL
功能模块
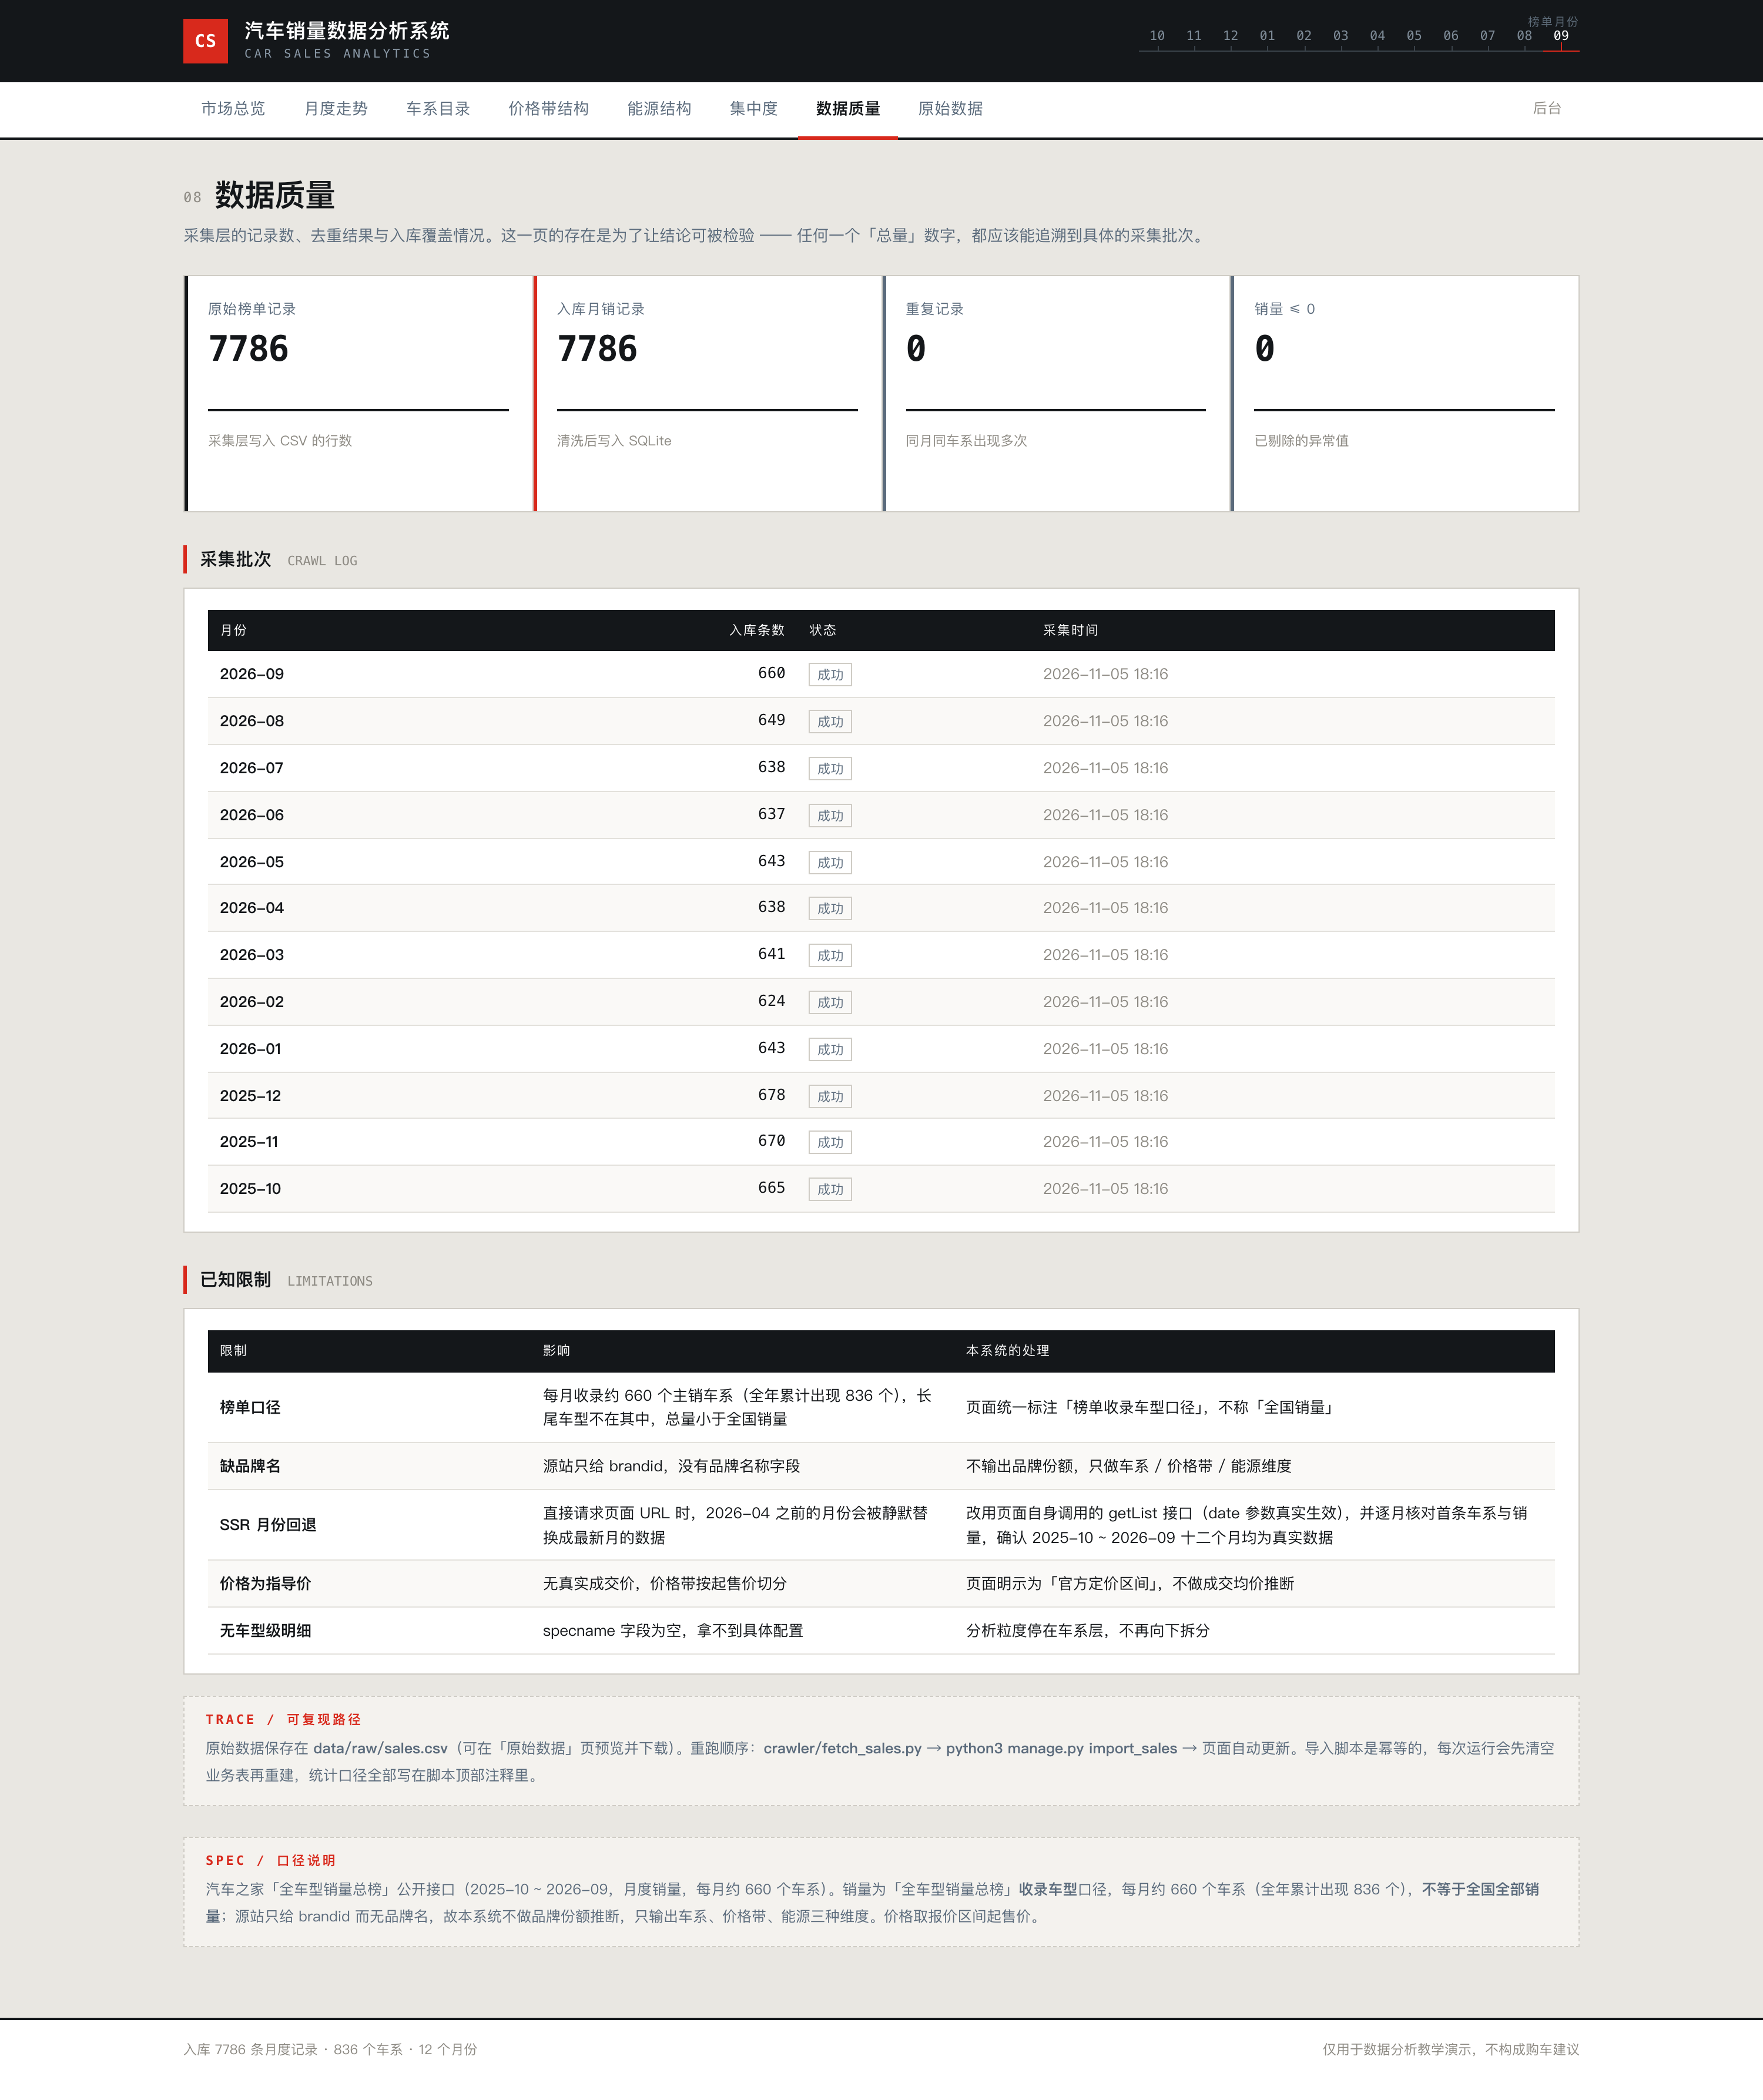
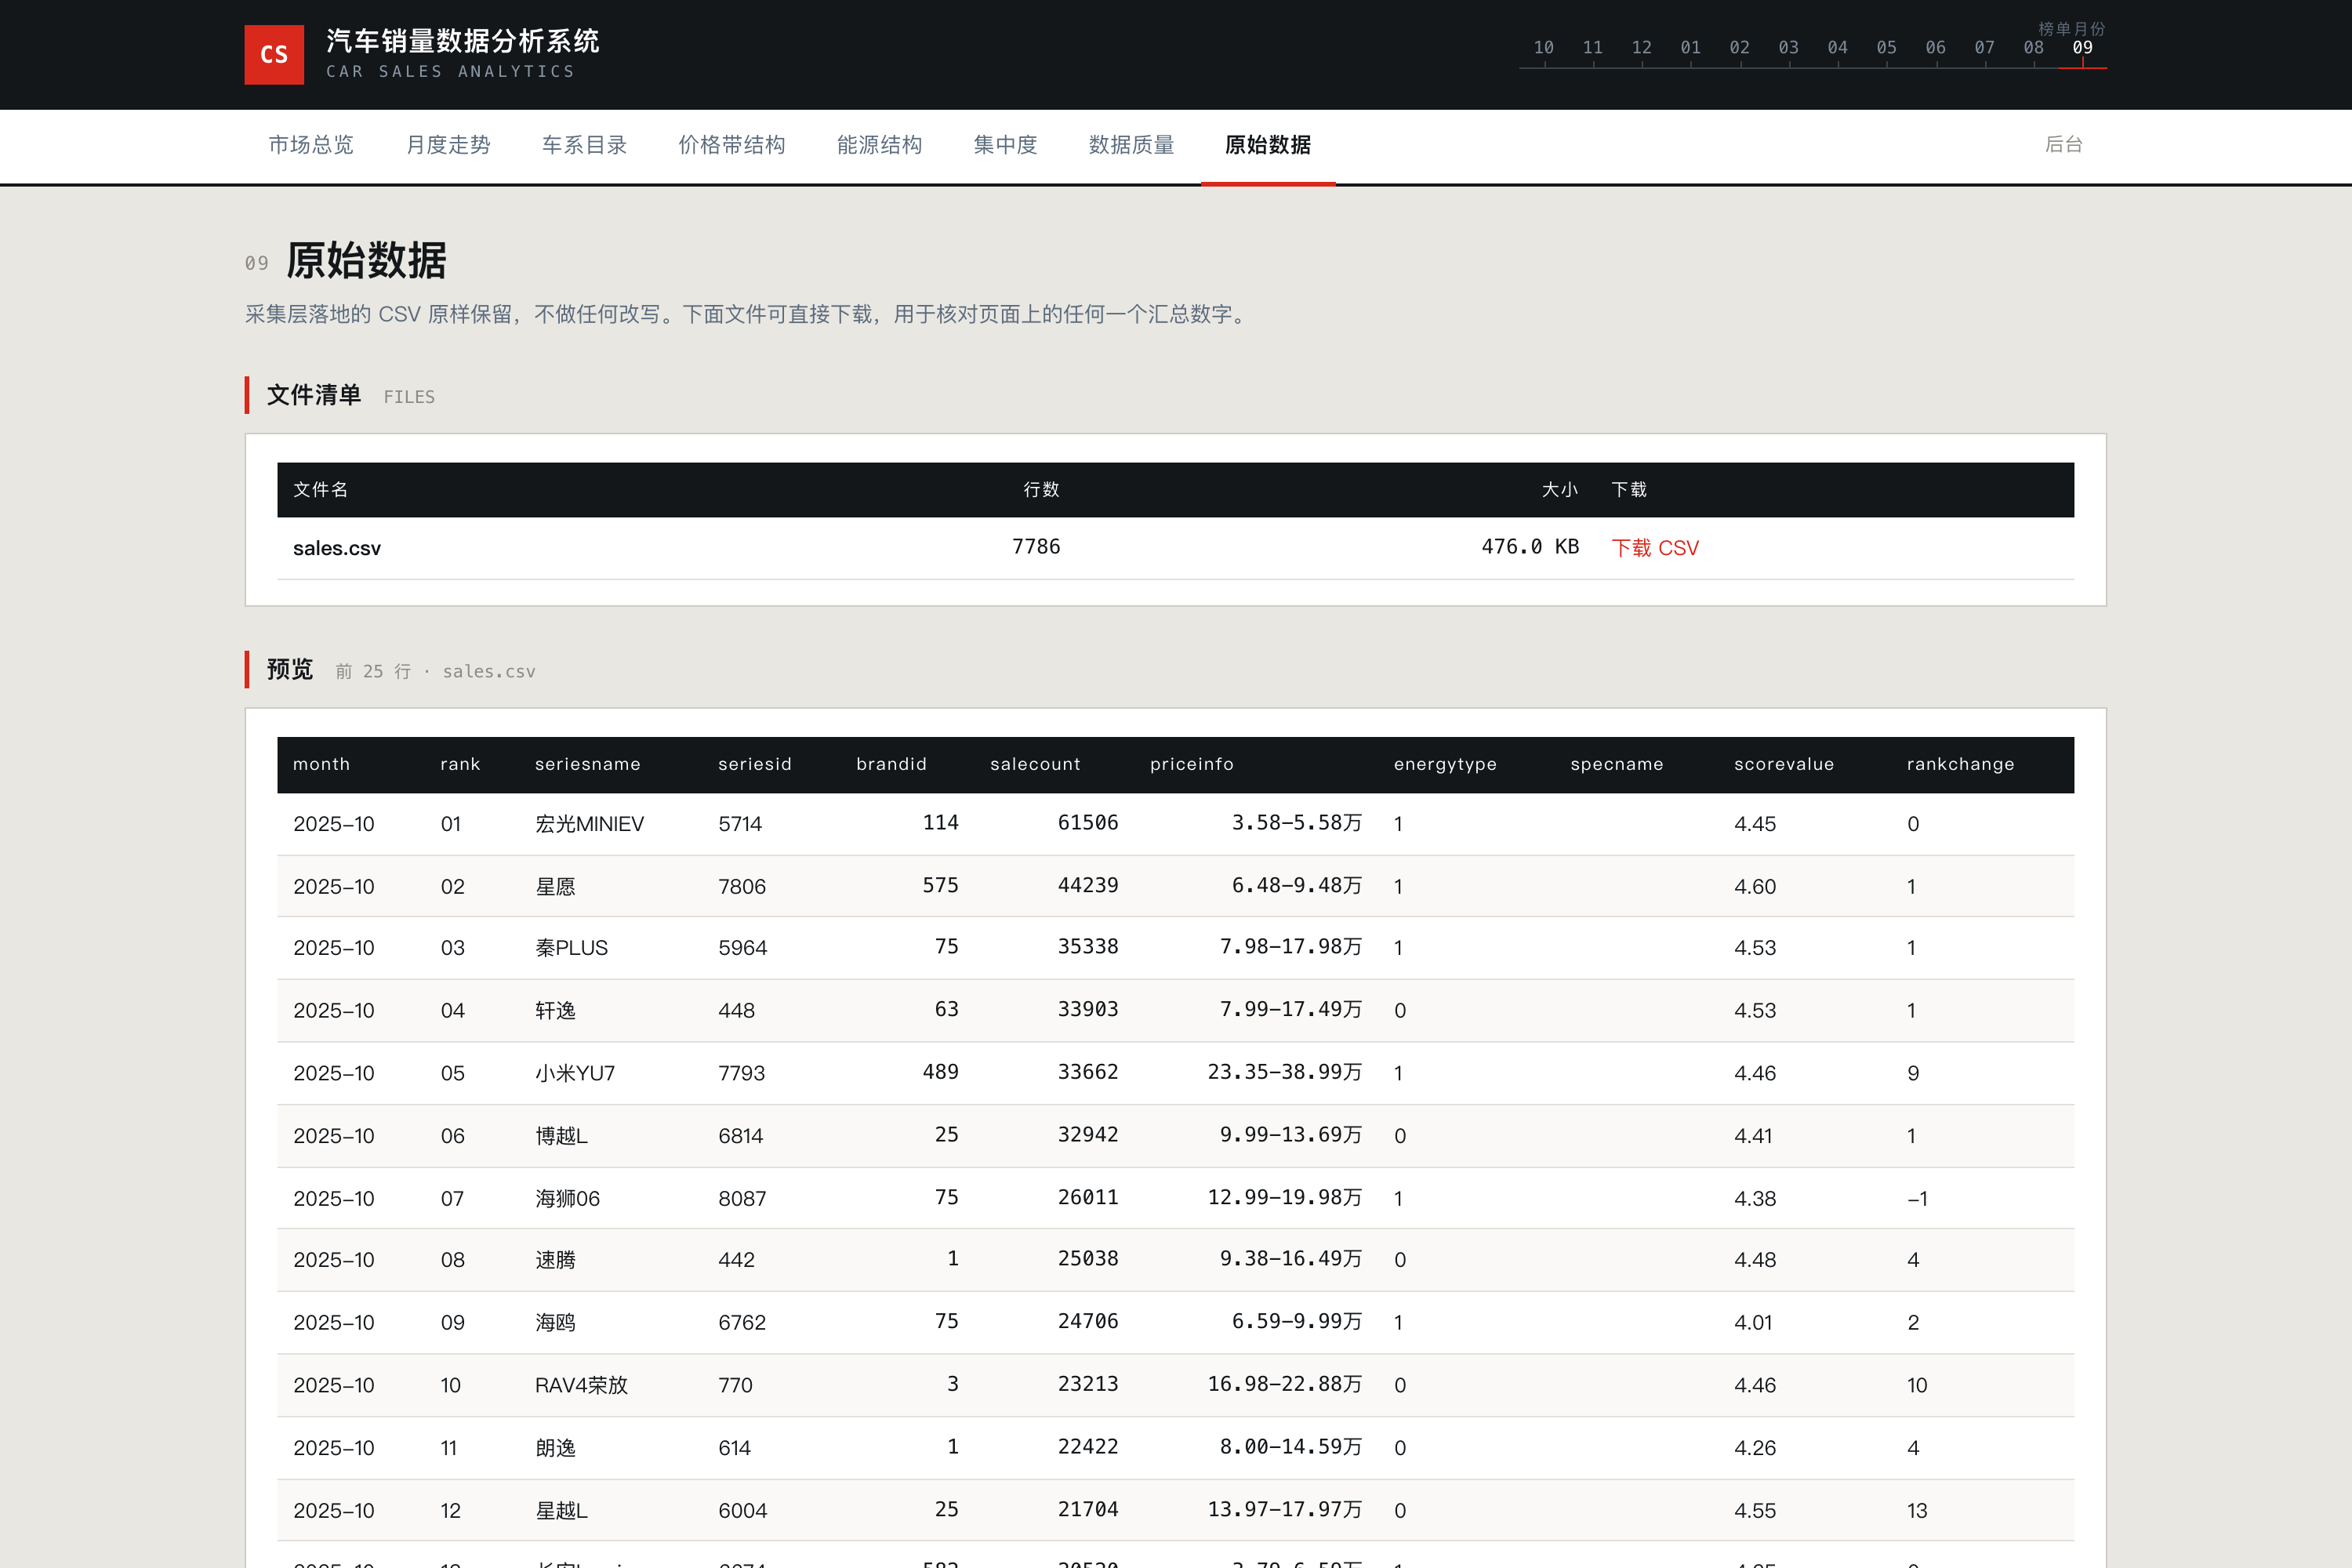
- 真实采集:汽车之家公开接口 2025-10 ~ 2026-09 共 7786 条「车系 × 月份」记录、836 个车系,原始 CSV 随包并可在页面下载;页面与论文均标注「榜单收录车型口径,非全国销量」
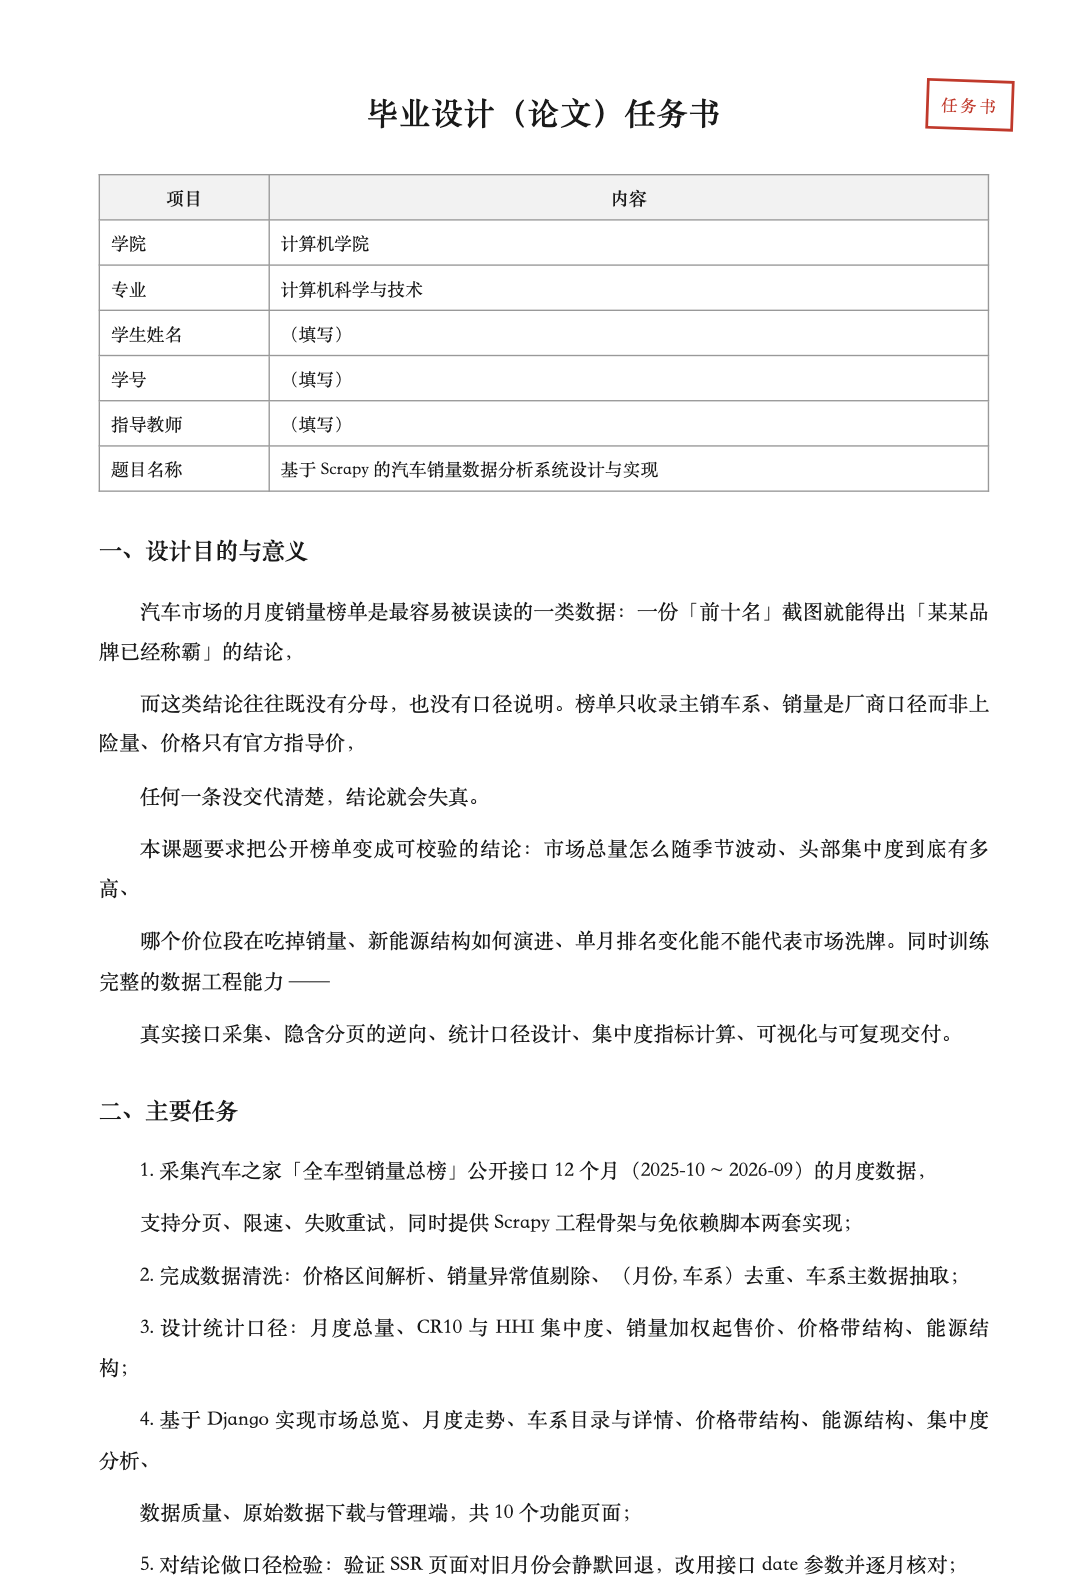
- 采集陷阱实测:榜单页为 Next.js 服务端渲染只输出首页 20 条,按 URL 后缀翻页 pageindex 恒为 1、反复返回同一批数据且不报错;改走页面自身调用的 getList 接口(pagesize 50)才拿到全量
- 旧月份静默回退:直接按页面 URL 请求 2026-04 之前月份,服务端会替换成最新月数据;改用接口 date 参数并逐月比对首条车系与销量,确认 12 个月互异
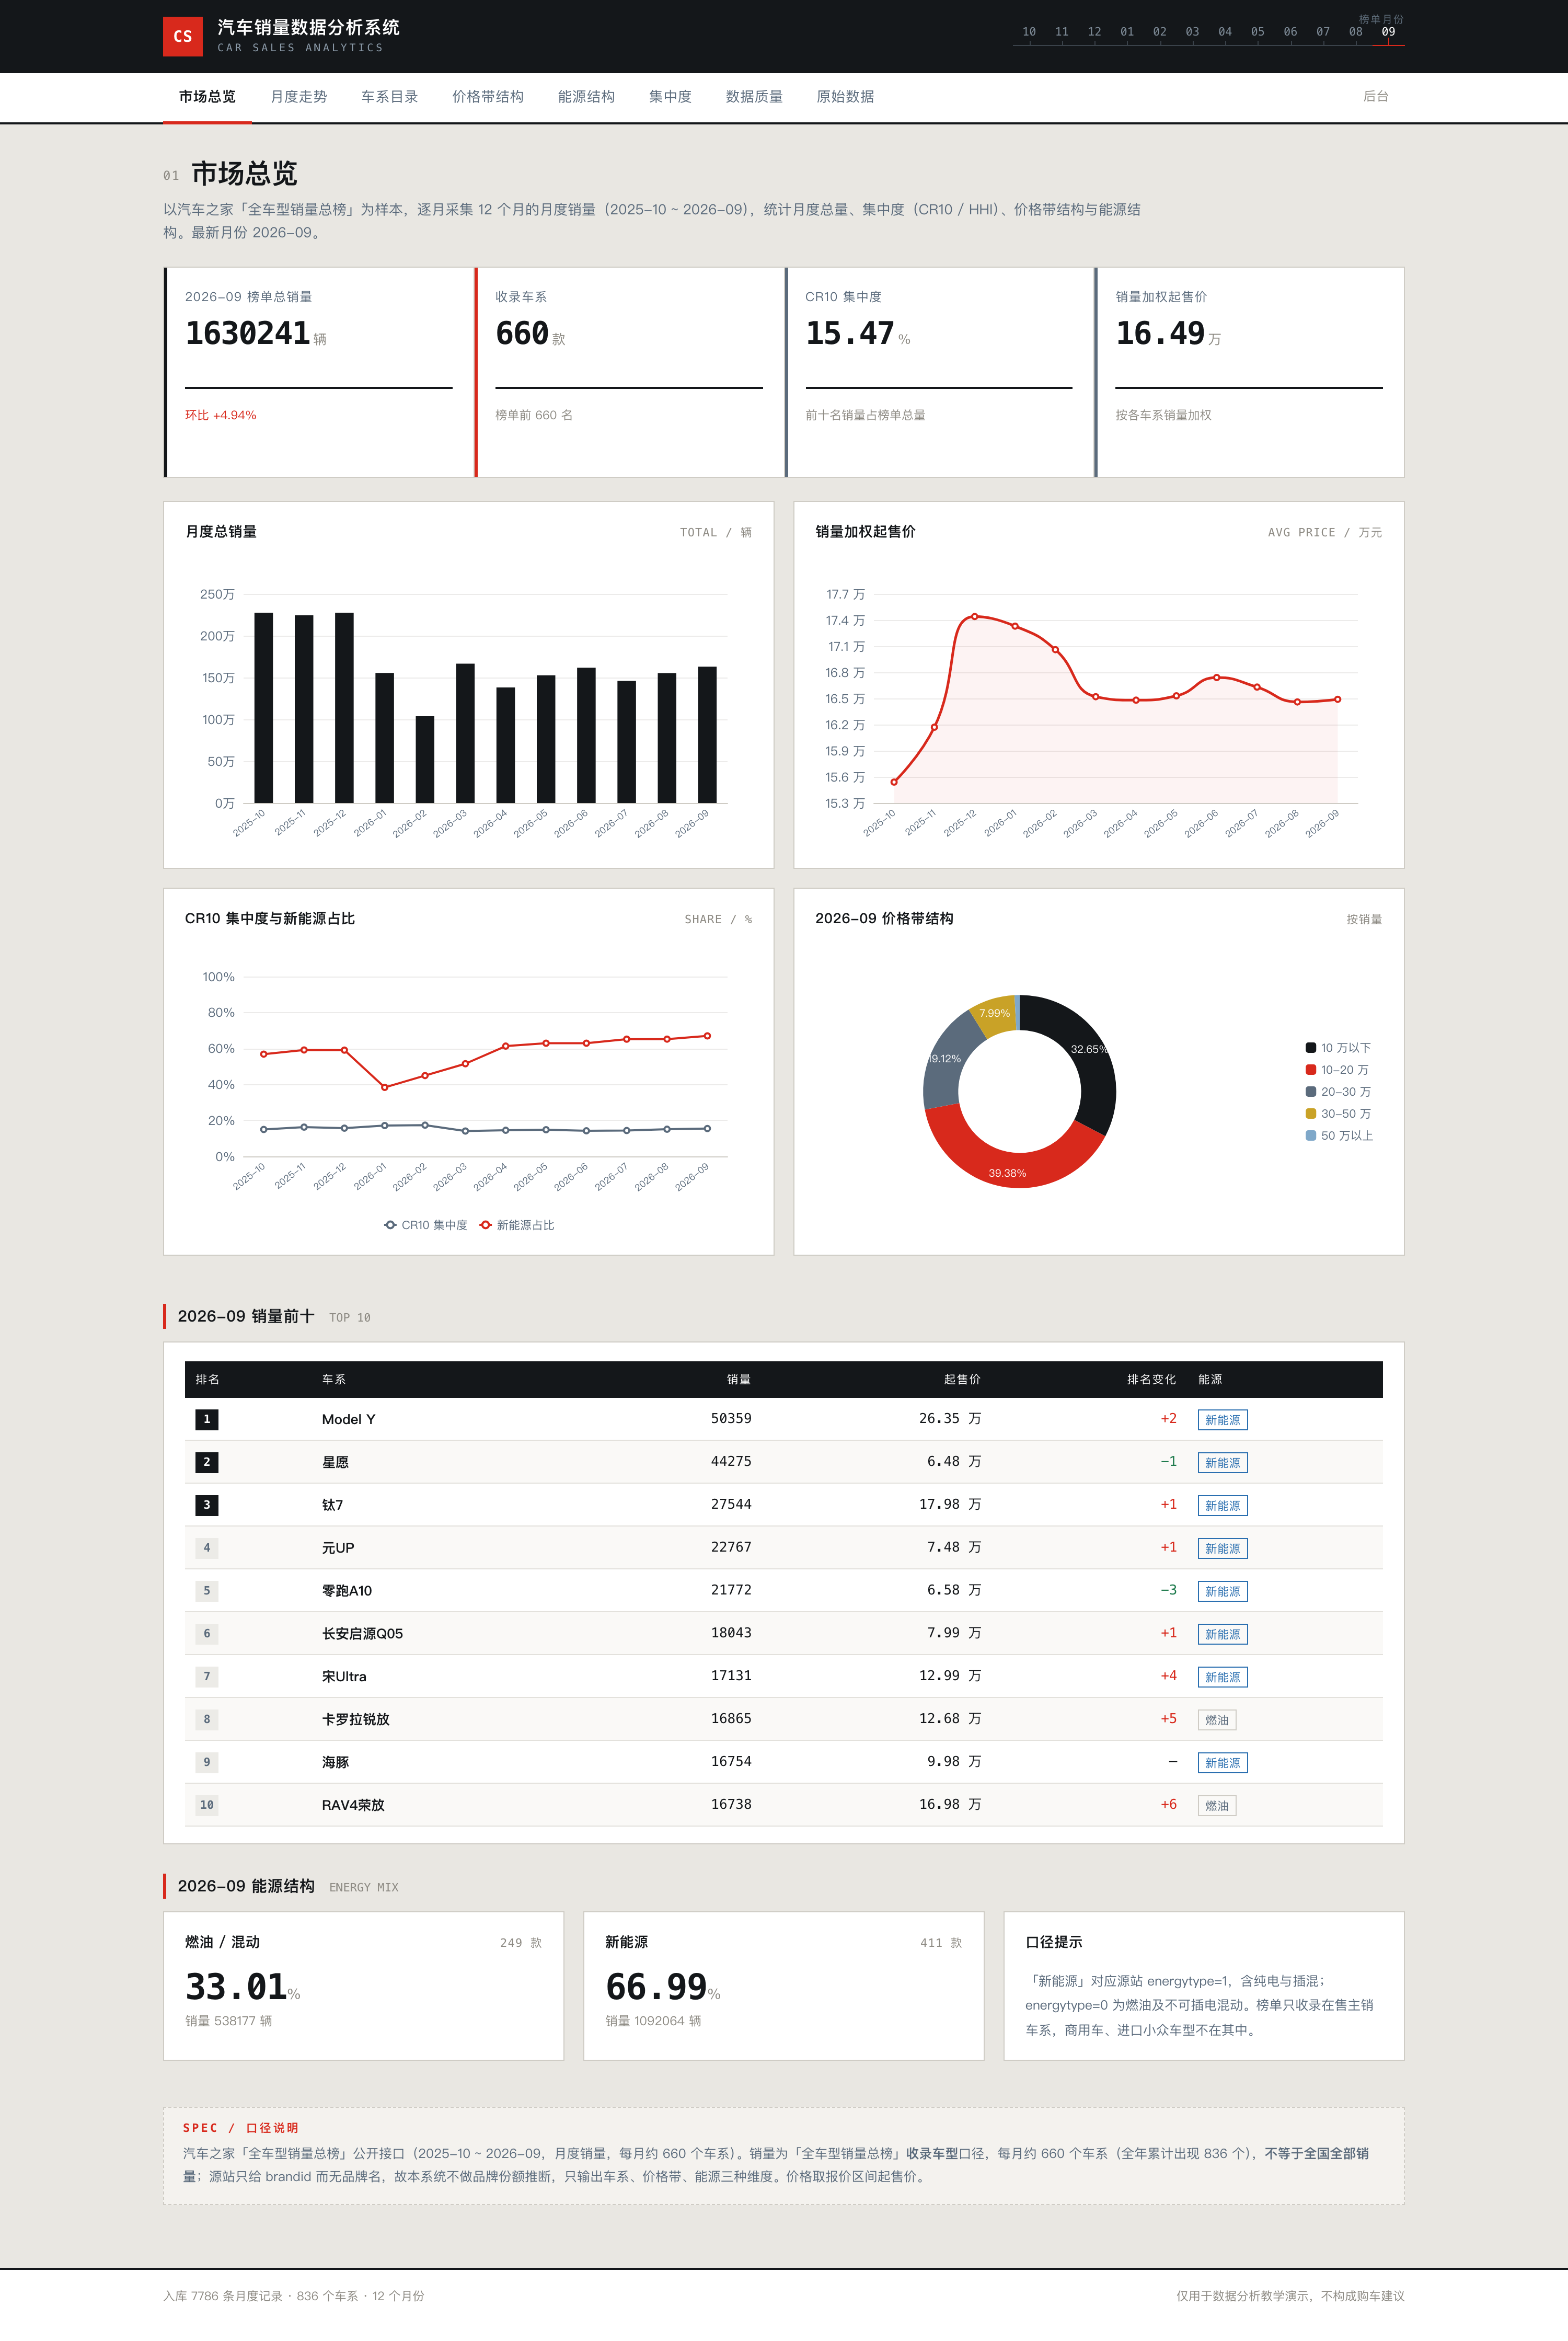
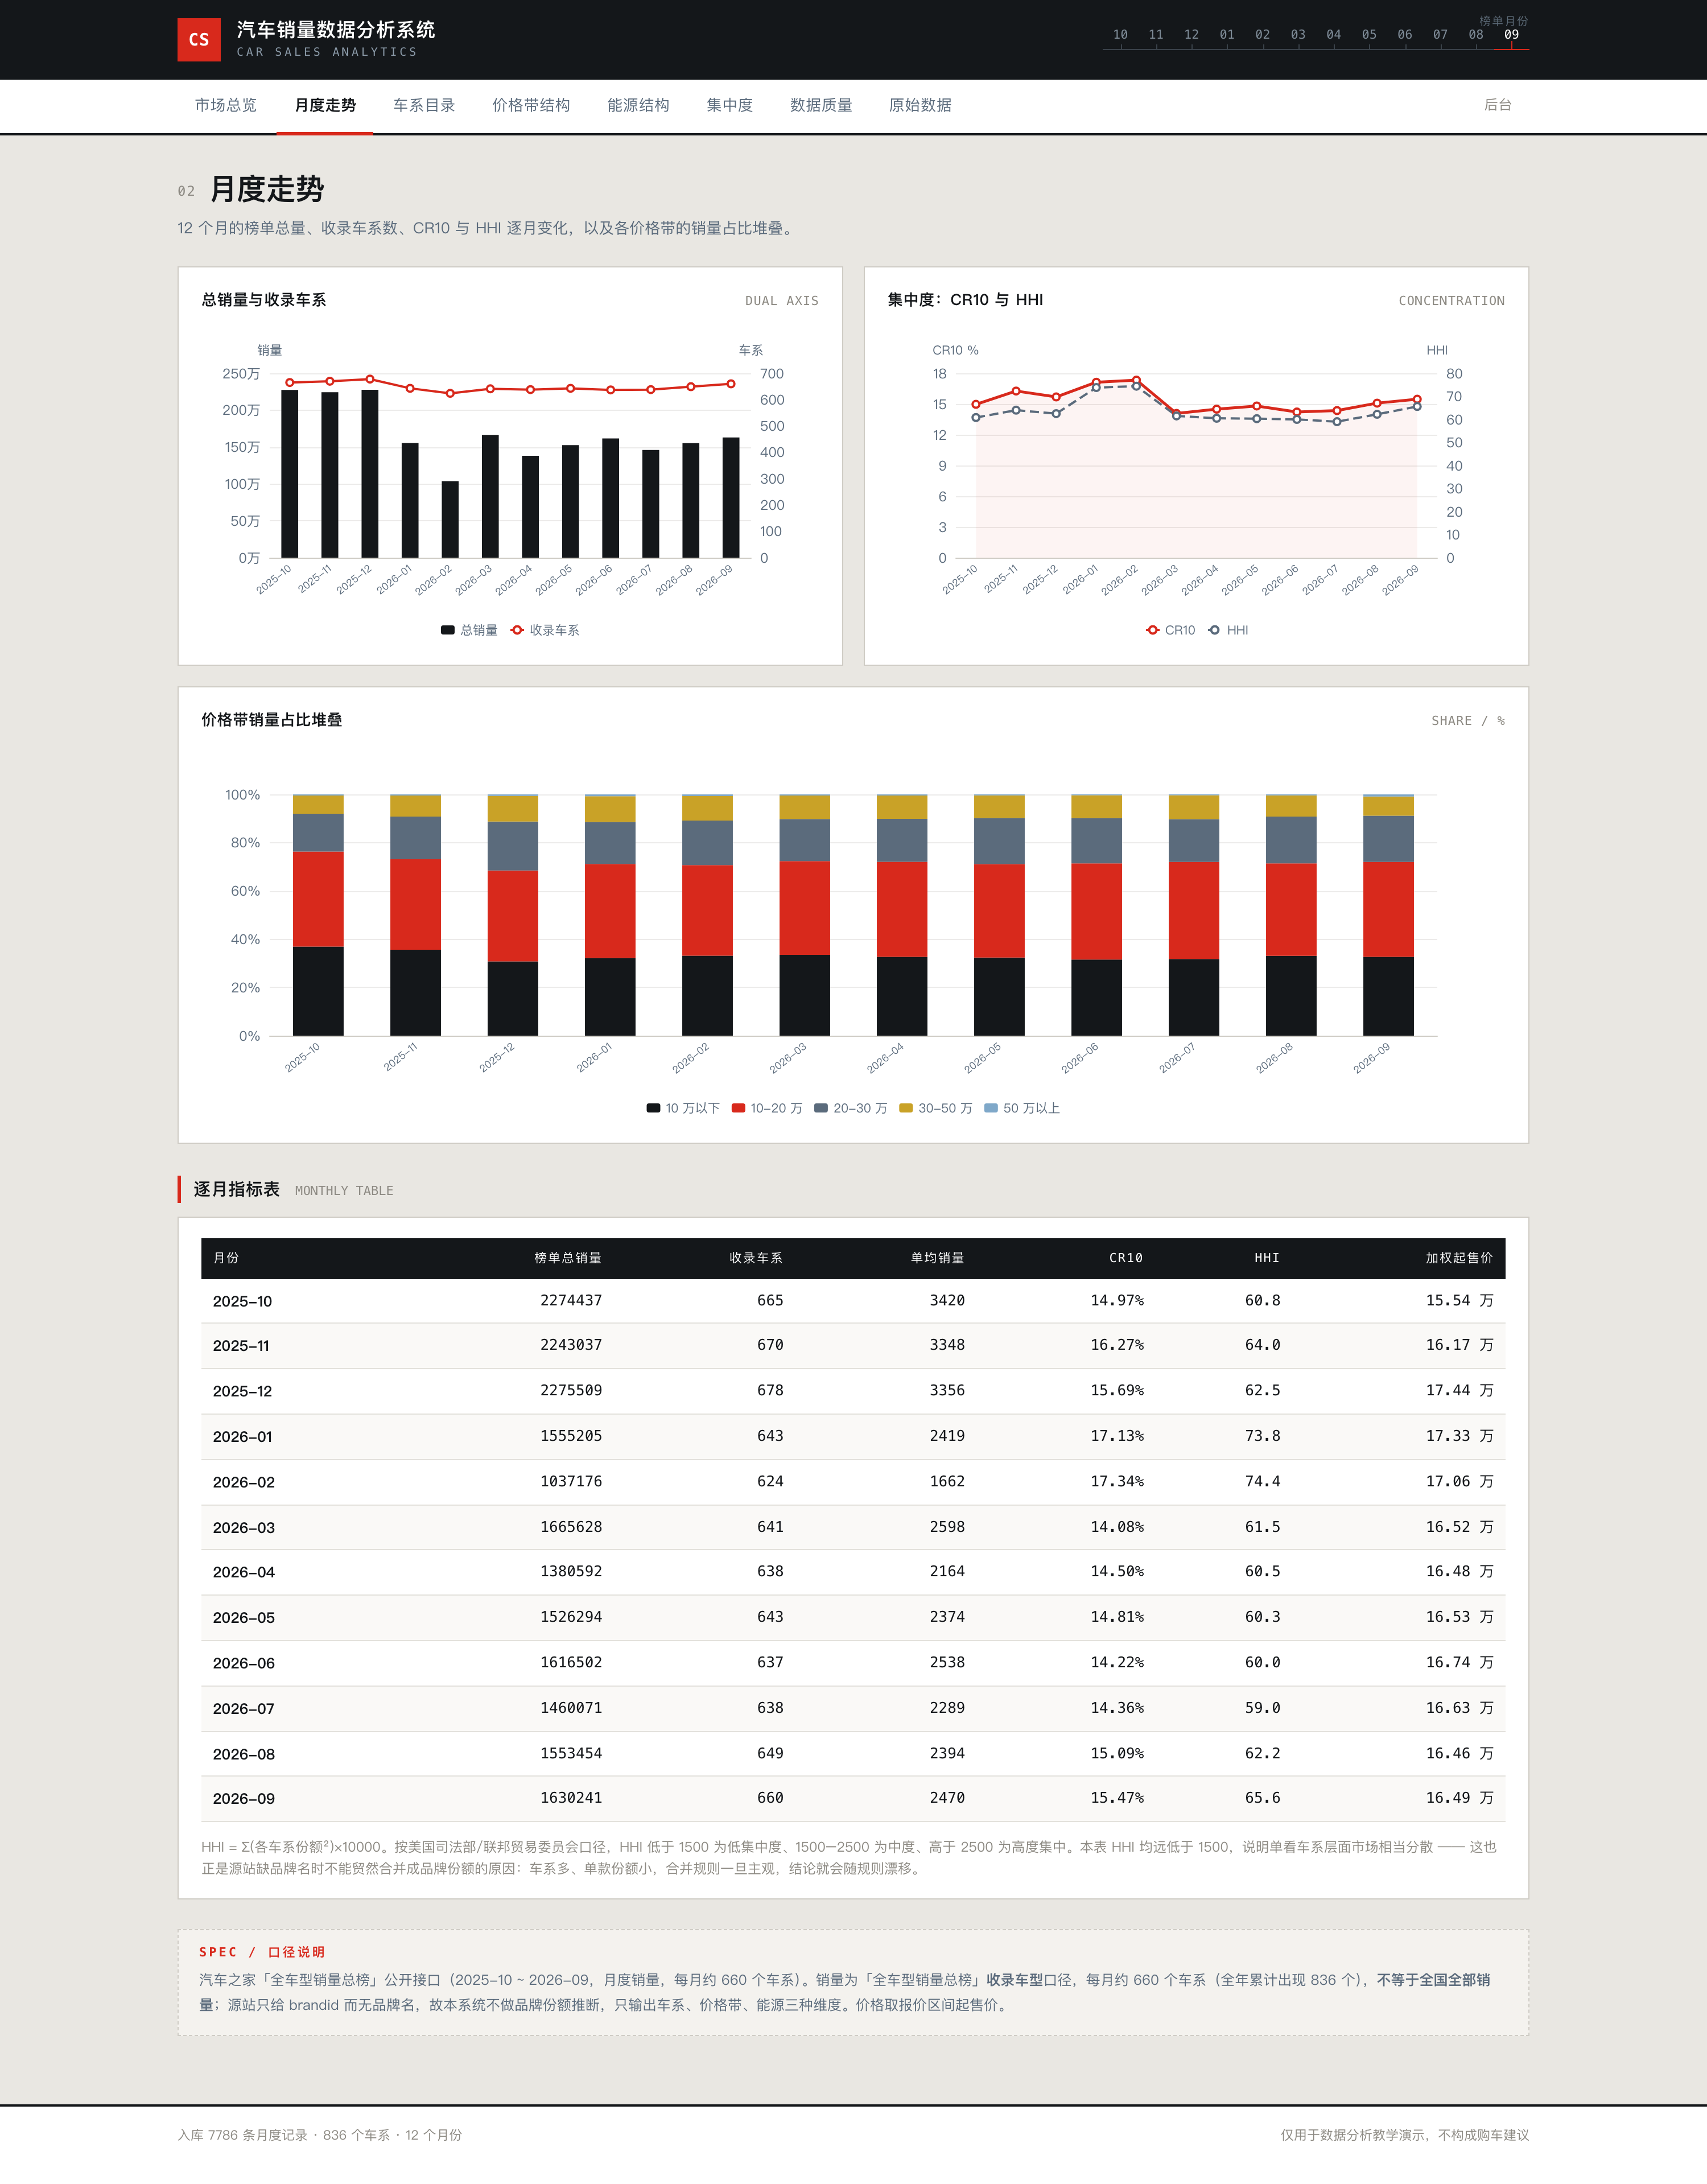
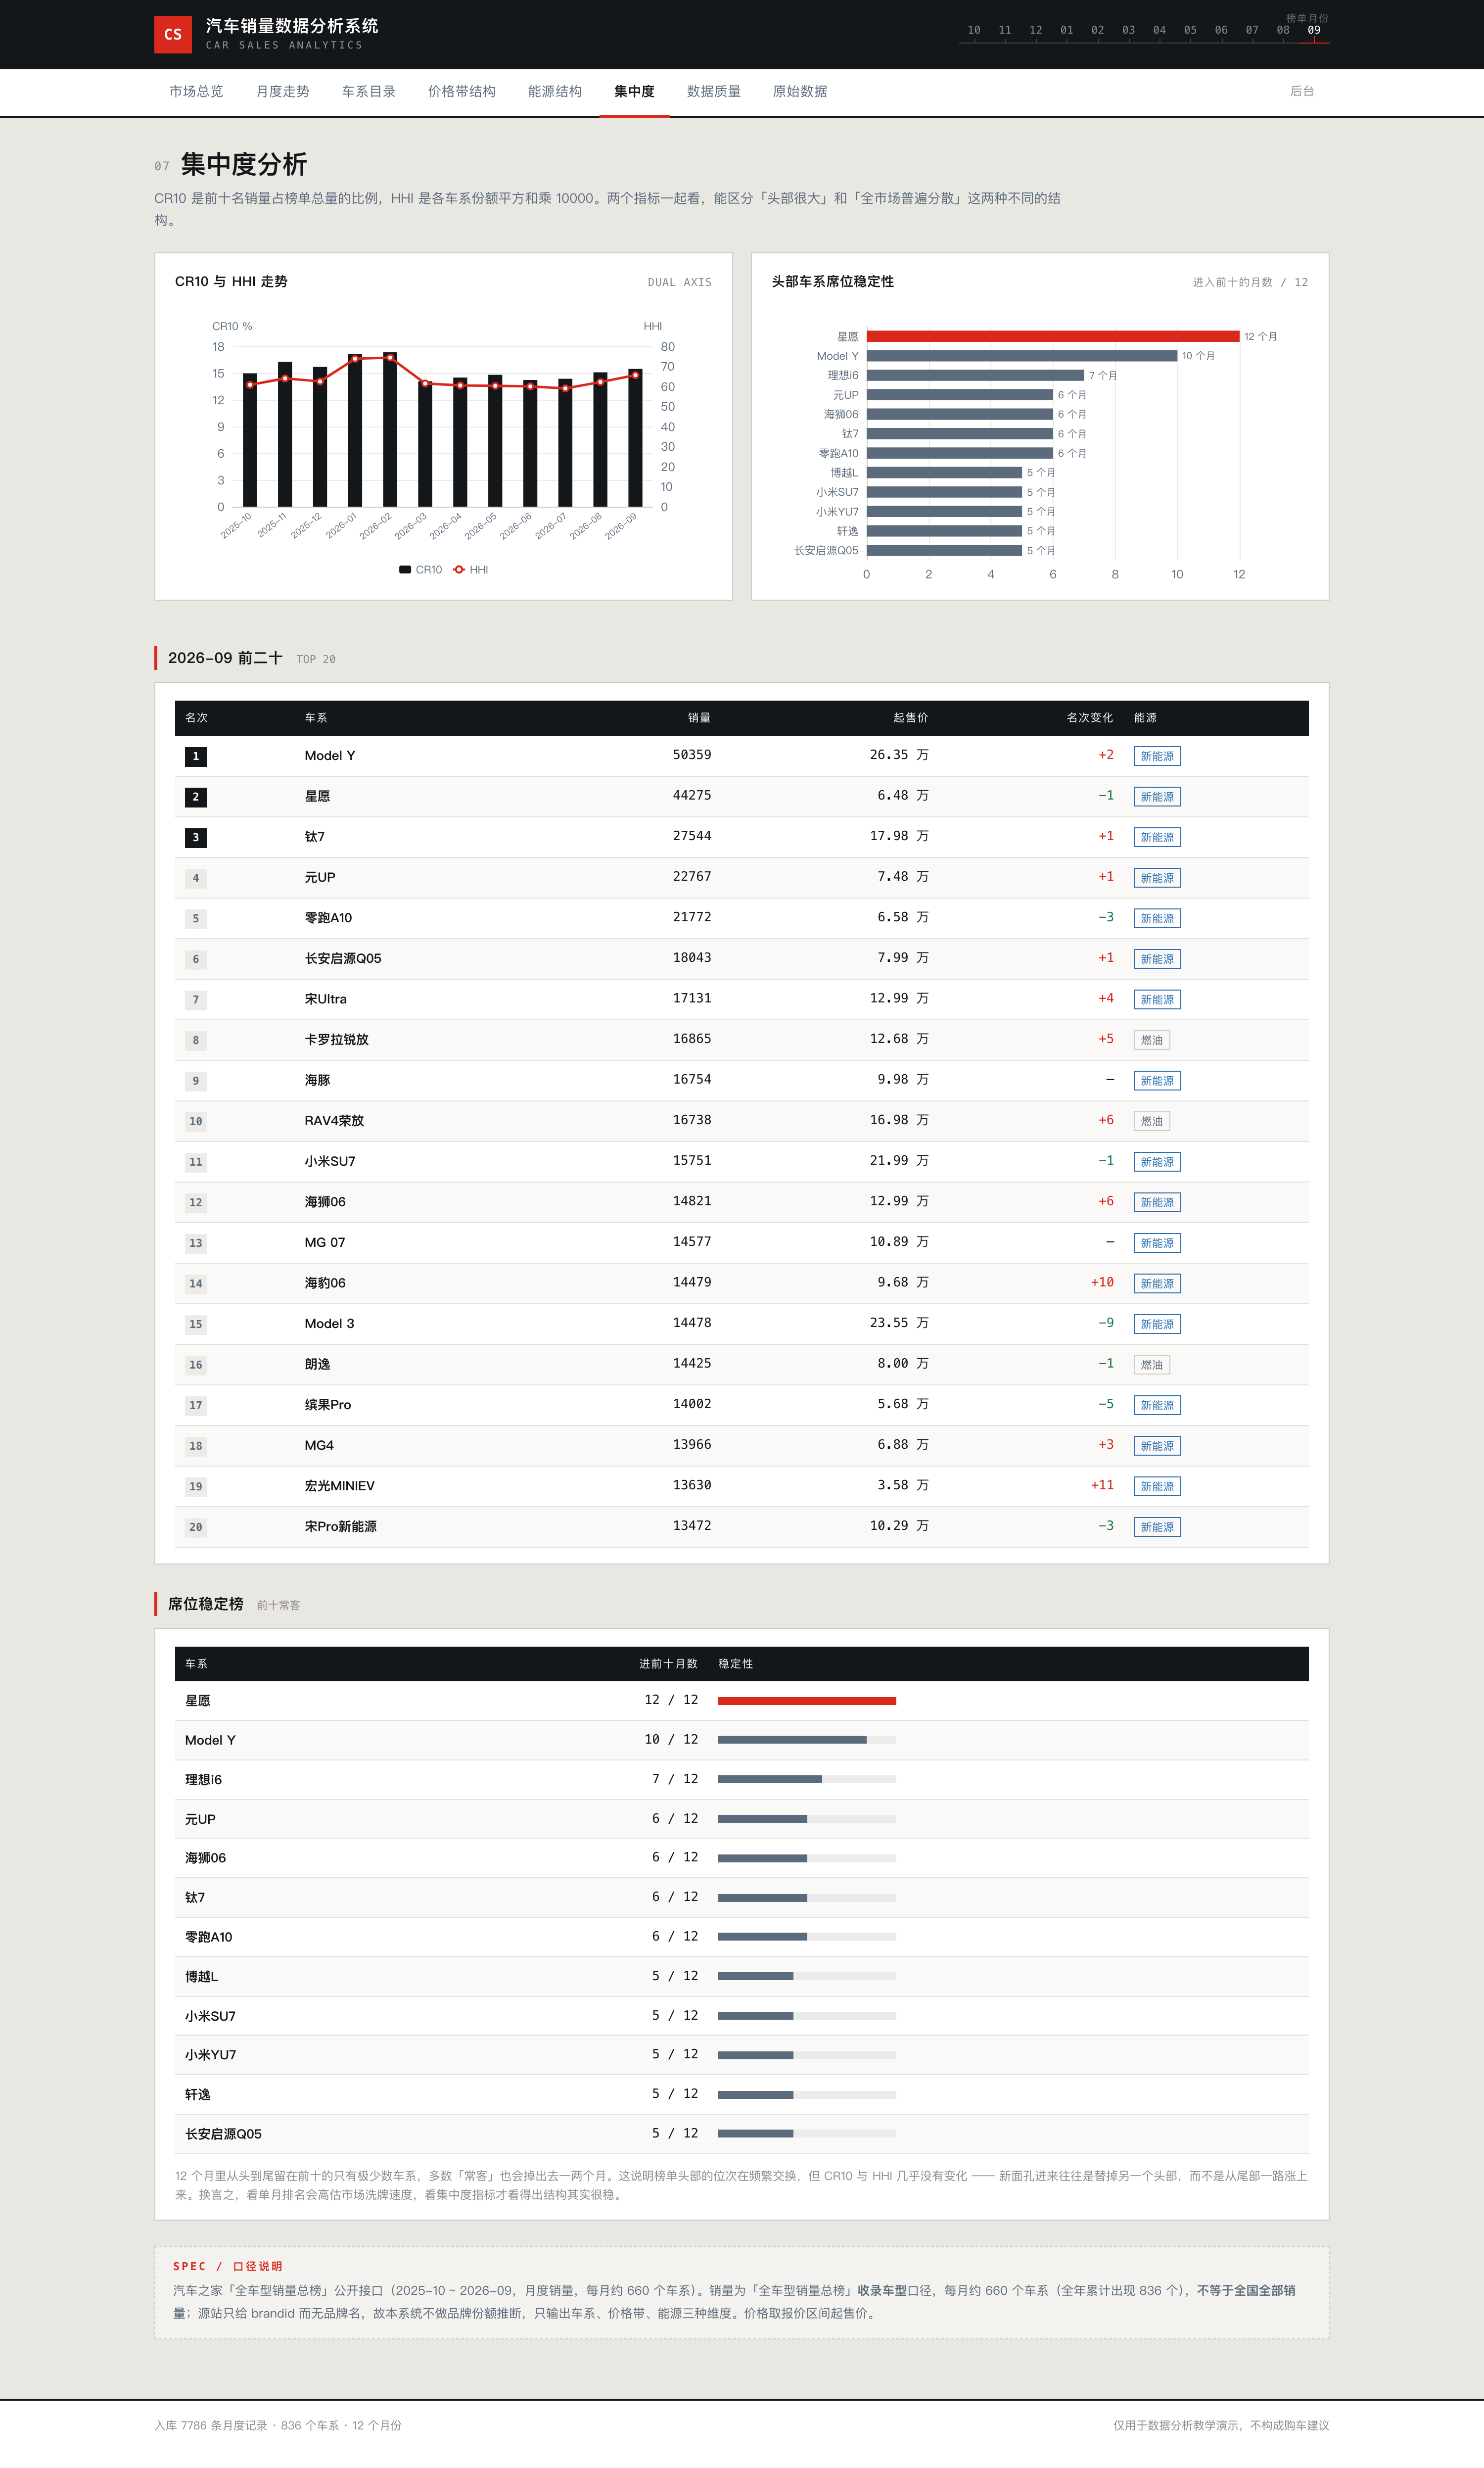
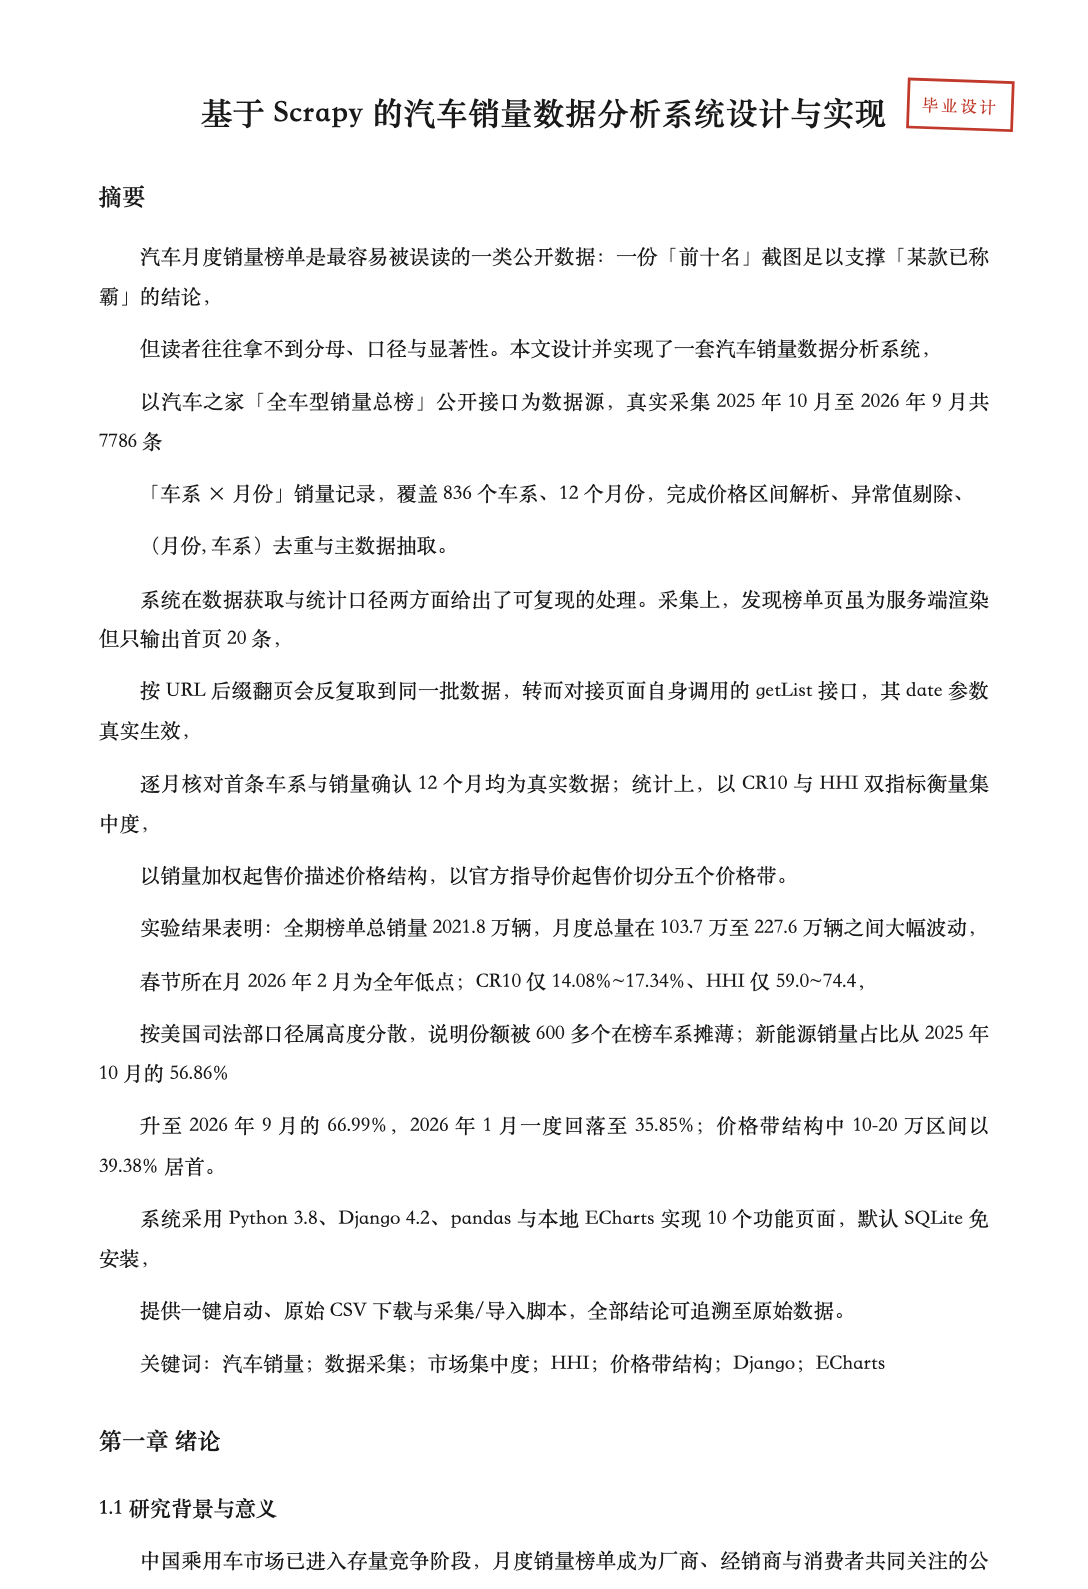
- 集中度双指标:CR10 仅 14.08%~17.34%、HHI 仅 59.0~74.4(美国司法部口径属高度分散),并指出 1—2 月集中度峰值来自「分母收缩」而非头部变强
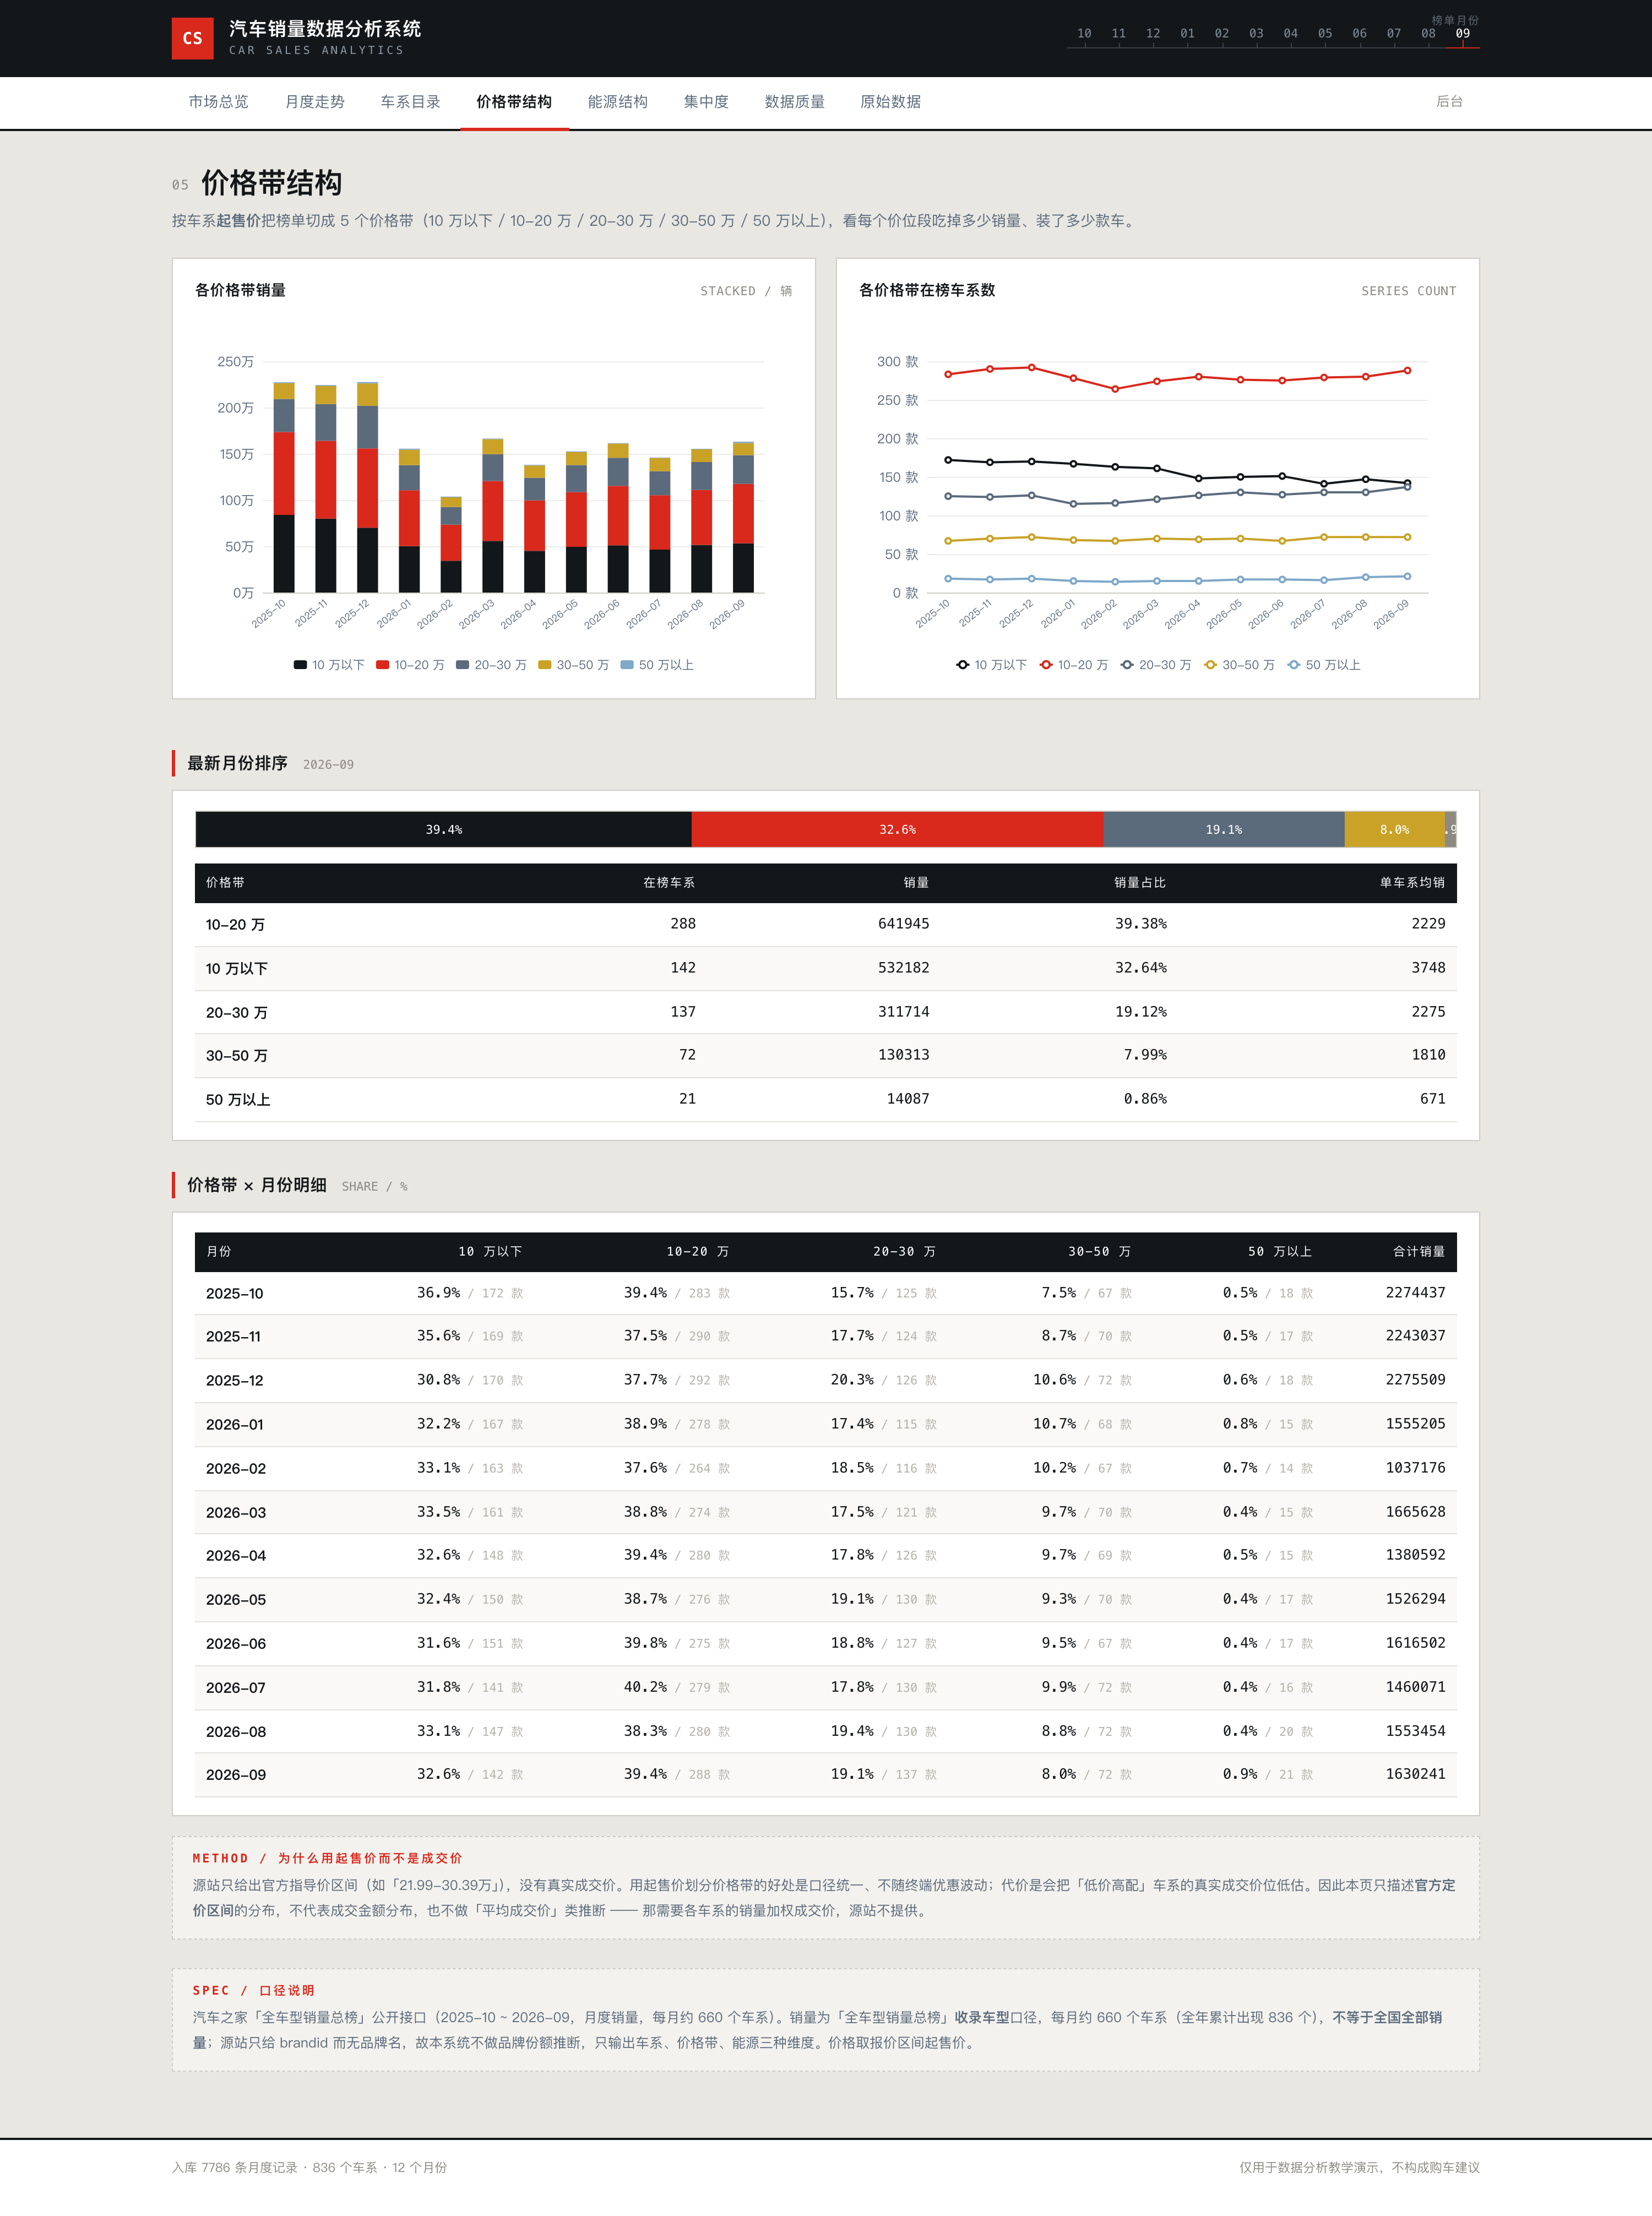
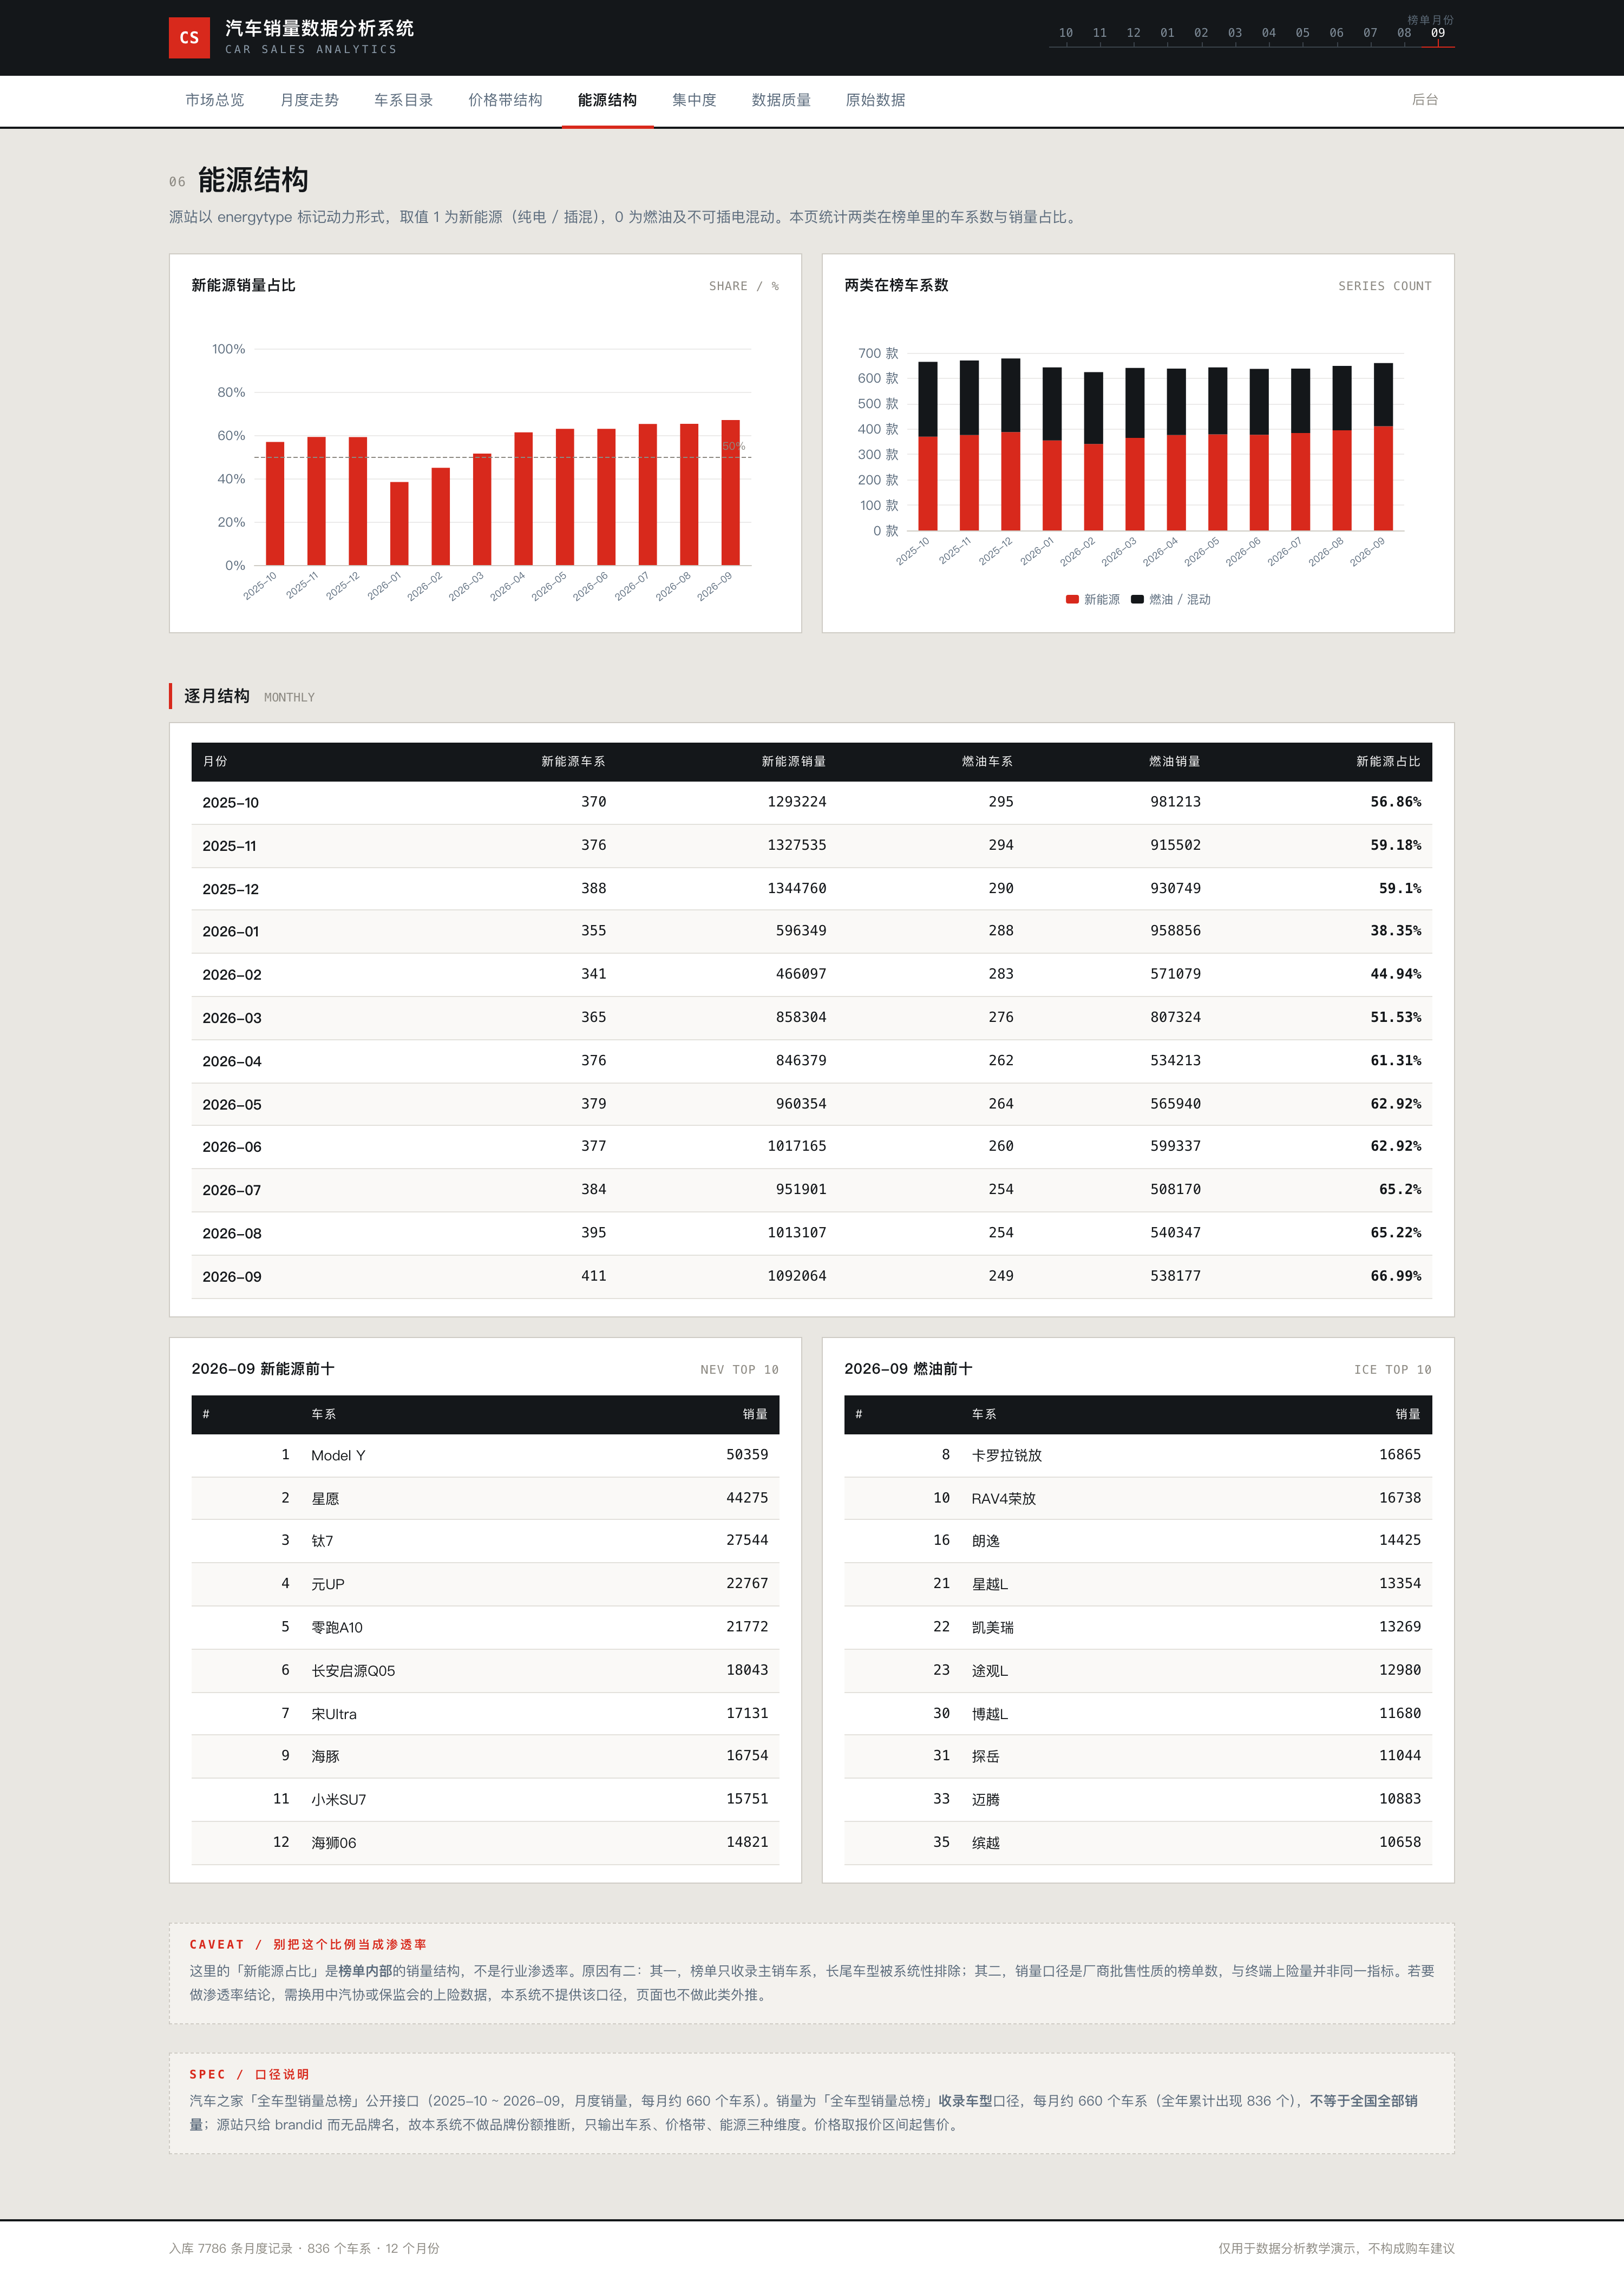
- 结构性结论:新能源销量占比 56.86% → 66.99%(1 月回落至 35.85%);2026-09 价格带 10-20 万占 39.38% 居首,10 万以下仅 142 款车却贡献 32.64% 销量、单车系均销 3748 辆最高
- 主动放弃品牌维度:源站只有 brandid、无品牌名,强行合并会让结论随规则漂移,因此只做车系 / 价格带 / 能源三个可自查维度,论文第 6.4 节写明取舍理由
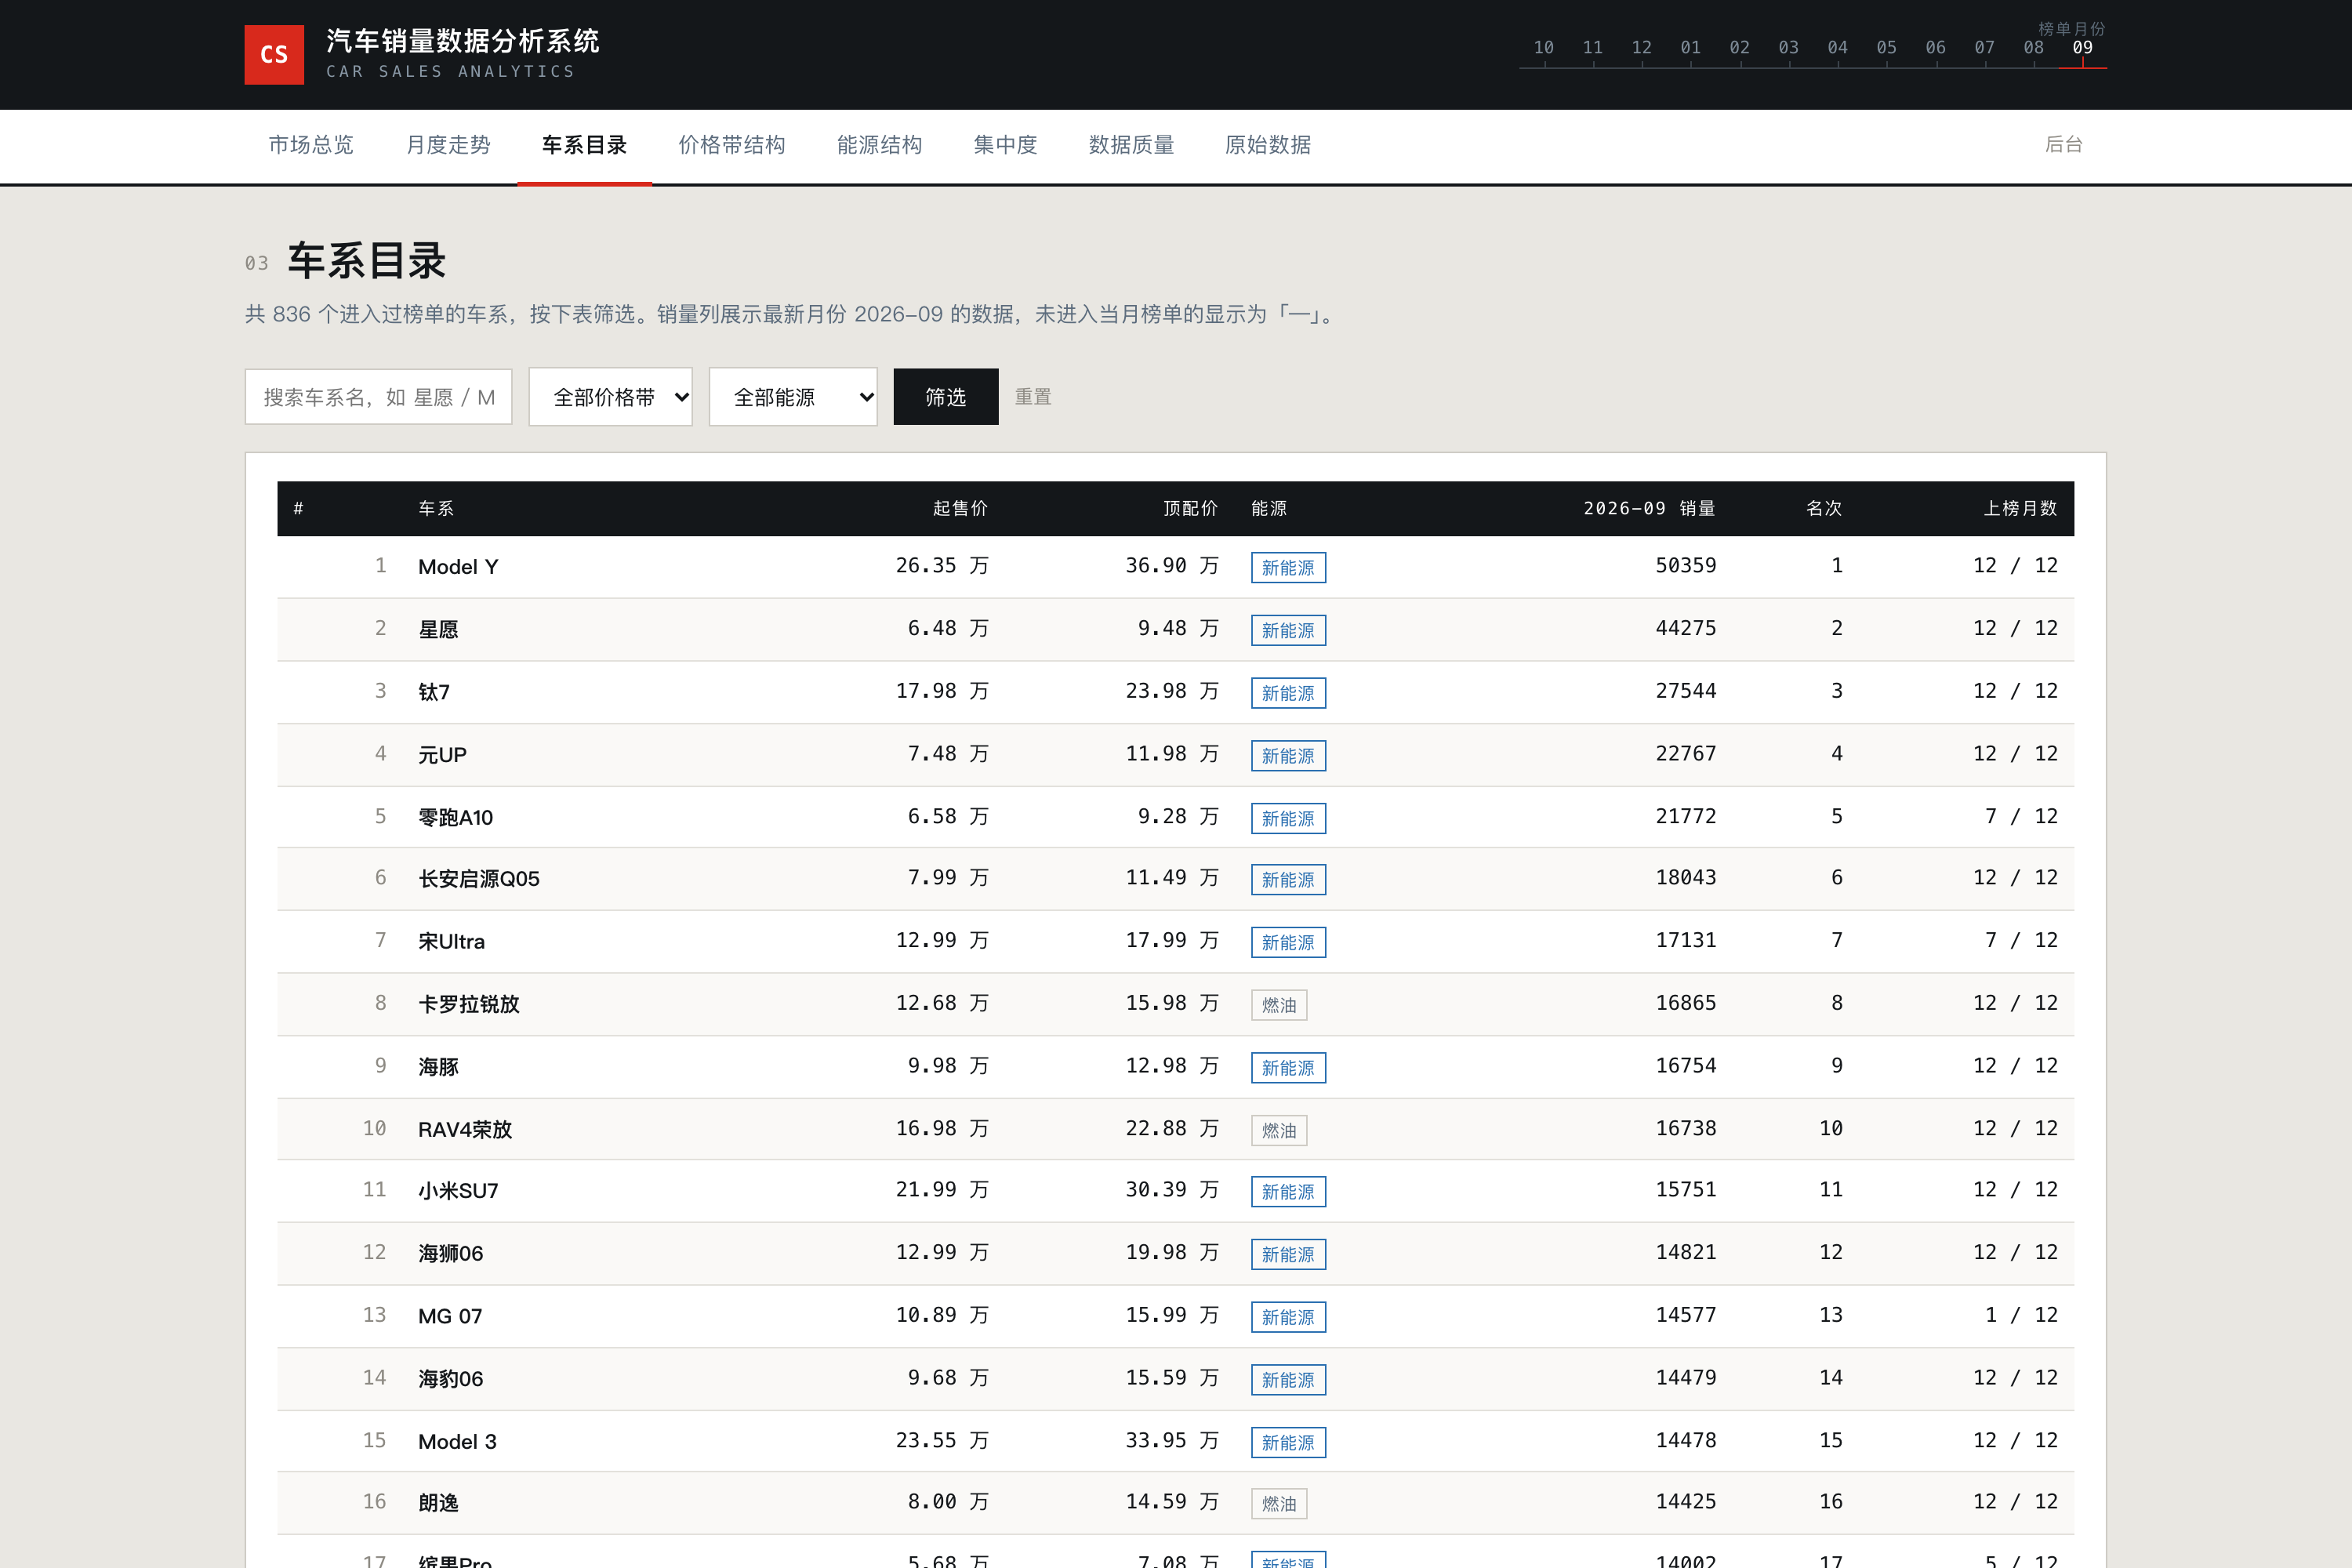
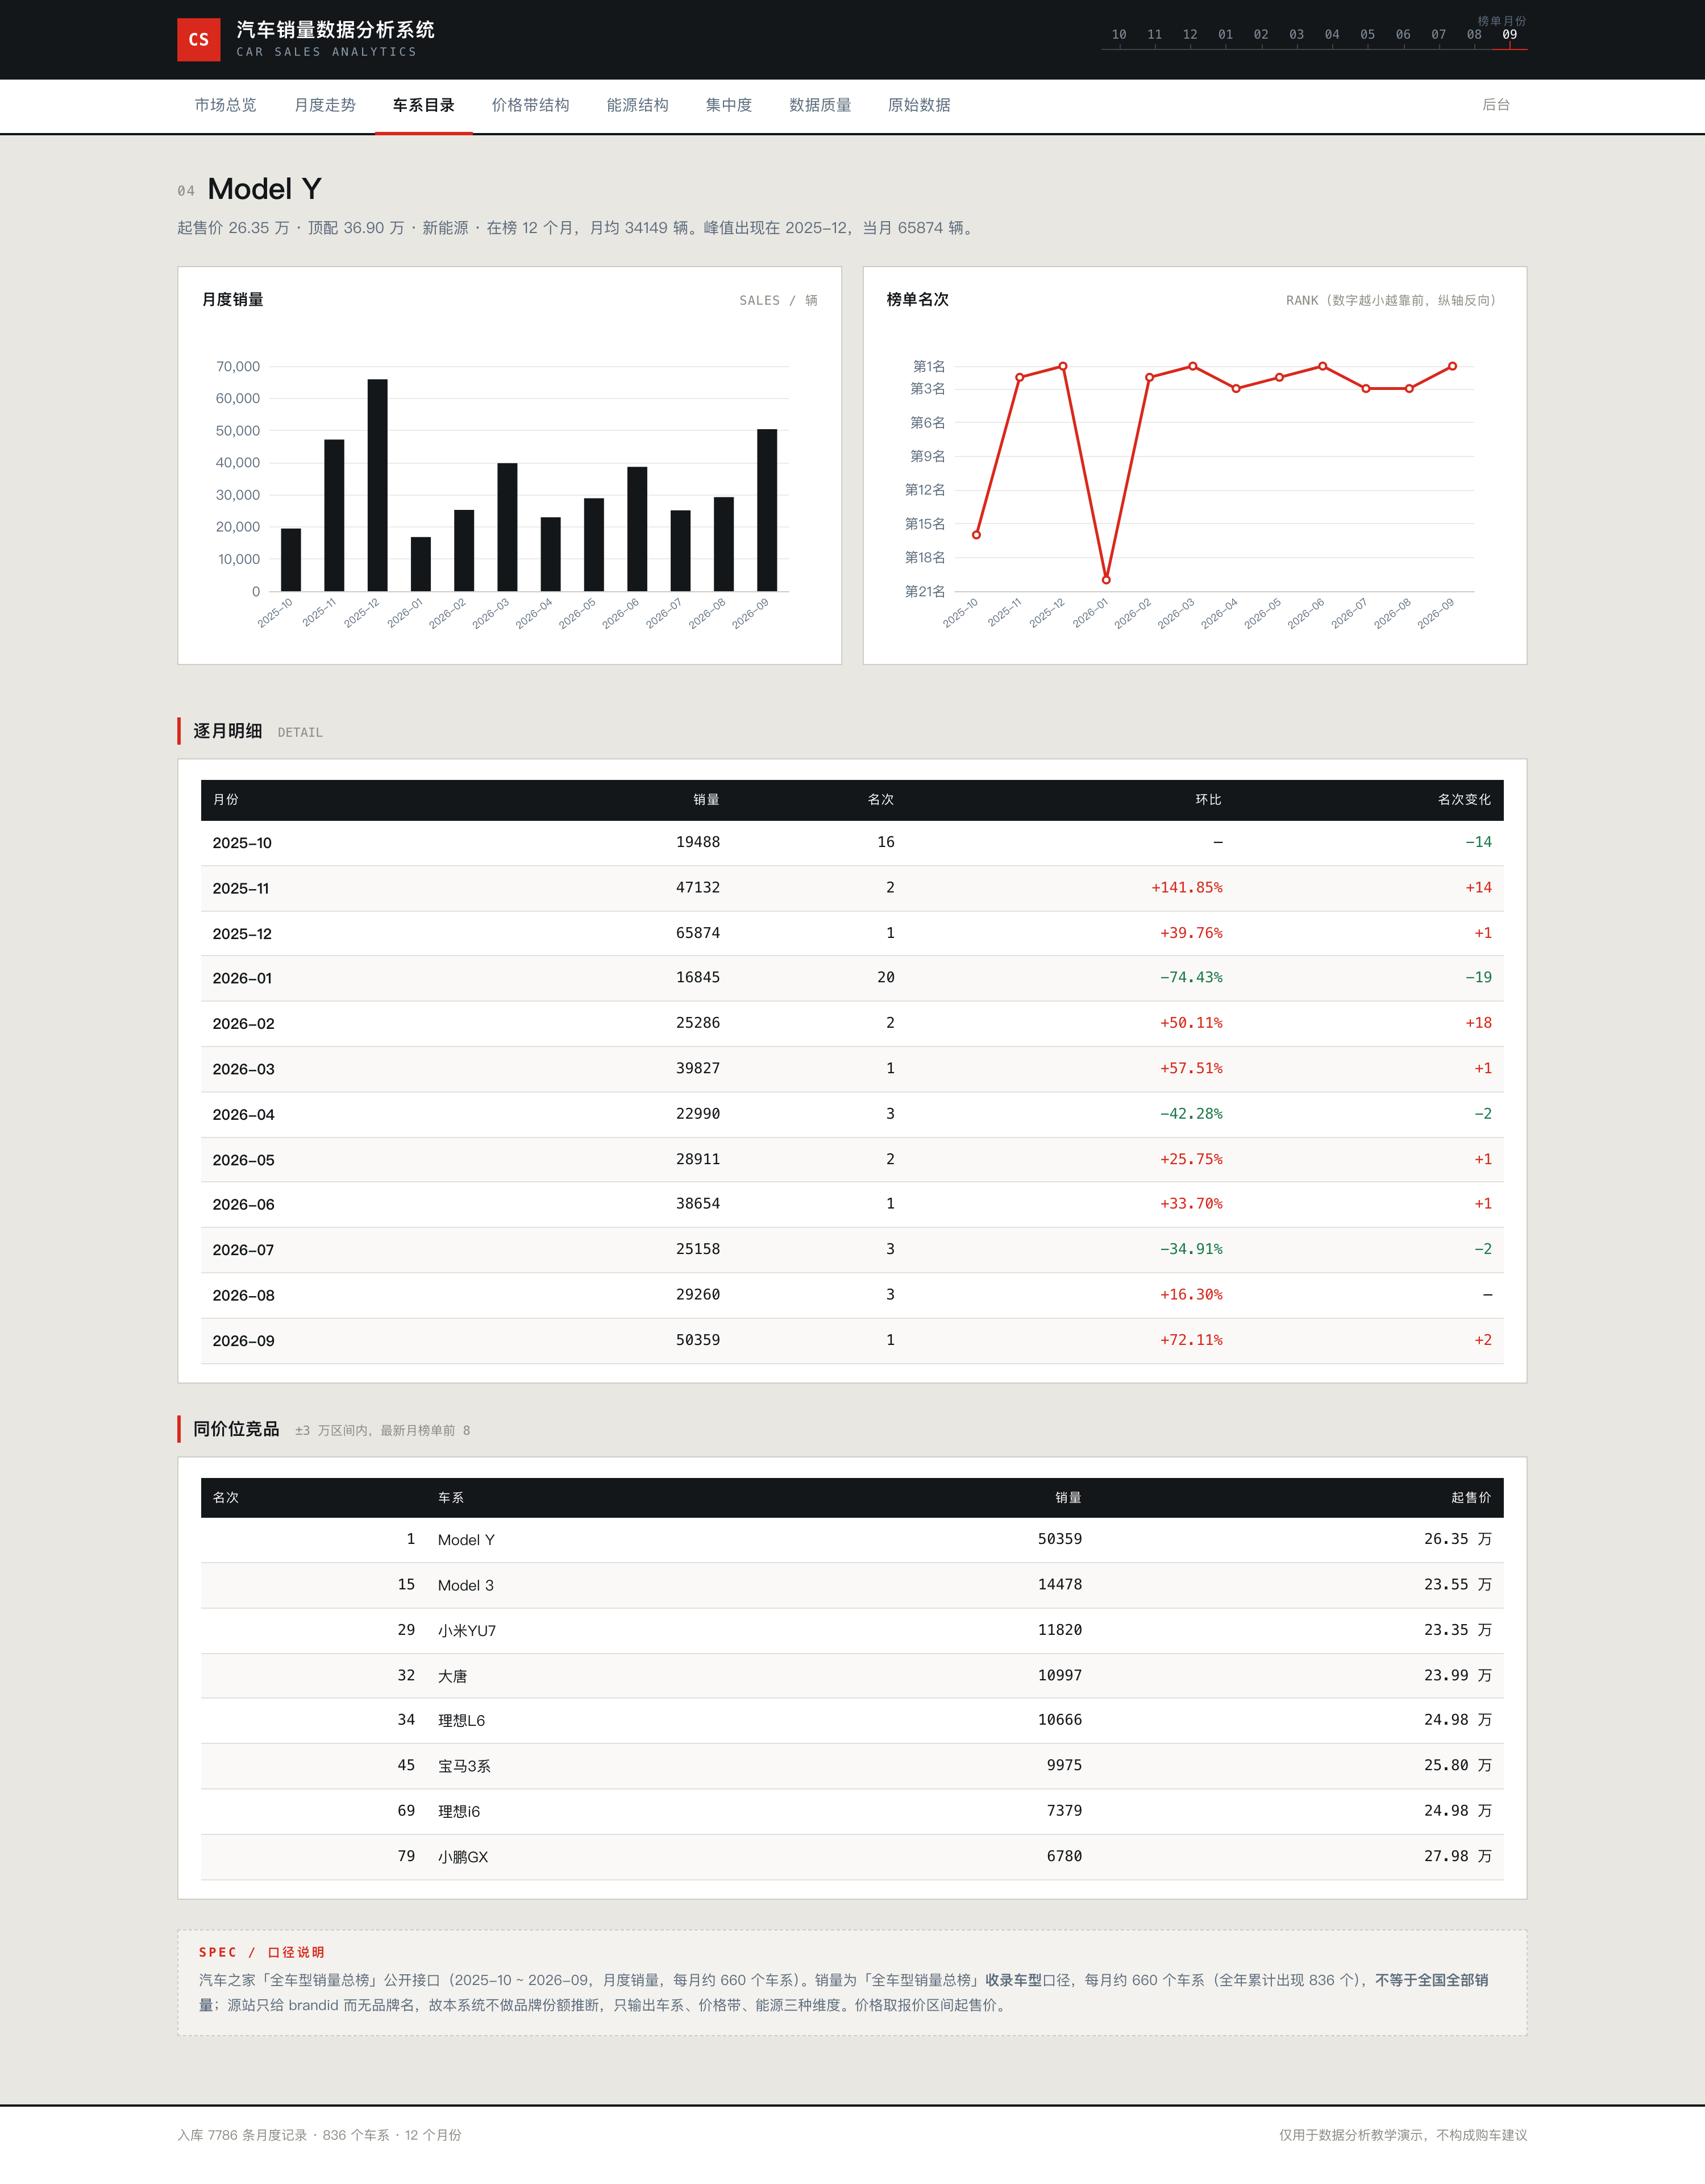
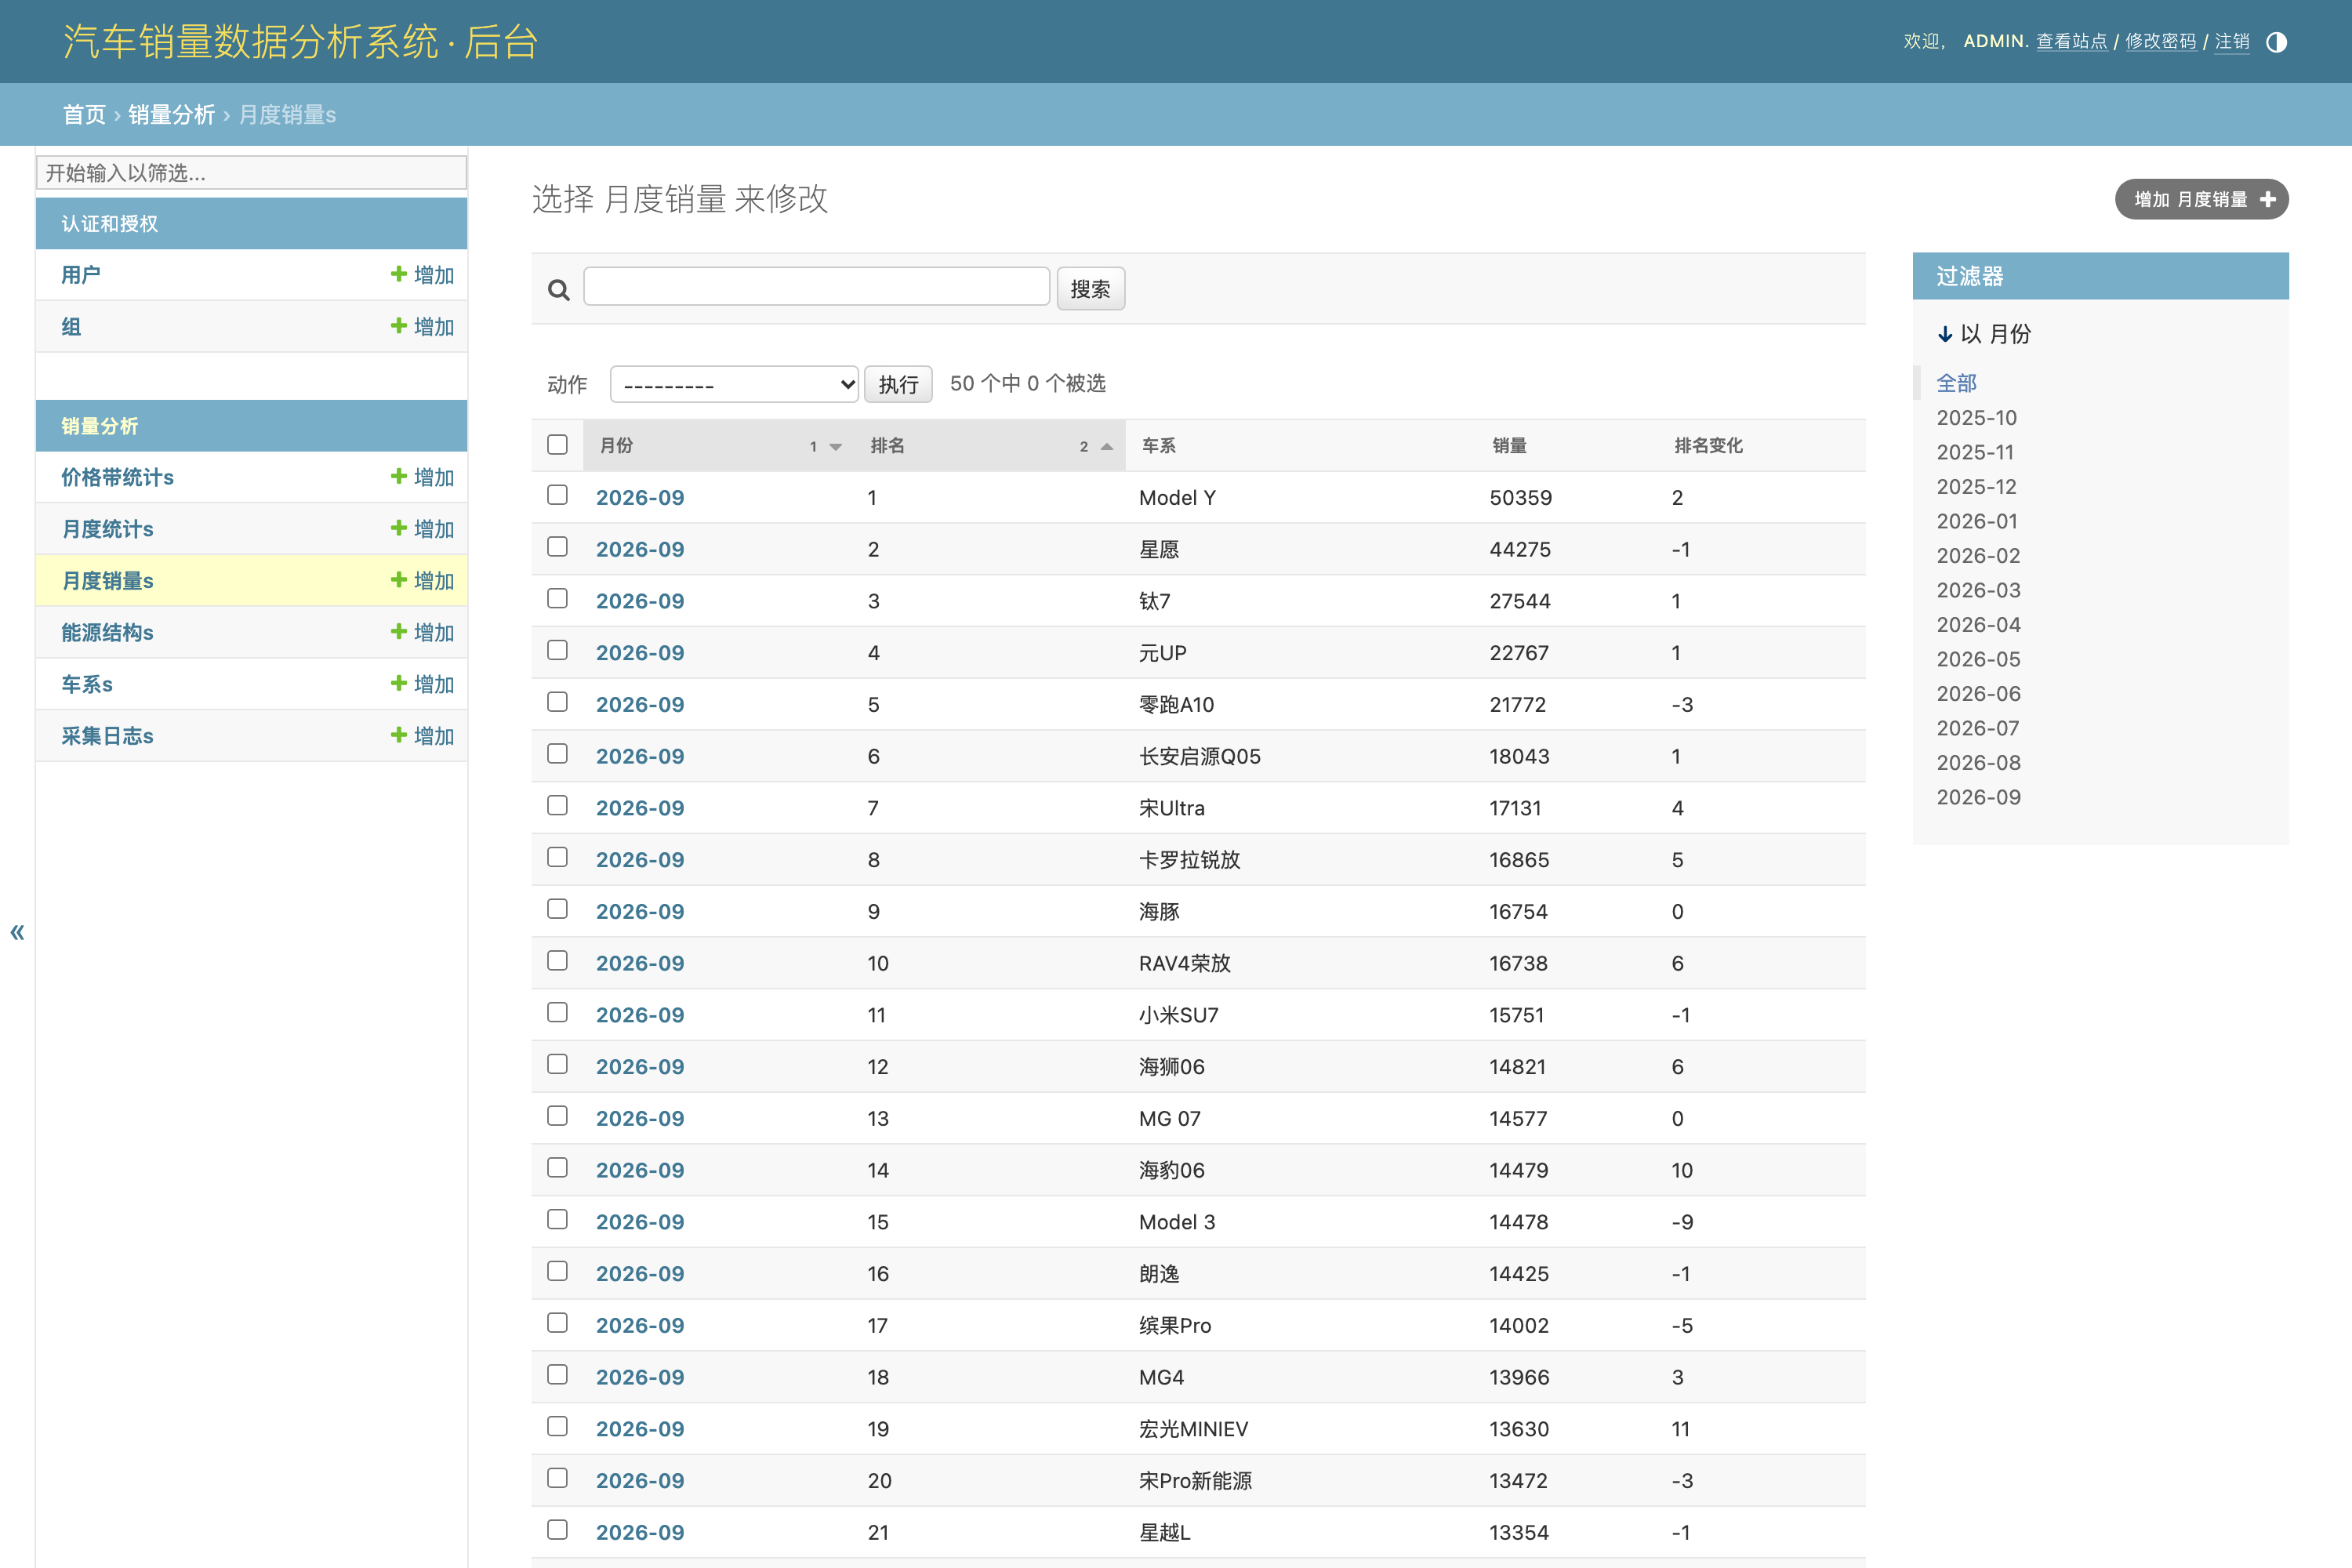
- 10 个功能页面:市场总览 / 月度走势 / 车系目录与详情 / 价格带 / 能源 / 集中度 / 数据质量 / 原始数据 / 管理端,ECharts 本地内置离线可用
- 论文实验可复现:全部数字来自 data/analysis/findings.json,重跑 import_sales 自动更新;采集同时提供 Scrapy 工程与免依赖脚本,同月输出条数一致(660 条)
运行环境
- 编程语言:Python 3.8 及以上
- 后端框架:Django 4.2
- 数据采集:requests 真实 HTTP 采集 + Scrapy 2.x 工程骨架(公开接口,低频 + 重试 + 去重)
- 数据分析:pandas 2.0 / NumPy 1.23
- 数据库:MySQL 8.0(交付默认 SQLite,免安装)
- 可视化:ECharts 5(已内置本地文件,离线可用)
- 数据规模:7786 条月度销量 / 836 个车系 / 12 个月份
- 操作系统:Windows / macOS / Linux
- 启动方式:双击一键脚本,或 python manage.py runserver 8086
界面截图
文档预览
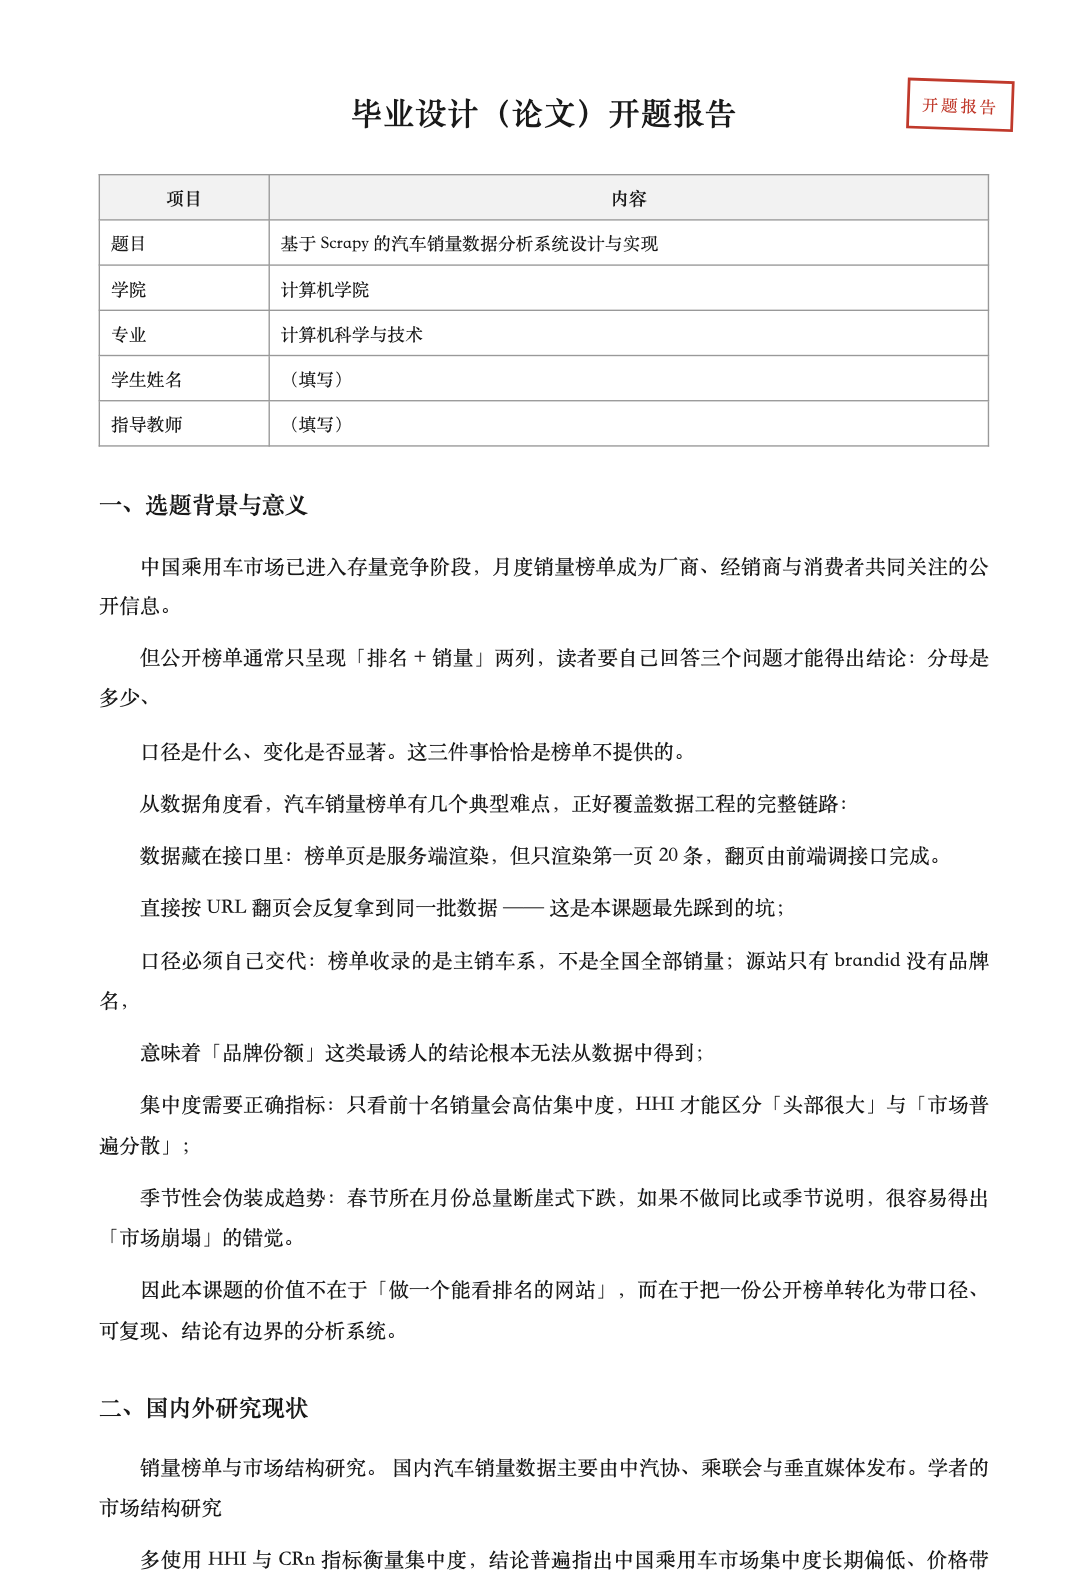
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览:
交付内容
- 完整源码(Django 工程 + Scrapy 蜘蛛 + 免依赖采集脚本 + 统计导入命令)
- 12 个月原始销量 CSV(真实数据)与演示数据库、findings.json 统计摘要
- 毕业设计任务书(Word)
- 毕业设计开题报告(Word)
- 毕业论文(Word,七章制,含采集口径验证、集中度双指标与结构分析)
- 系统使用与二次开发说明(Word + md)
- 系统运行截图 10 张 + 功能演示视频