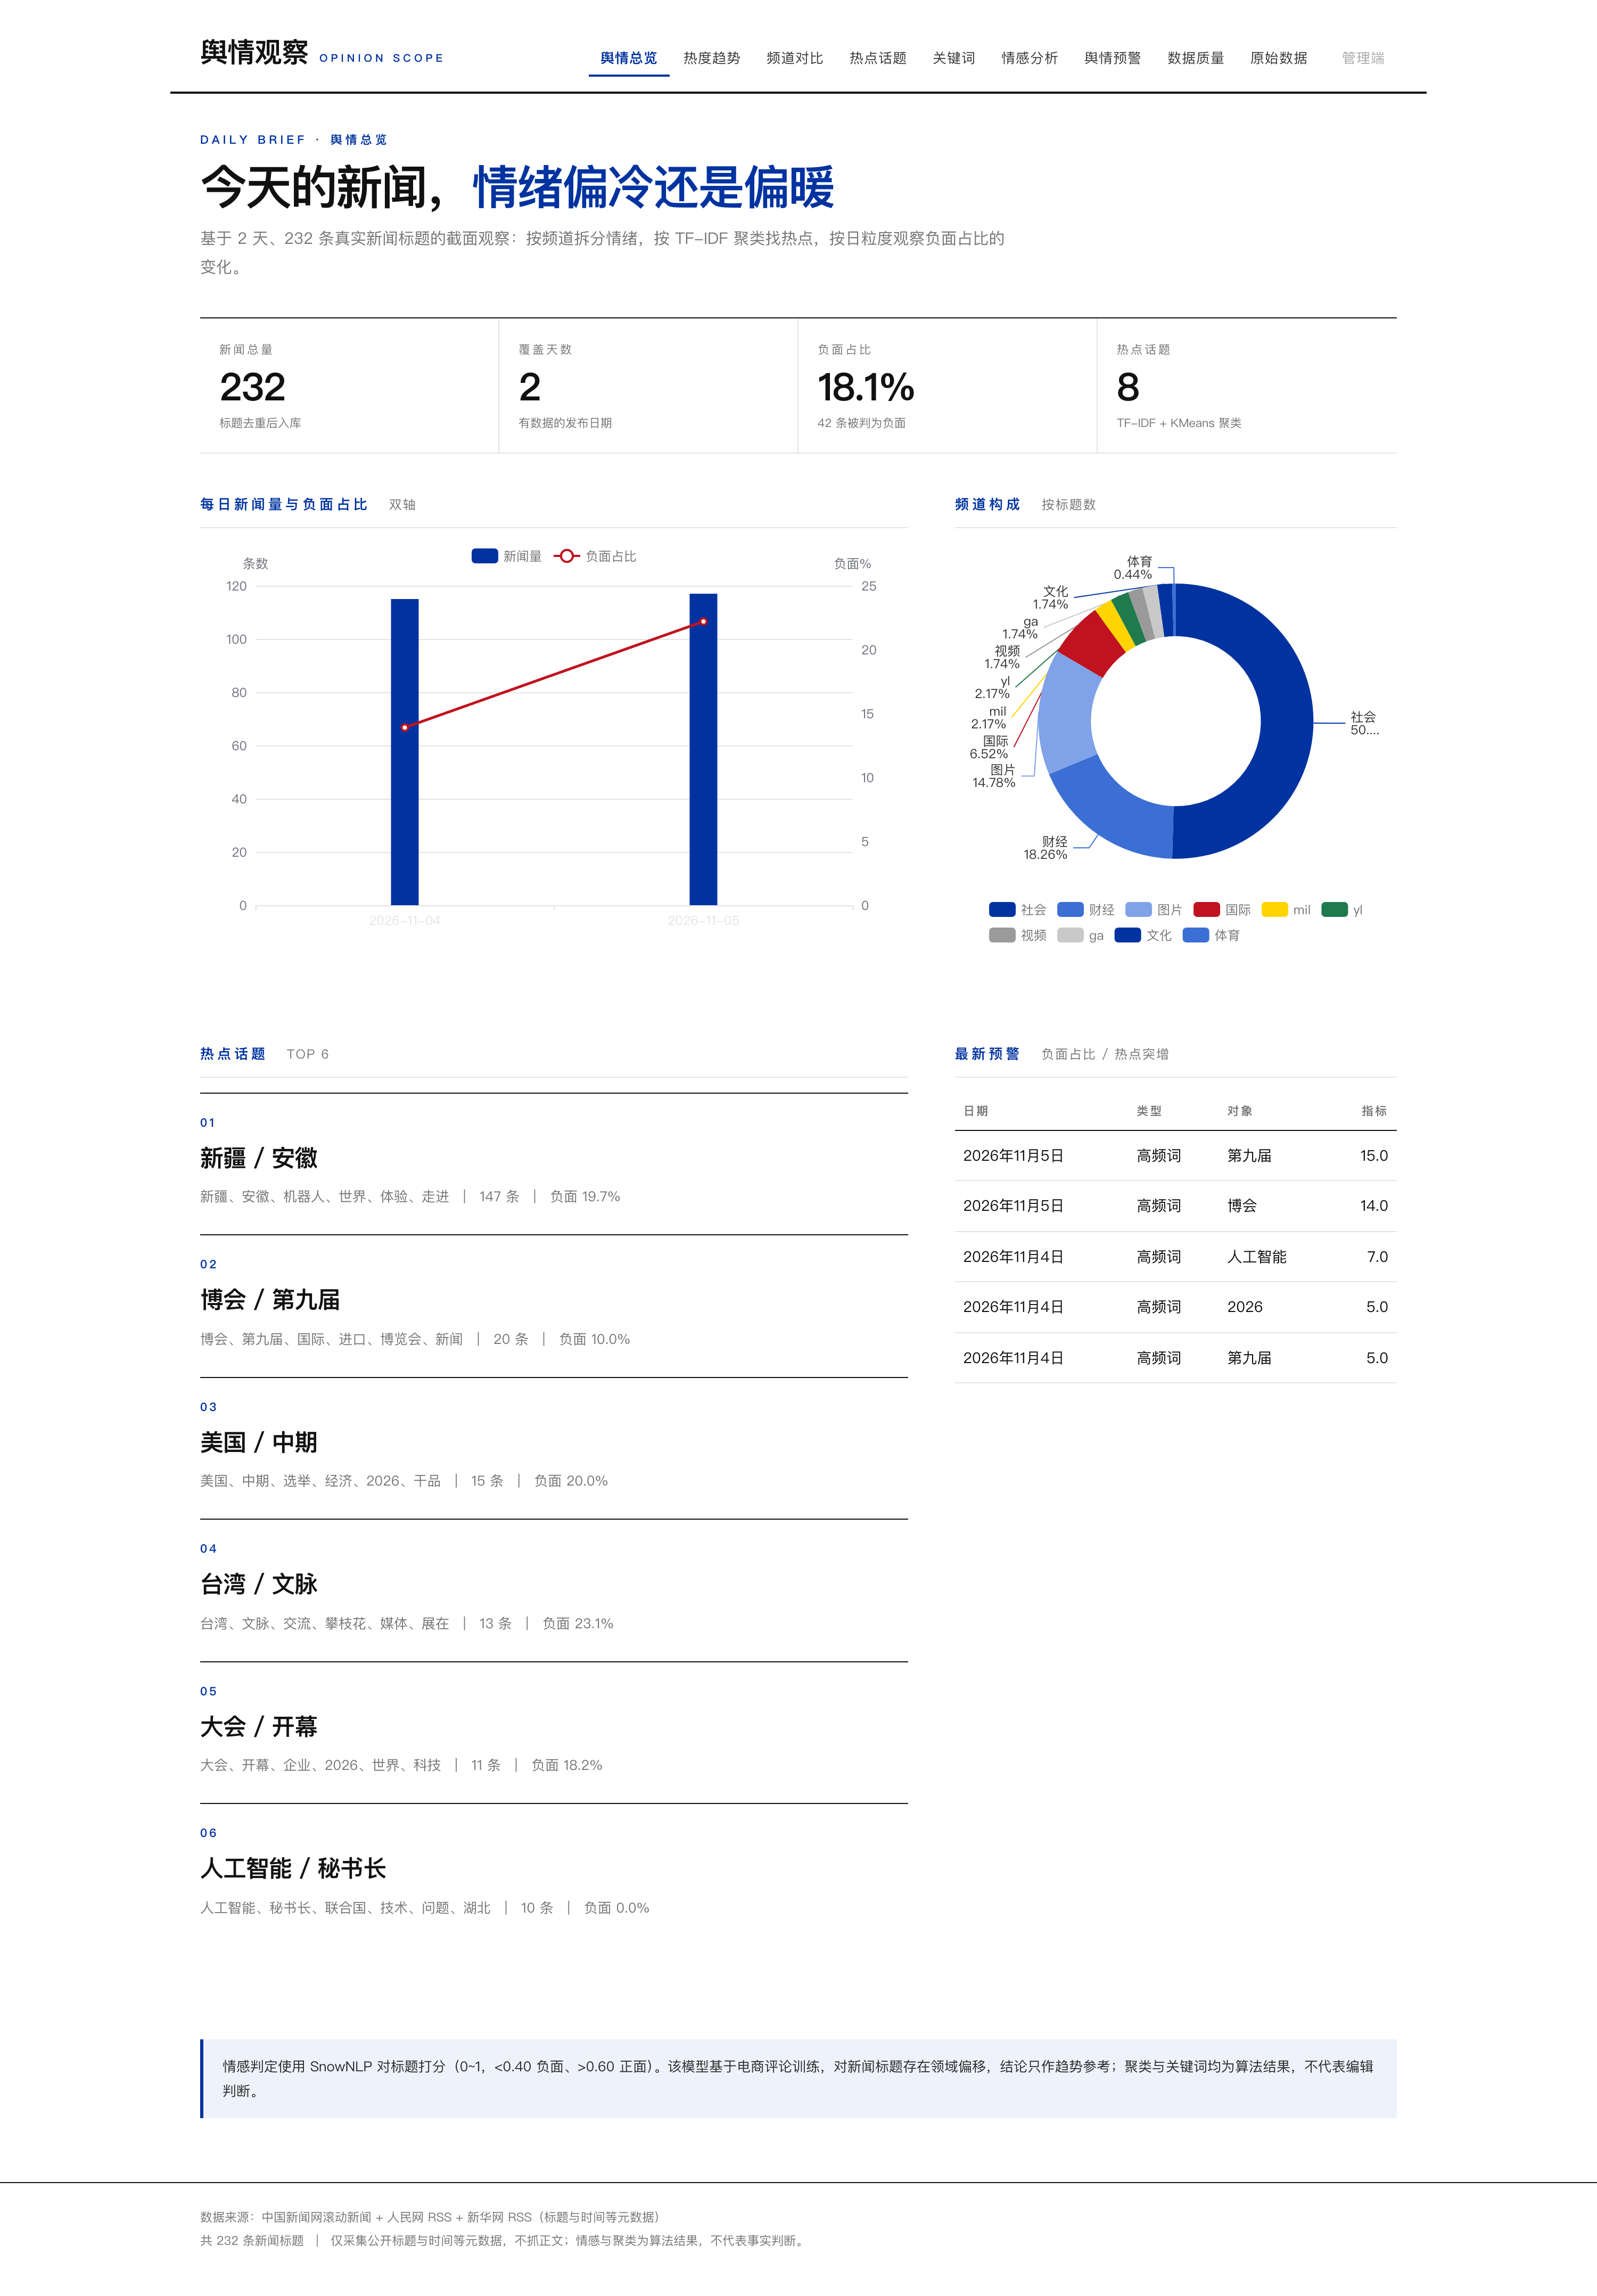
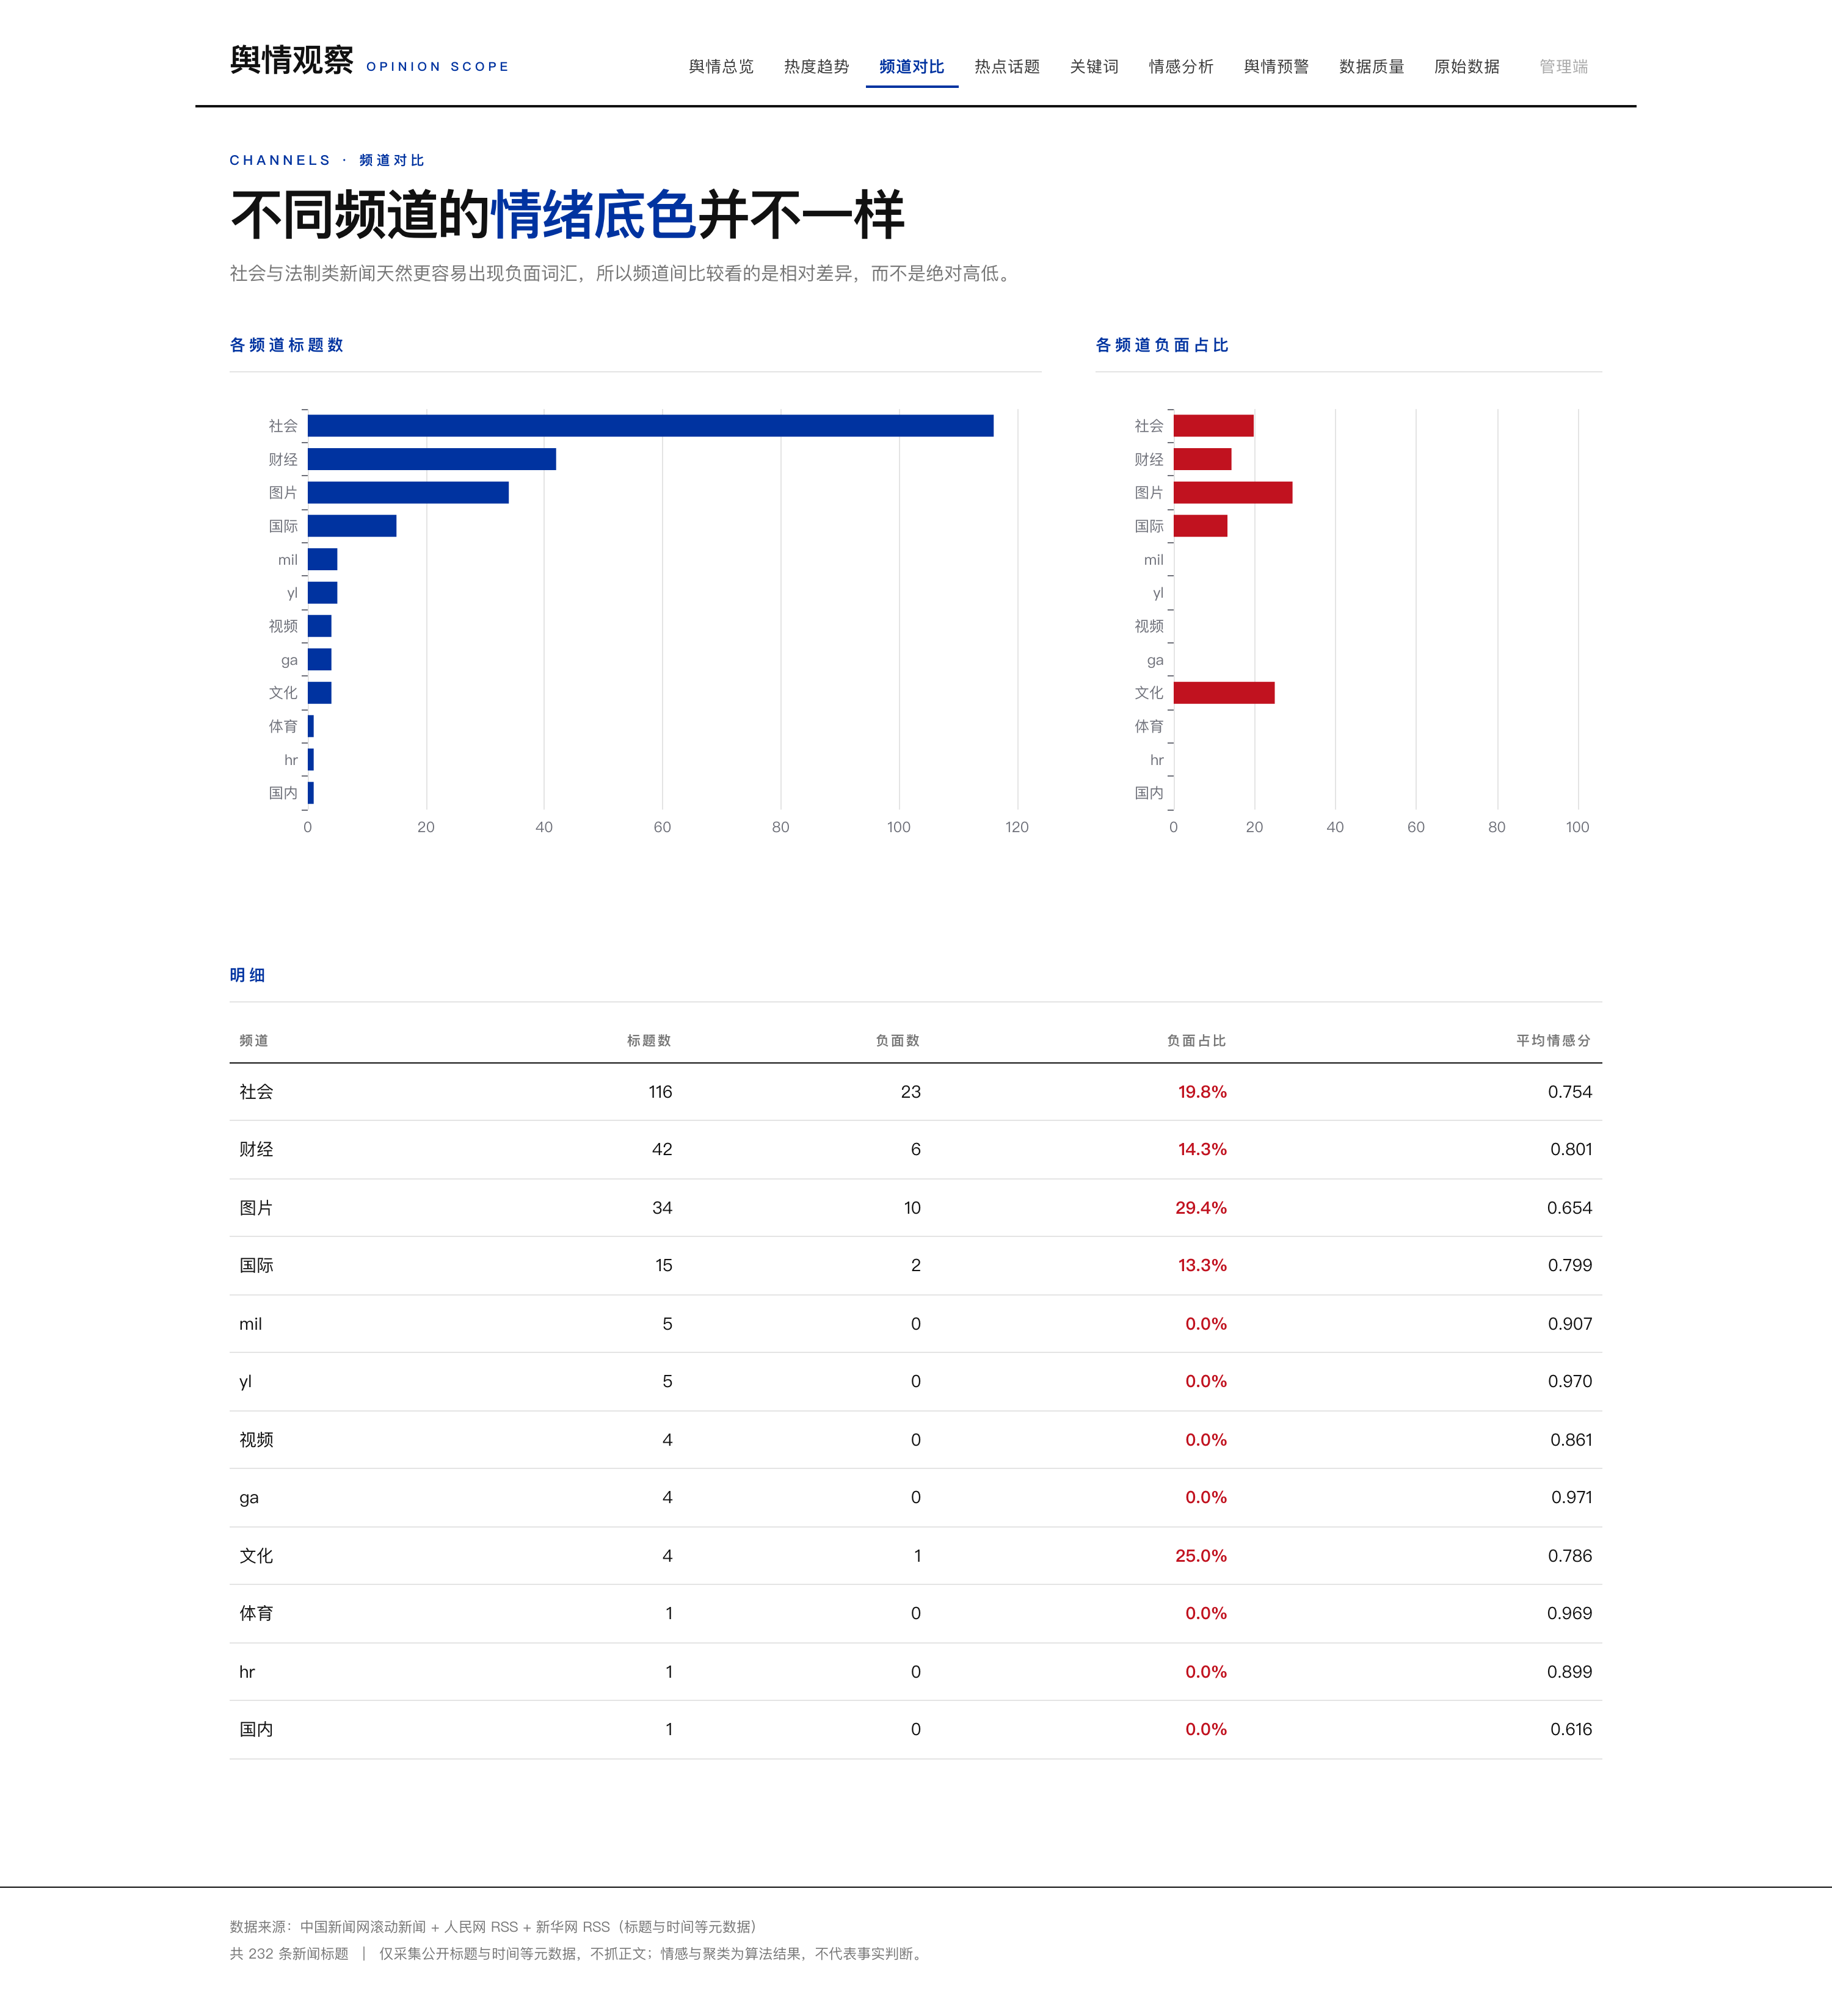
面向新闻标题的舆情分析系统:真实采集中国新闻网、人民网、新华网 725 条公开标题,清洗后 232 条入库,完成情感判定、TF-IDF 关键词、KMeans 热点聚类与舆情预警,并在 20 条人工抽检中如实报告模型偏差(三分类一致率 60%、负面召回 100%)。第 20 套「杂志特稿风」界面。
技术栈
Python、Django、jieba、SnowNLP、scikit-learn、ECharts、MySQL
功能模块
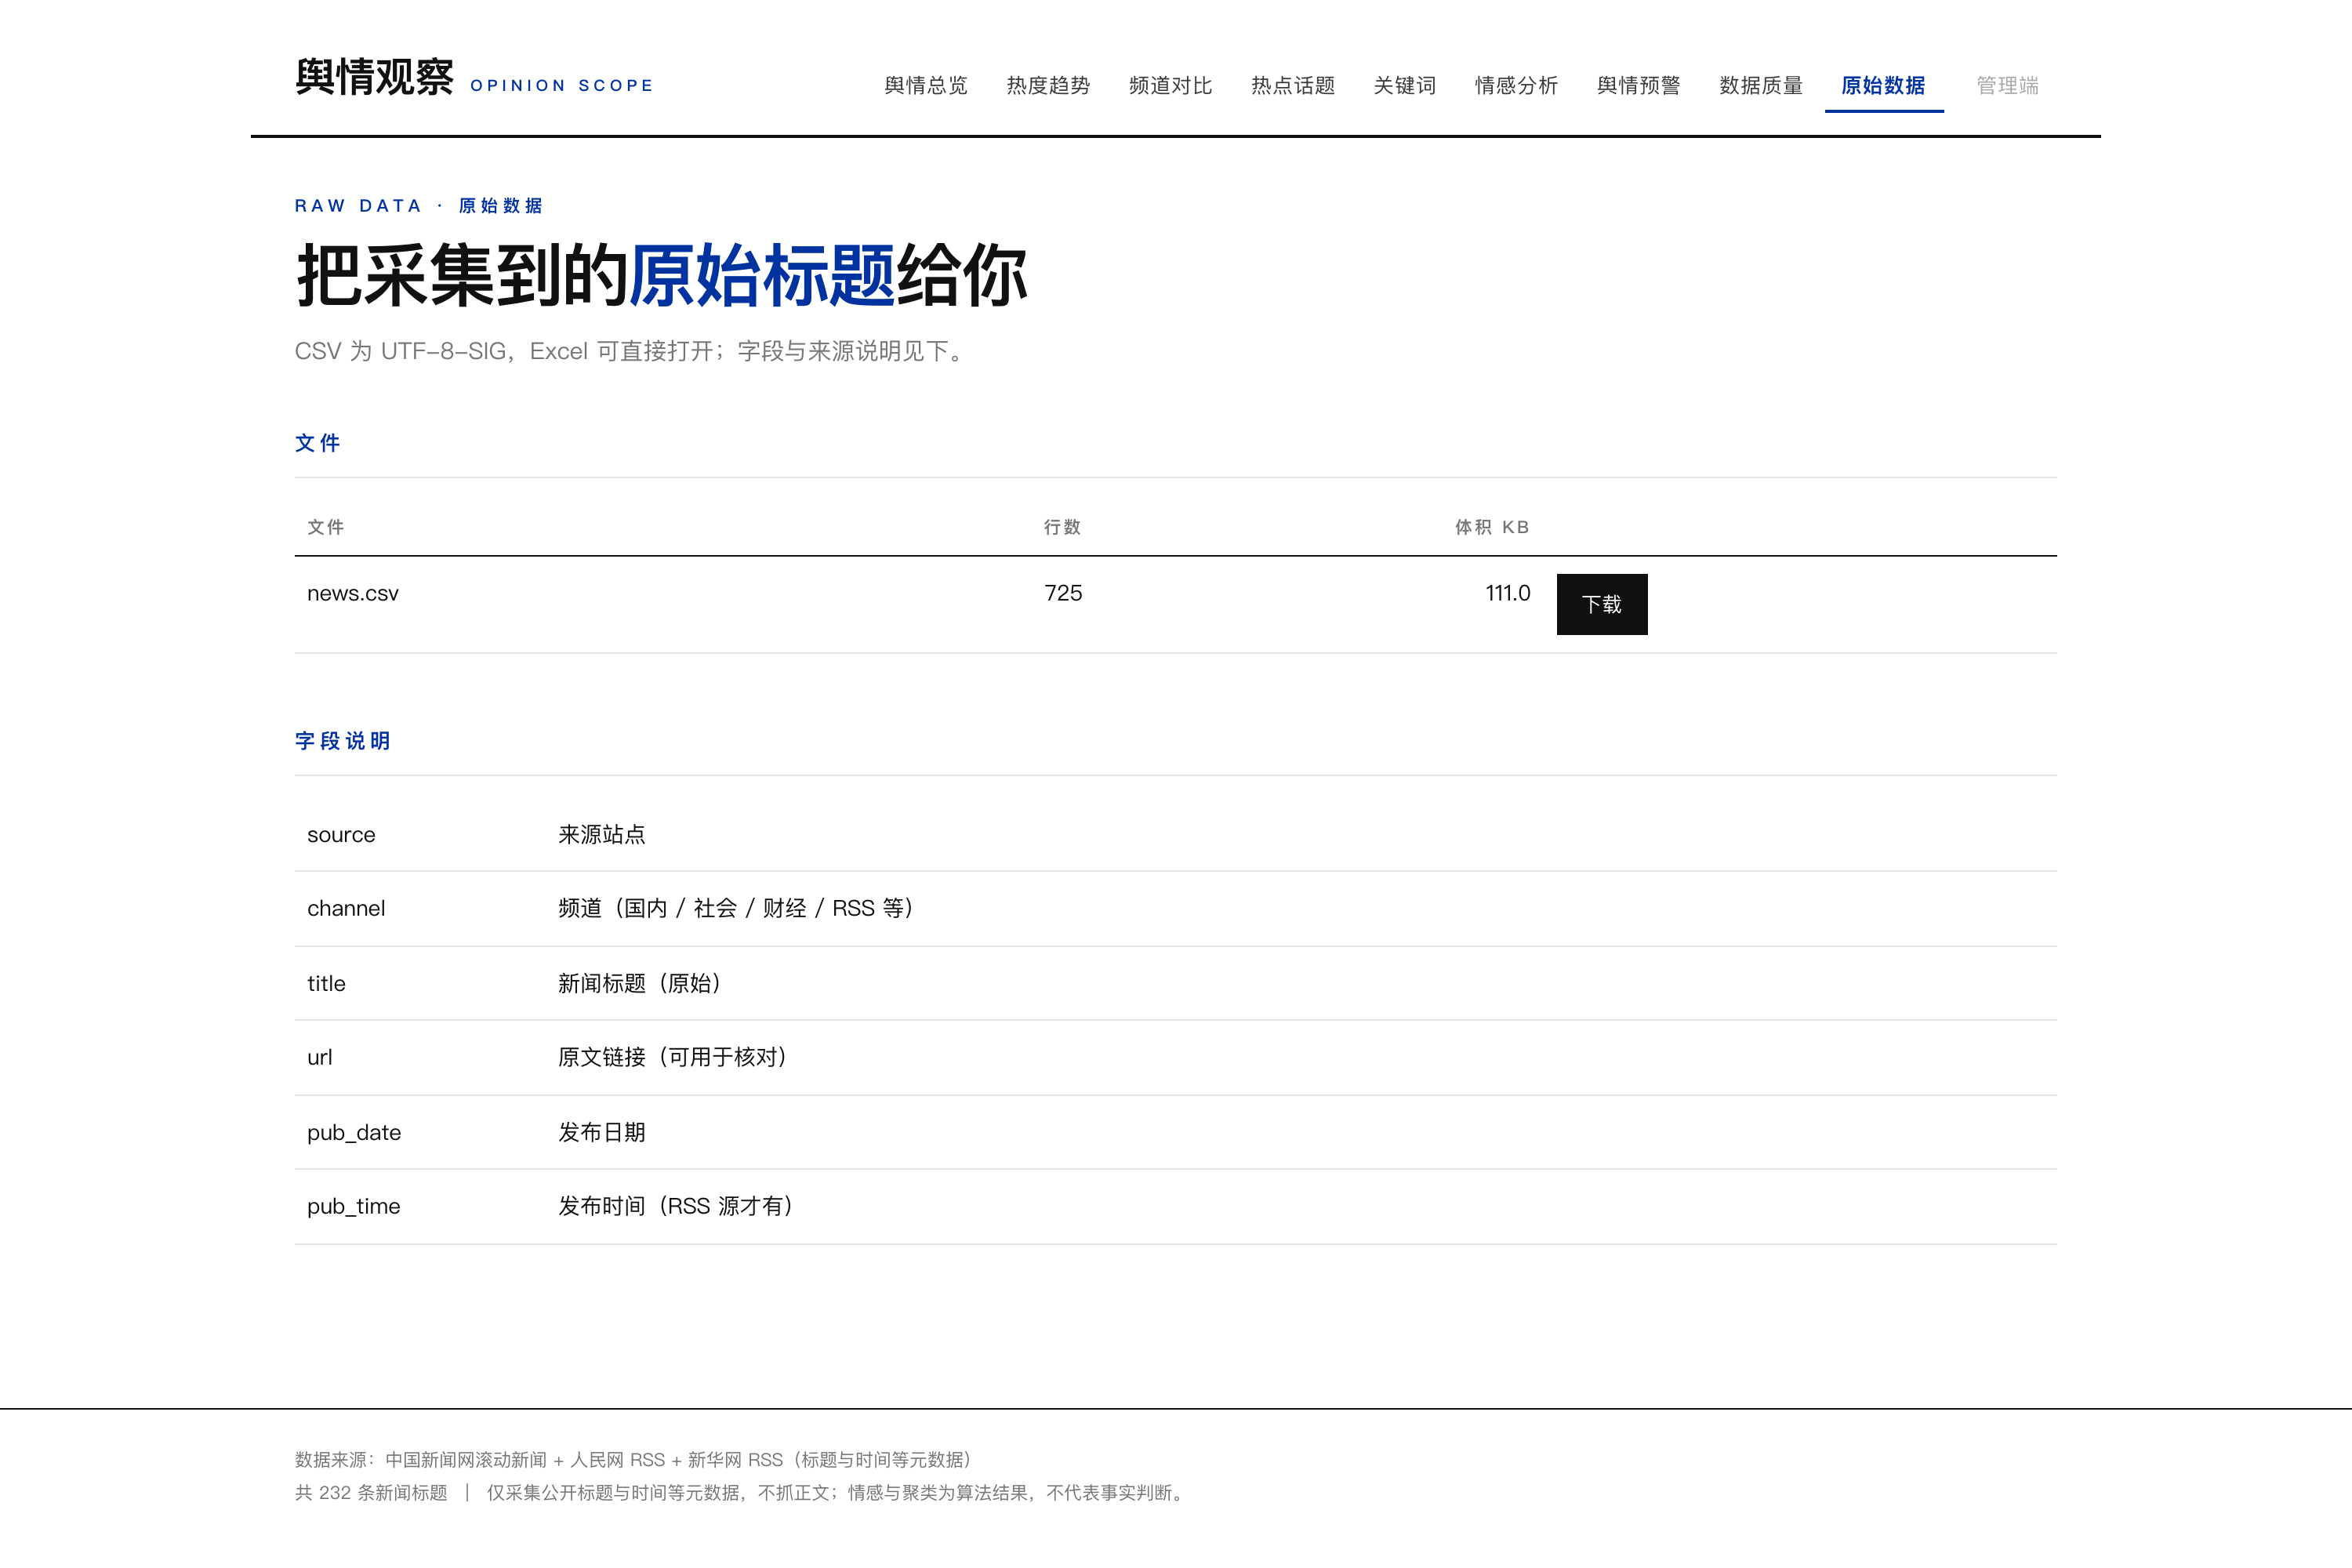
- 真实采集:中国新闻网滚动分页 + 国内/社会频道页 + 人民网/新华网 RSS,共 725 条标题;只取标题/链接/时间等元数据,不抓正文
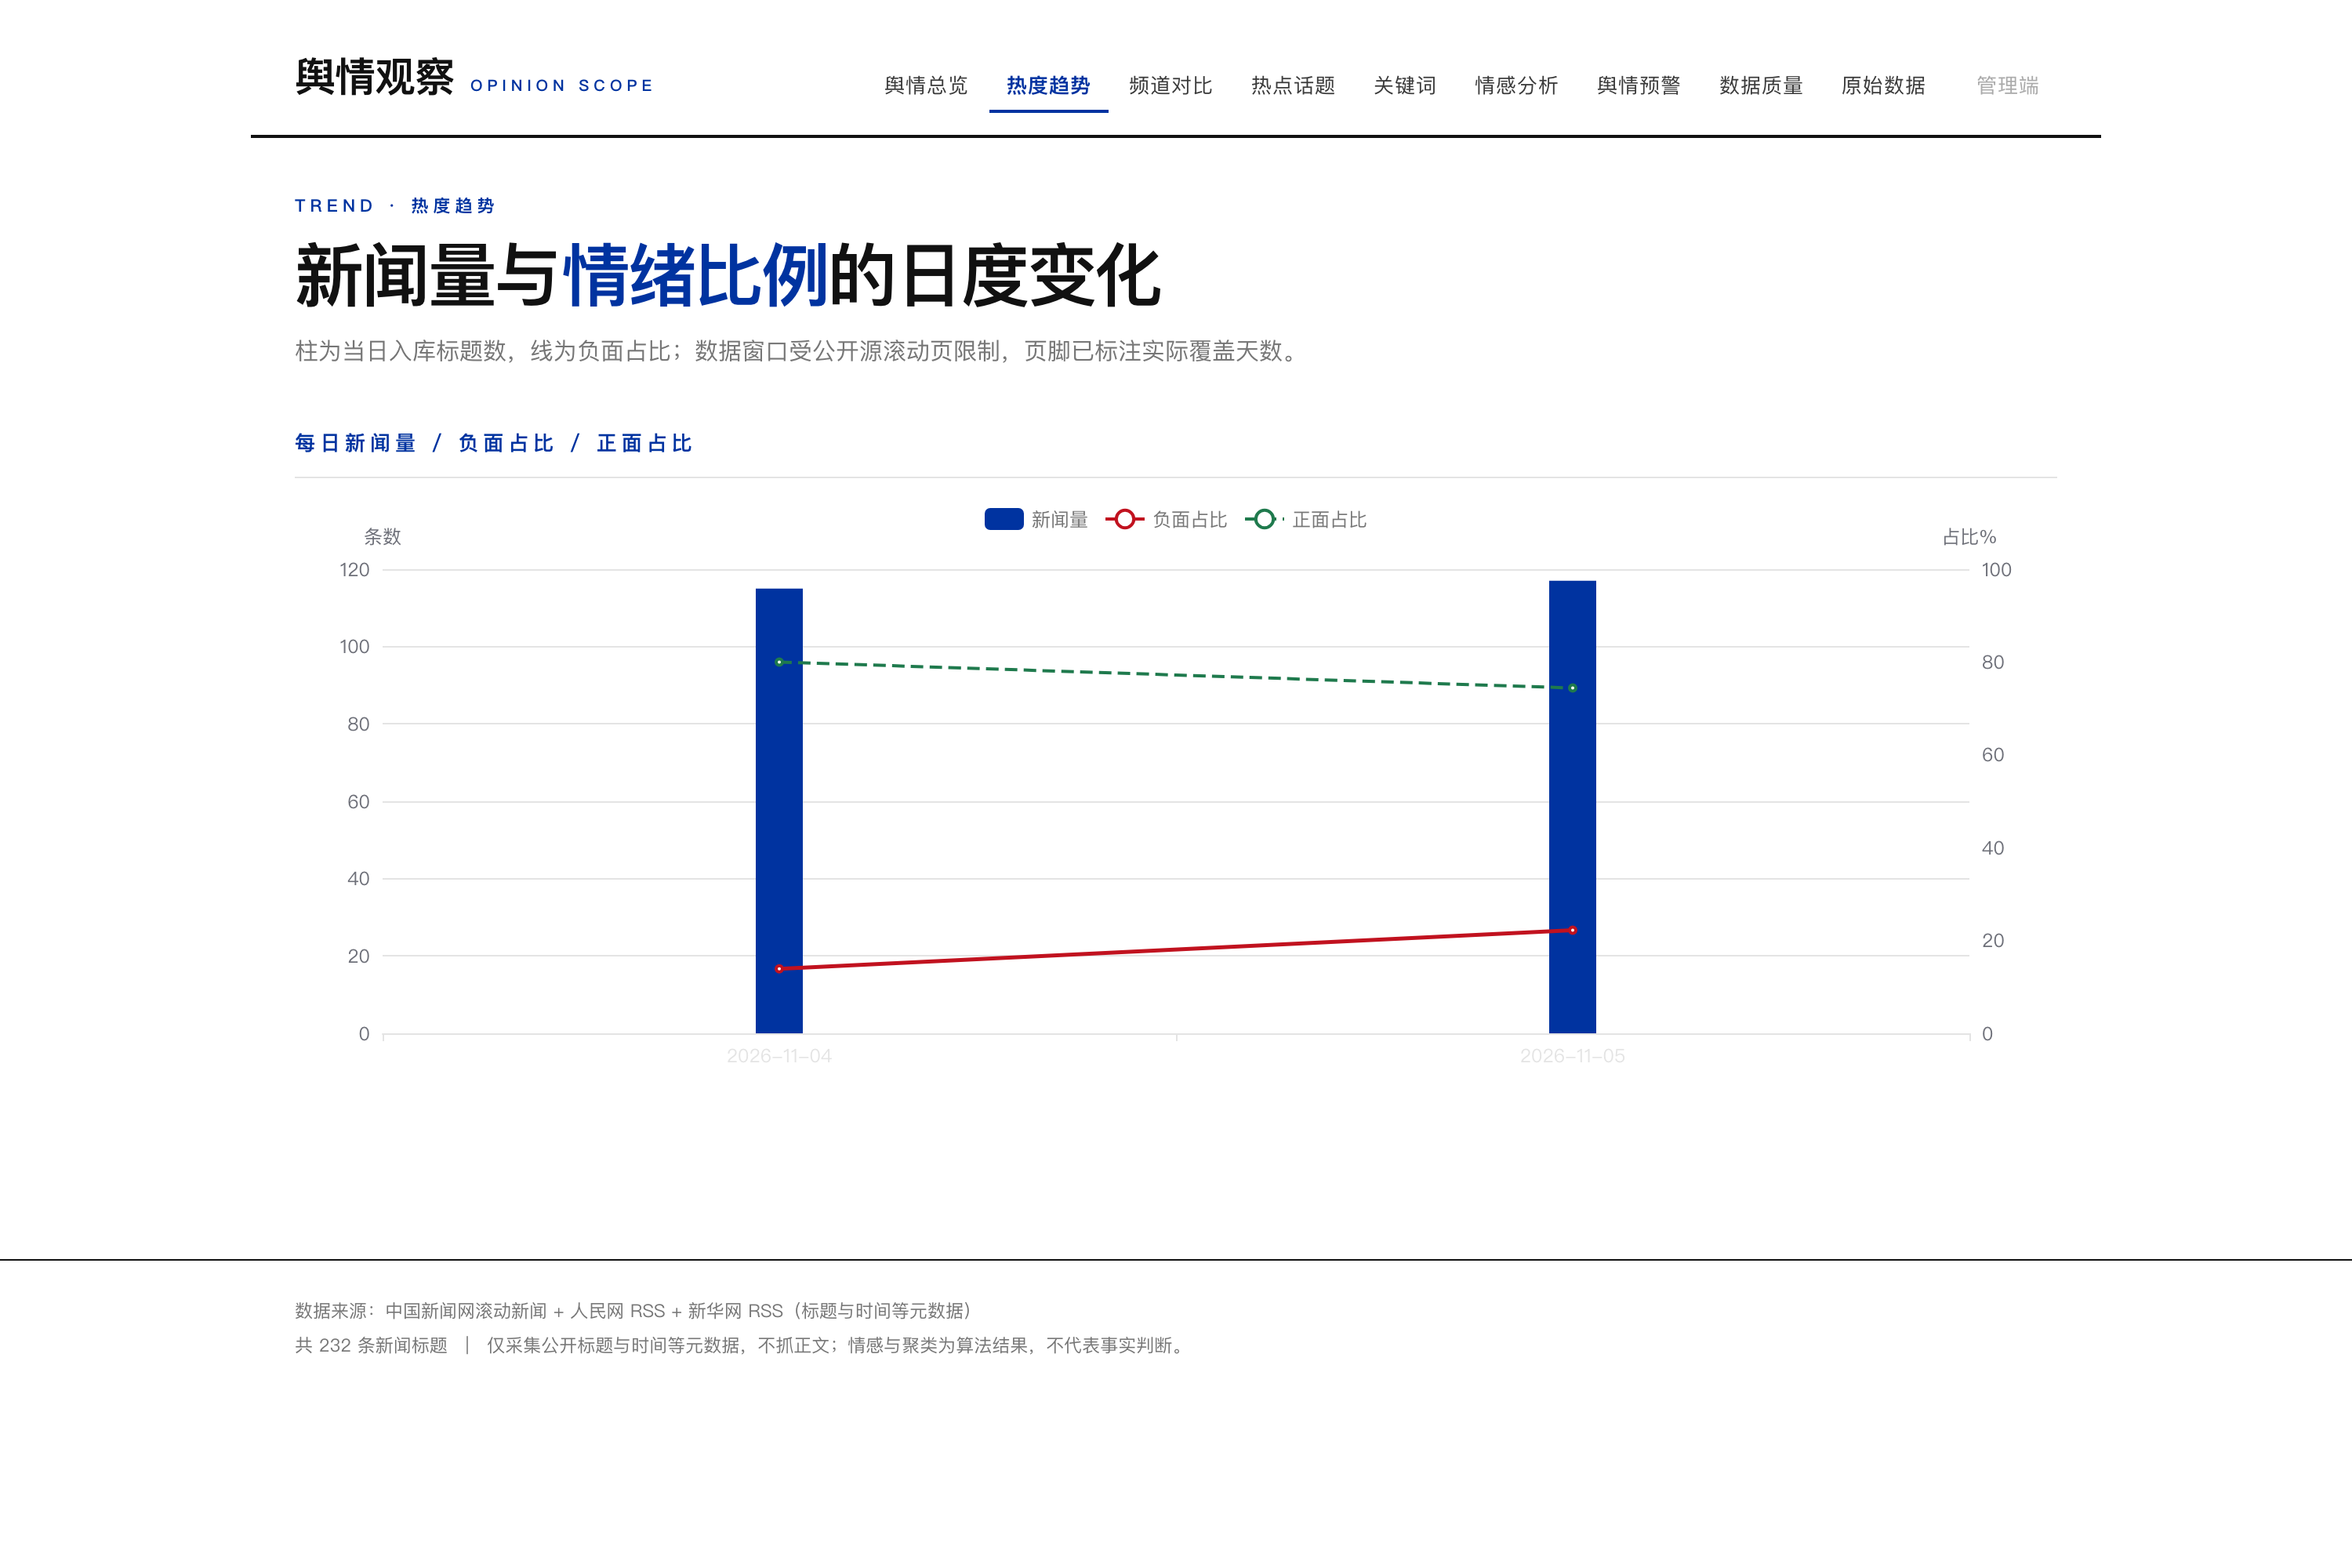
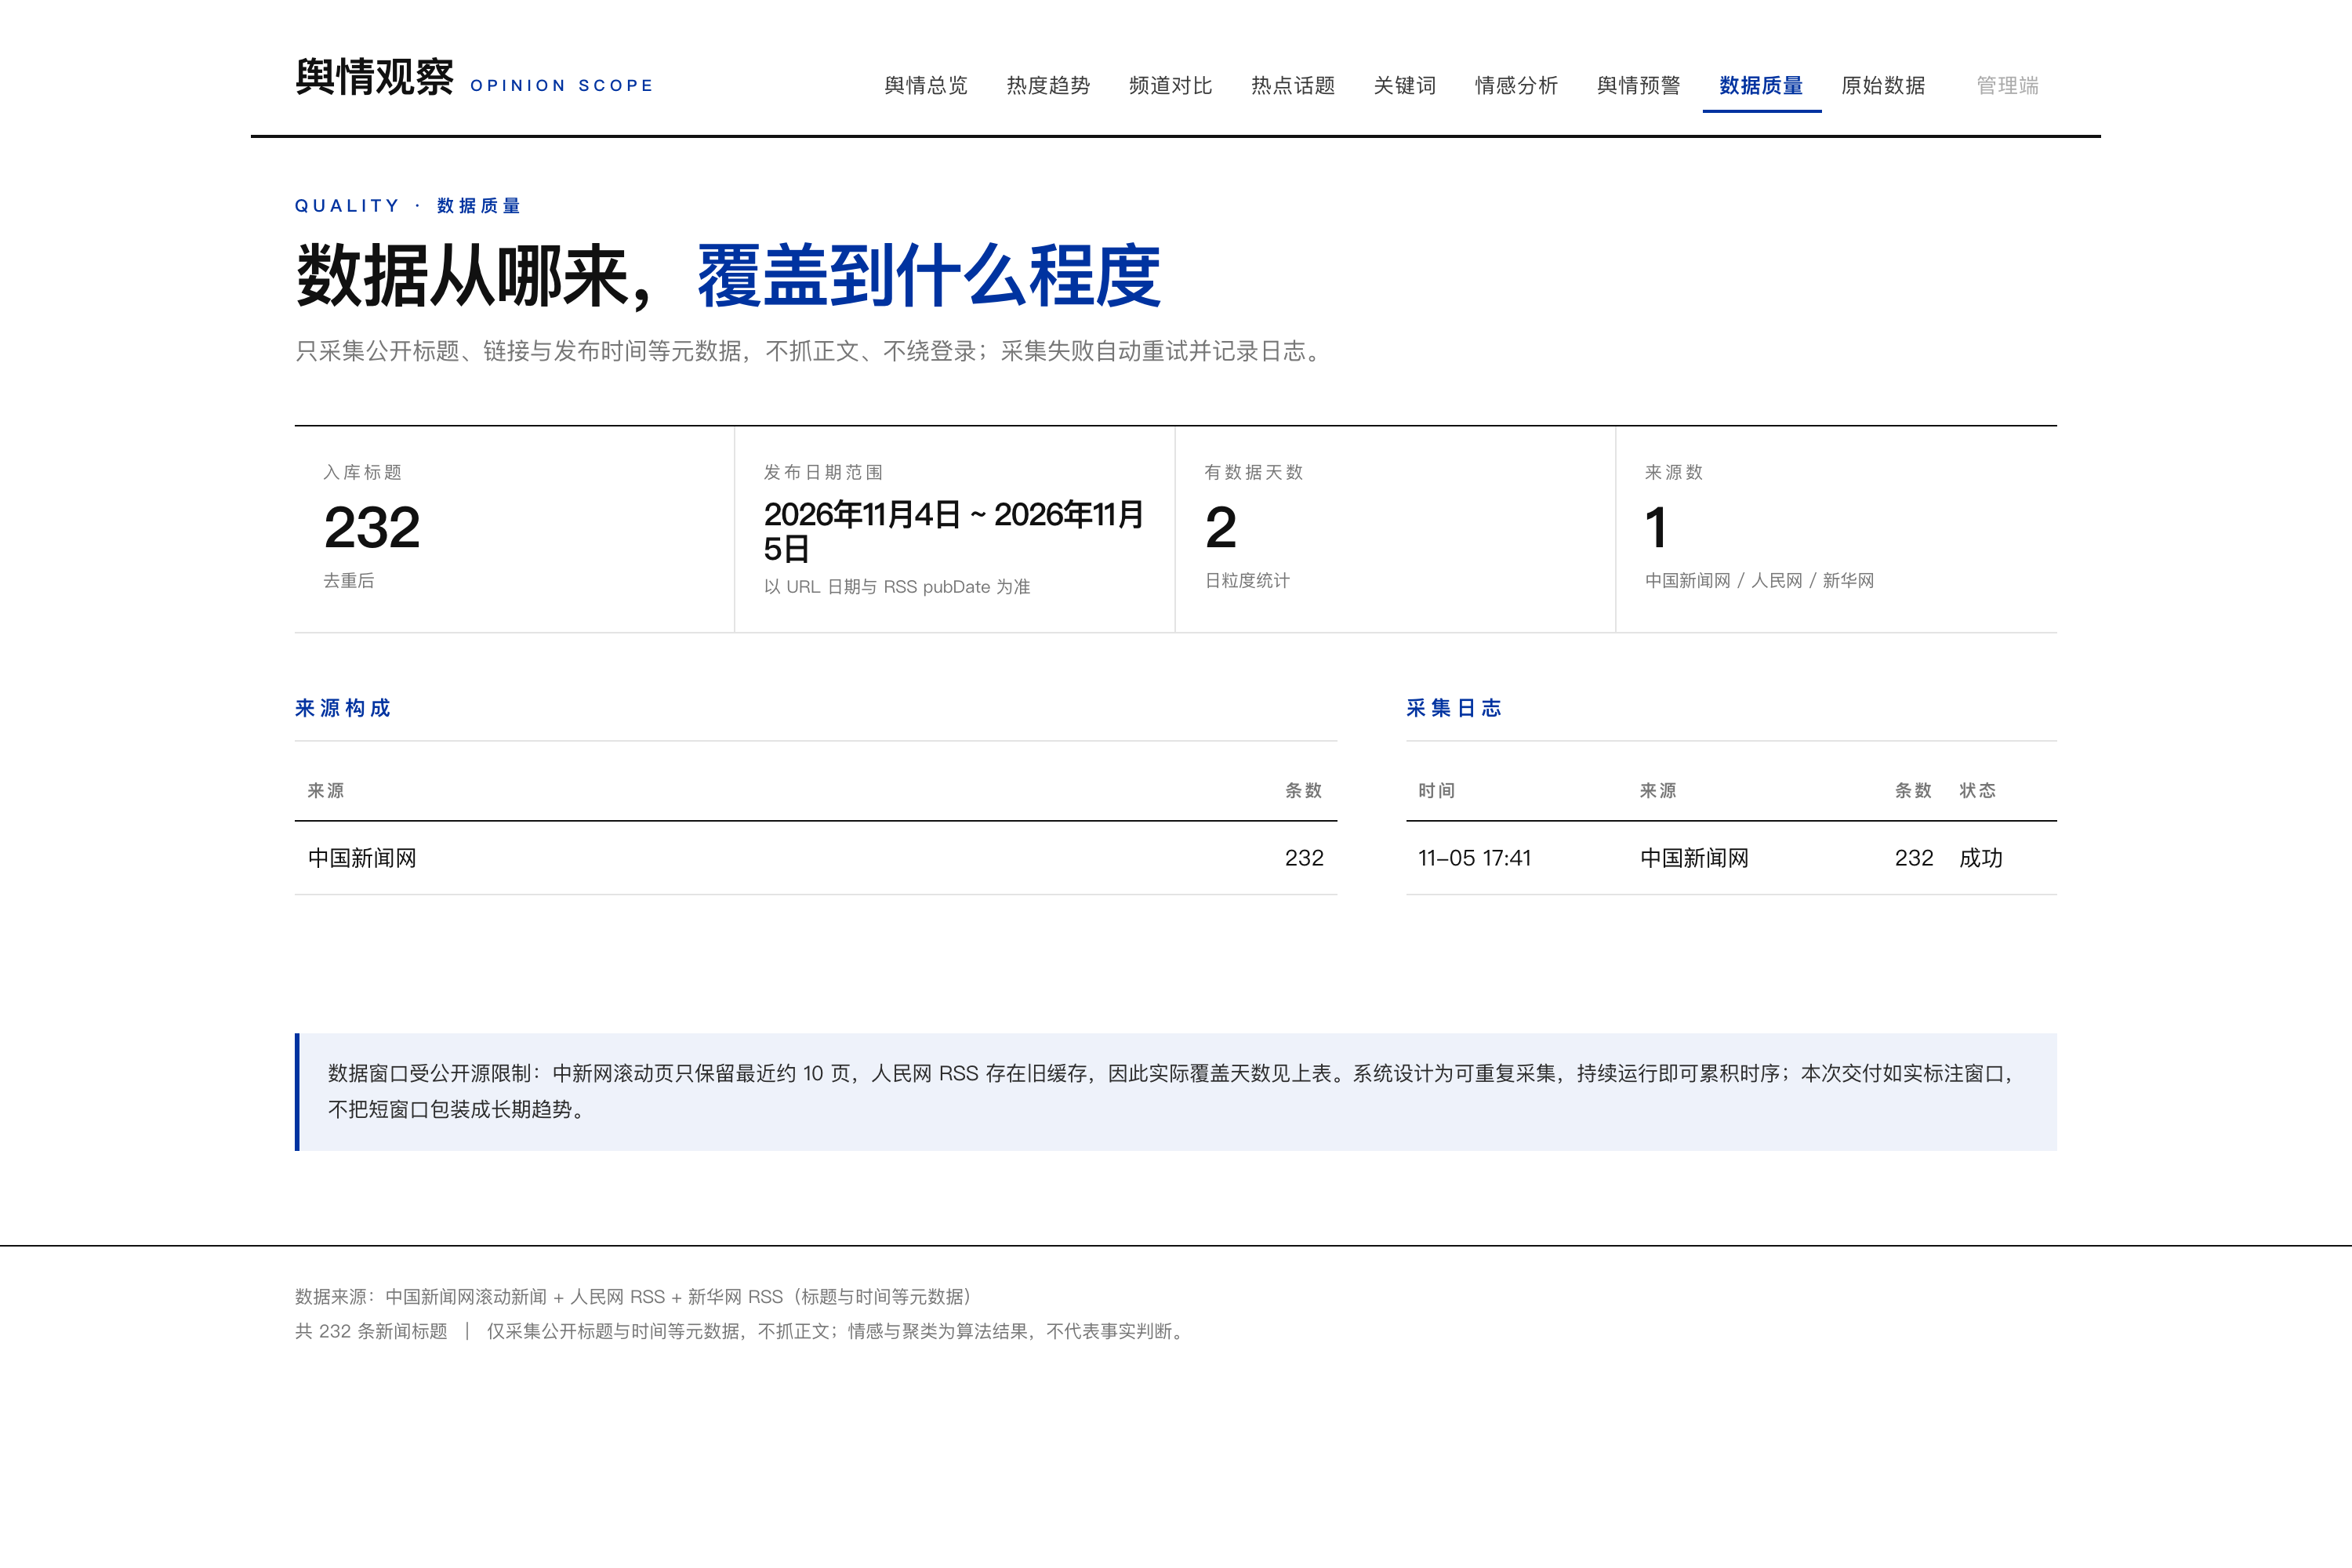
- 清洗与批次过滤:按 URL 去重、剔除过短与异常标题、过滤人民网 RSS 的 2025-06 旧缓存批次,避免时间轴断裂;最终 232 条、2 天窗口如实标注
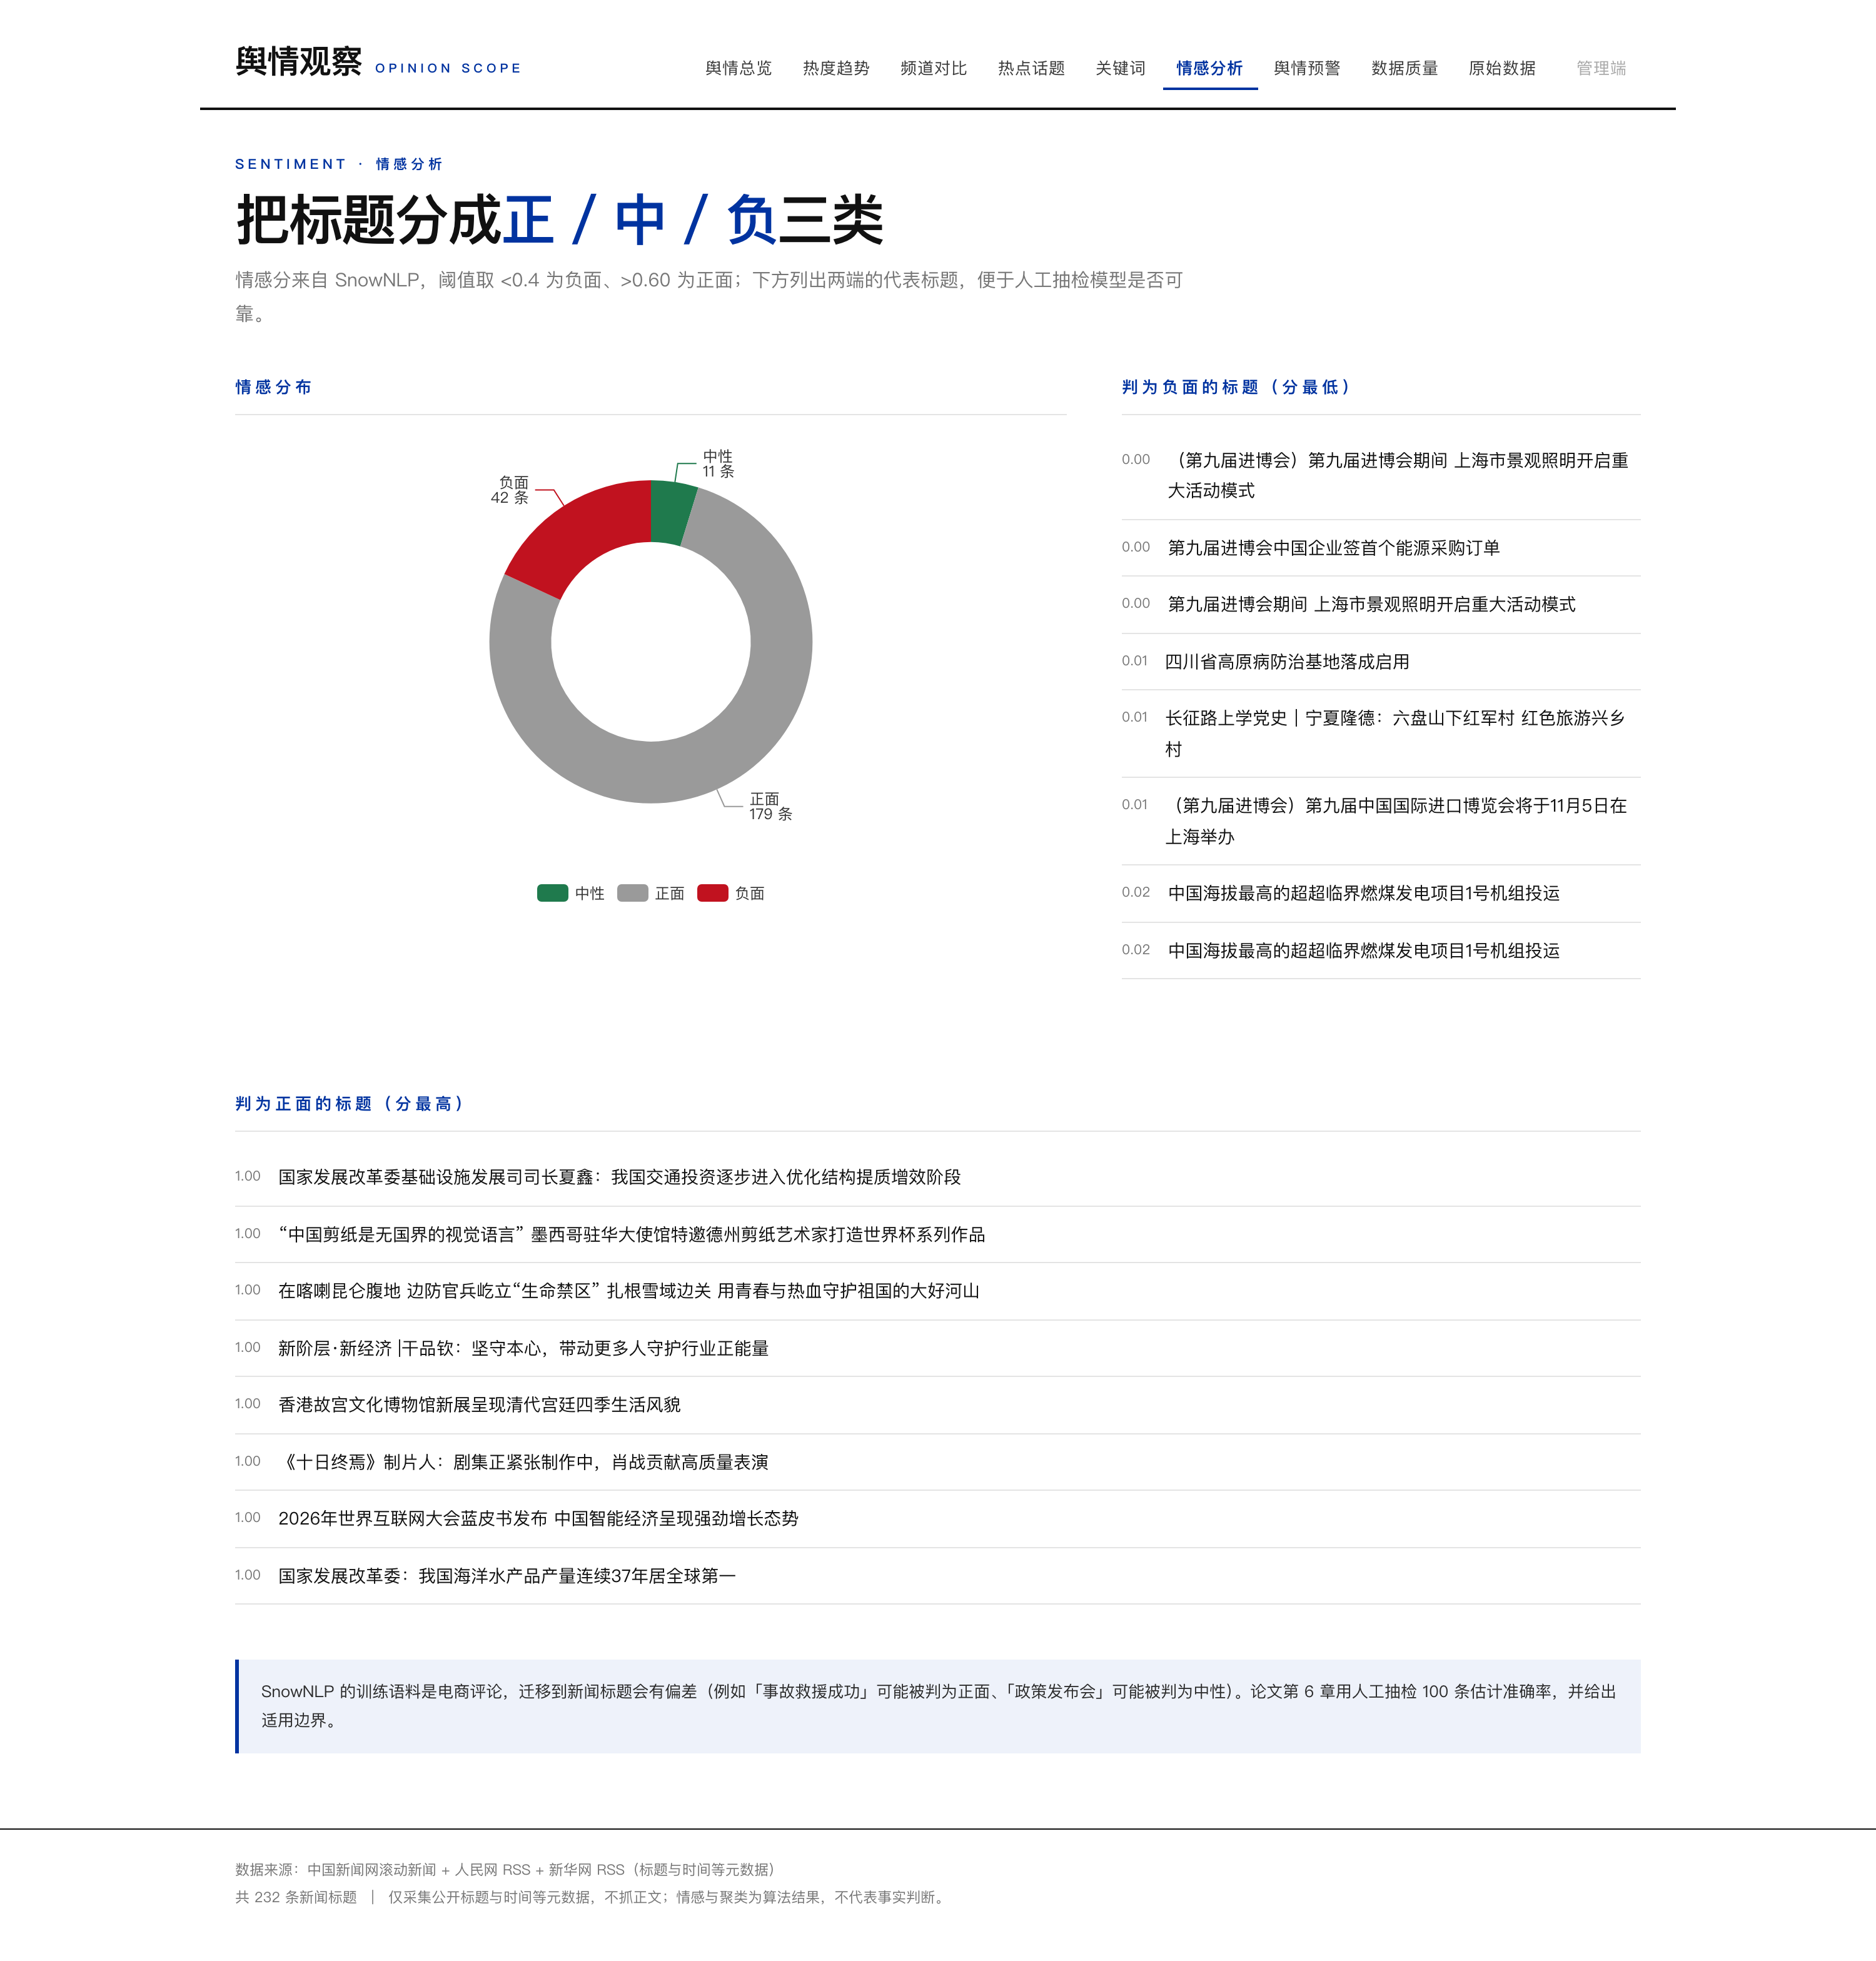
- 情感判定:SnowNLP 打分 0~1,三段阈值;20 条人工抽检得出三分类一致率 60%、负面召回 100%、精确率 50%——模型对真负面敏感,却把中性陈述判为正面
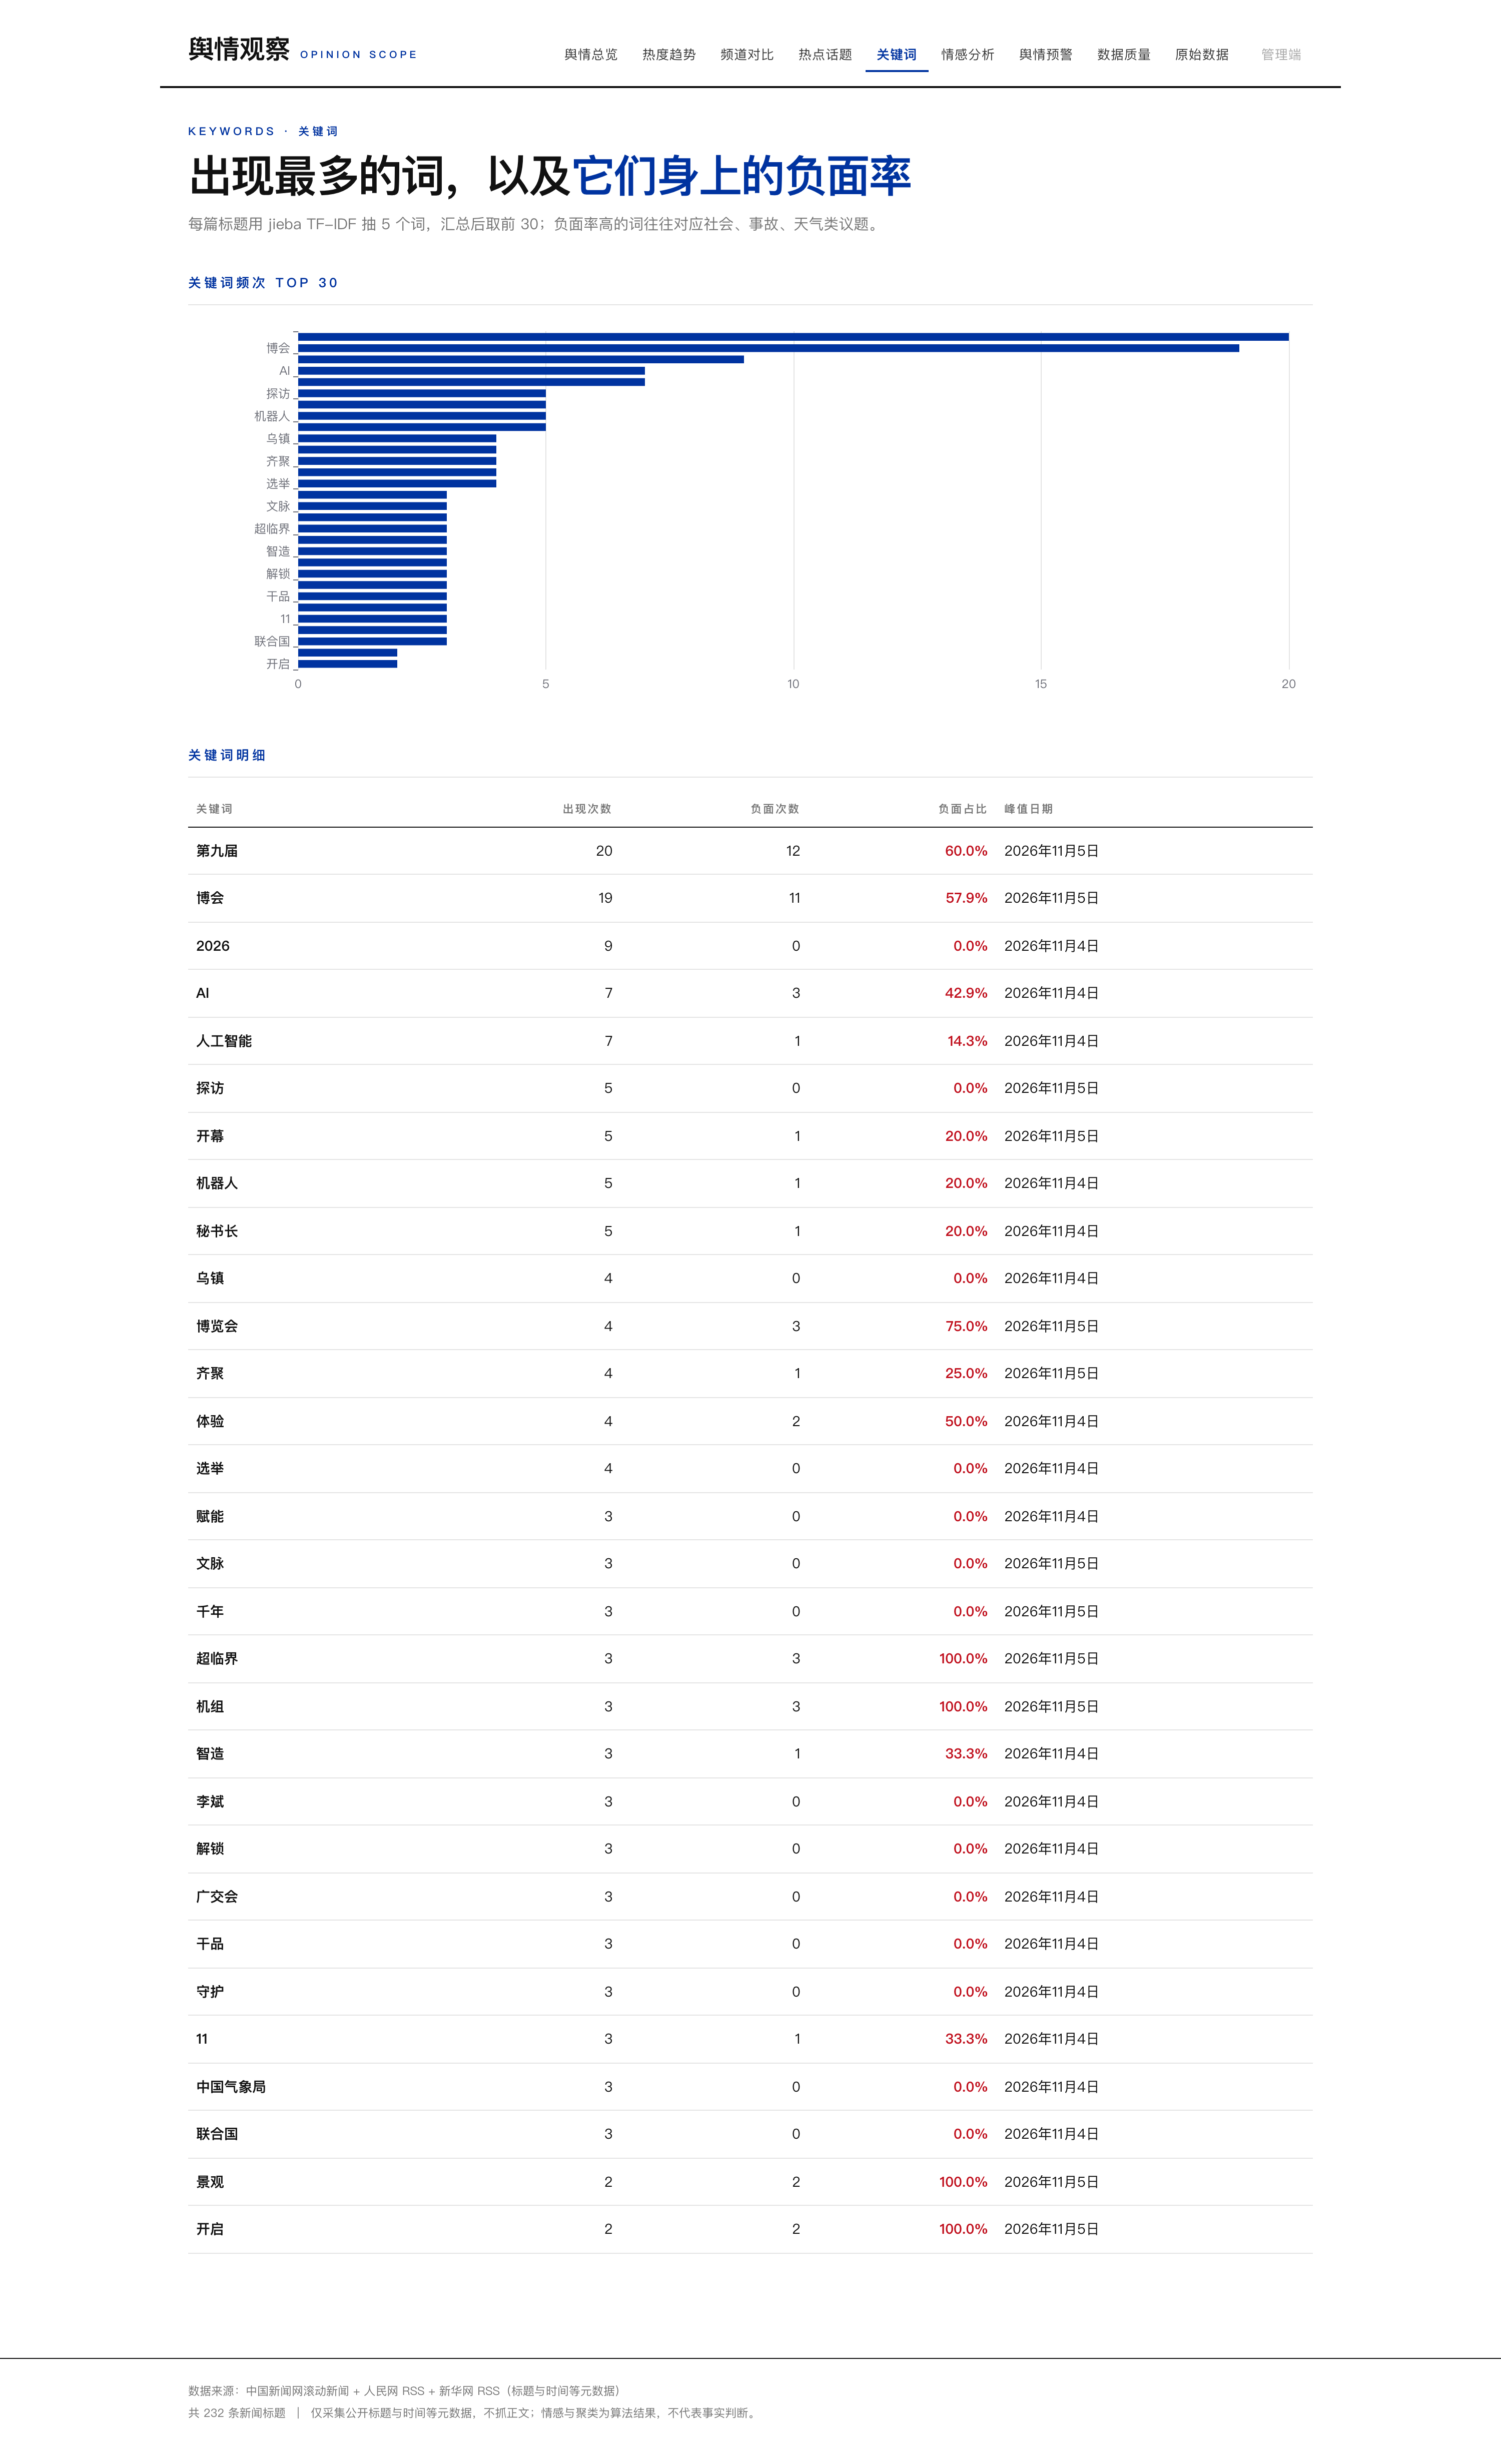
- 关键词:jieba TF-IDF 每篇抽 5 词,汇总 TOP30,并统计每个关键词的负面率与峰值日期
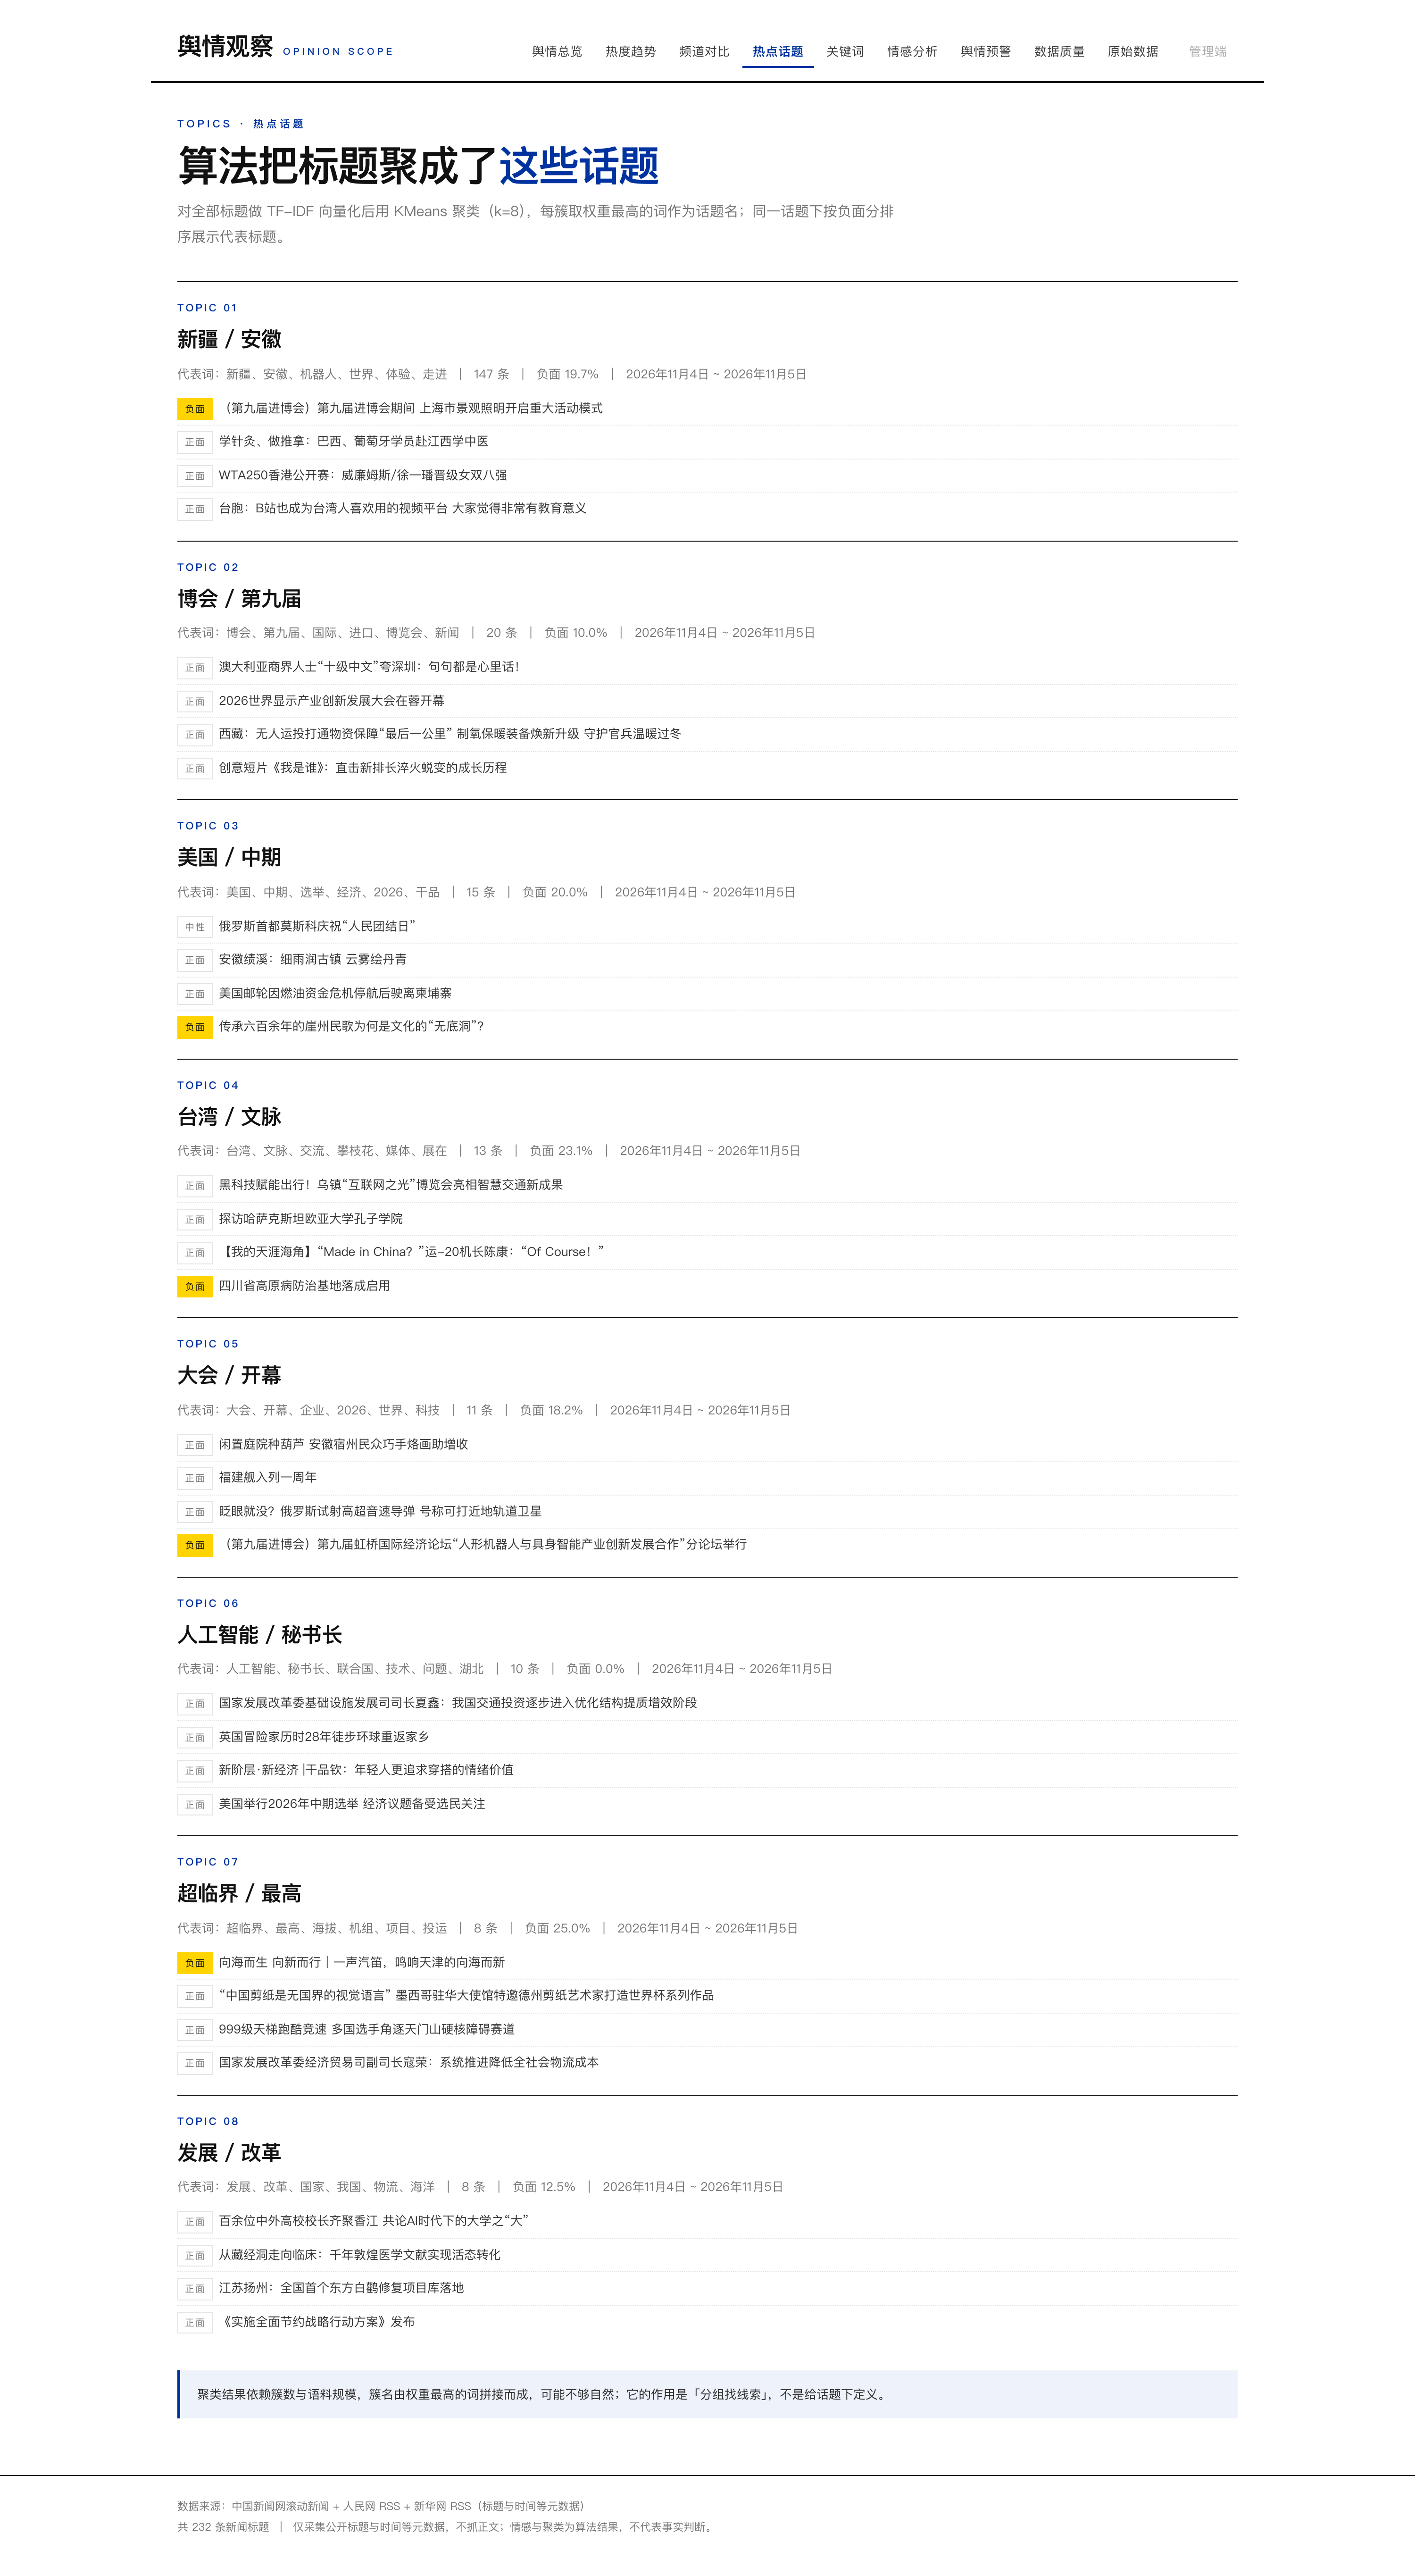
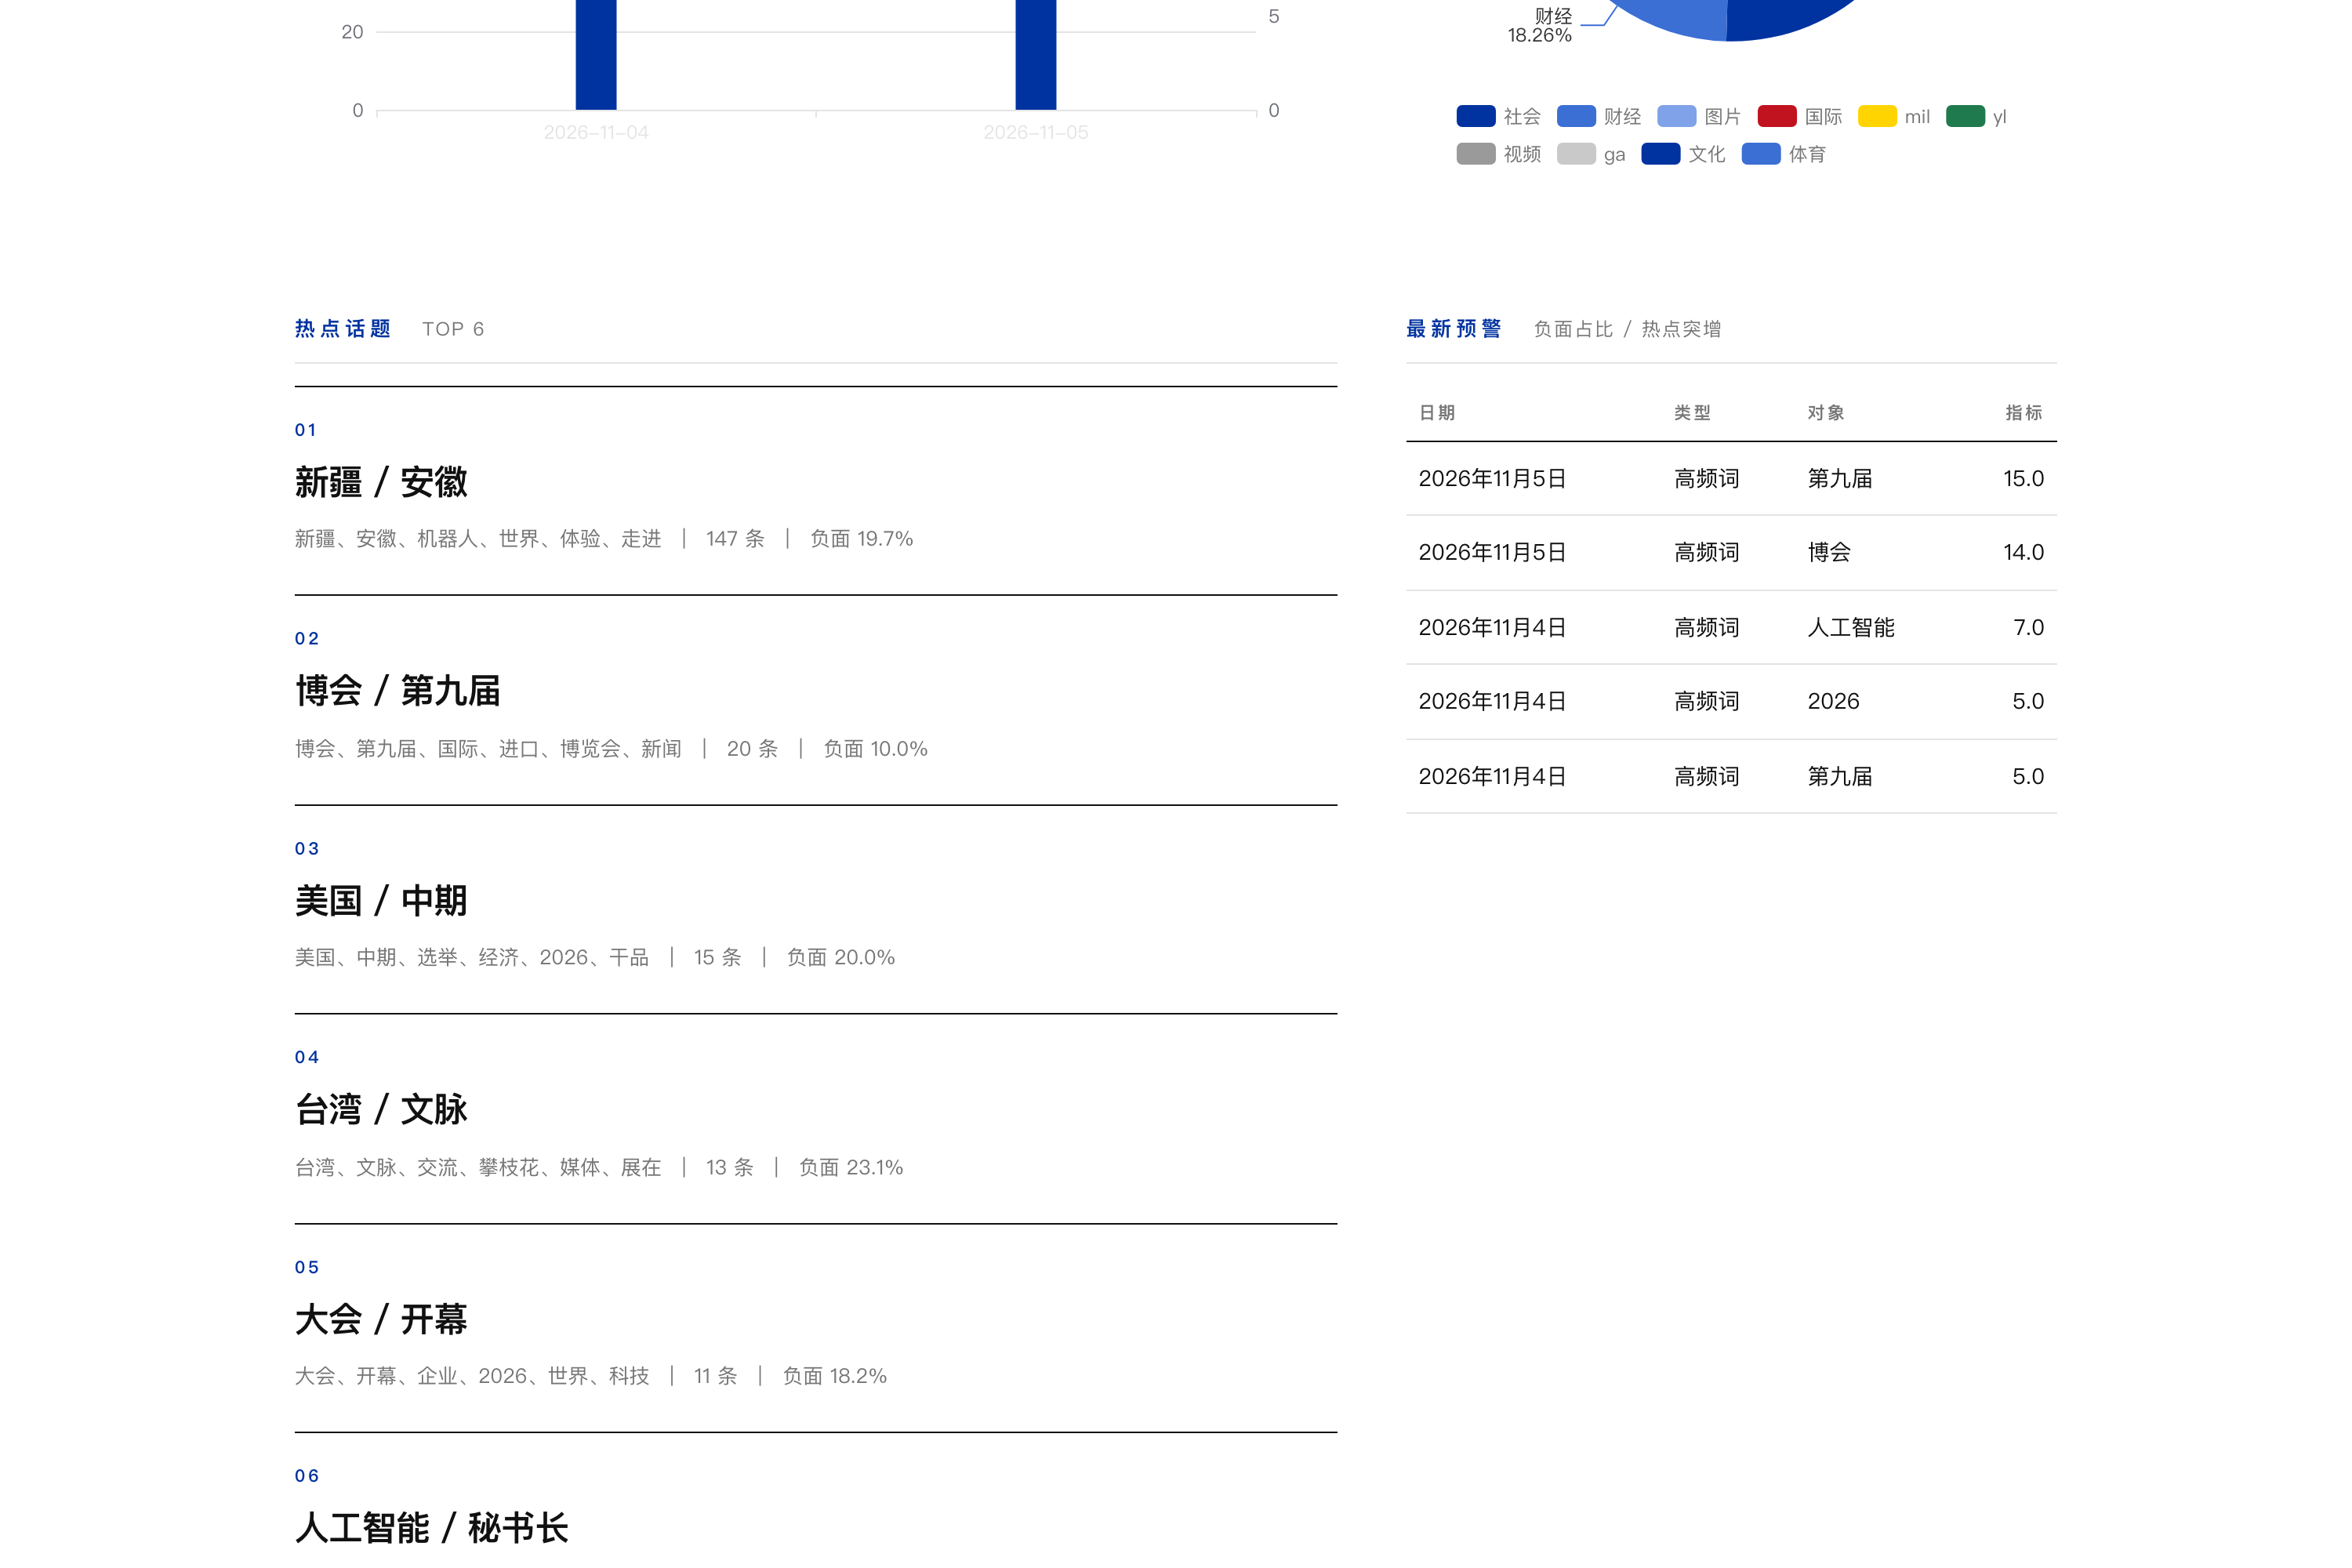
- 热点聚类:TF-IDF + KMeans 聚 8 簇,过滤单字与符号后取权重词作簇名(新疆/服务、博会/第九届等),每簇附代表标题
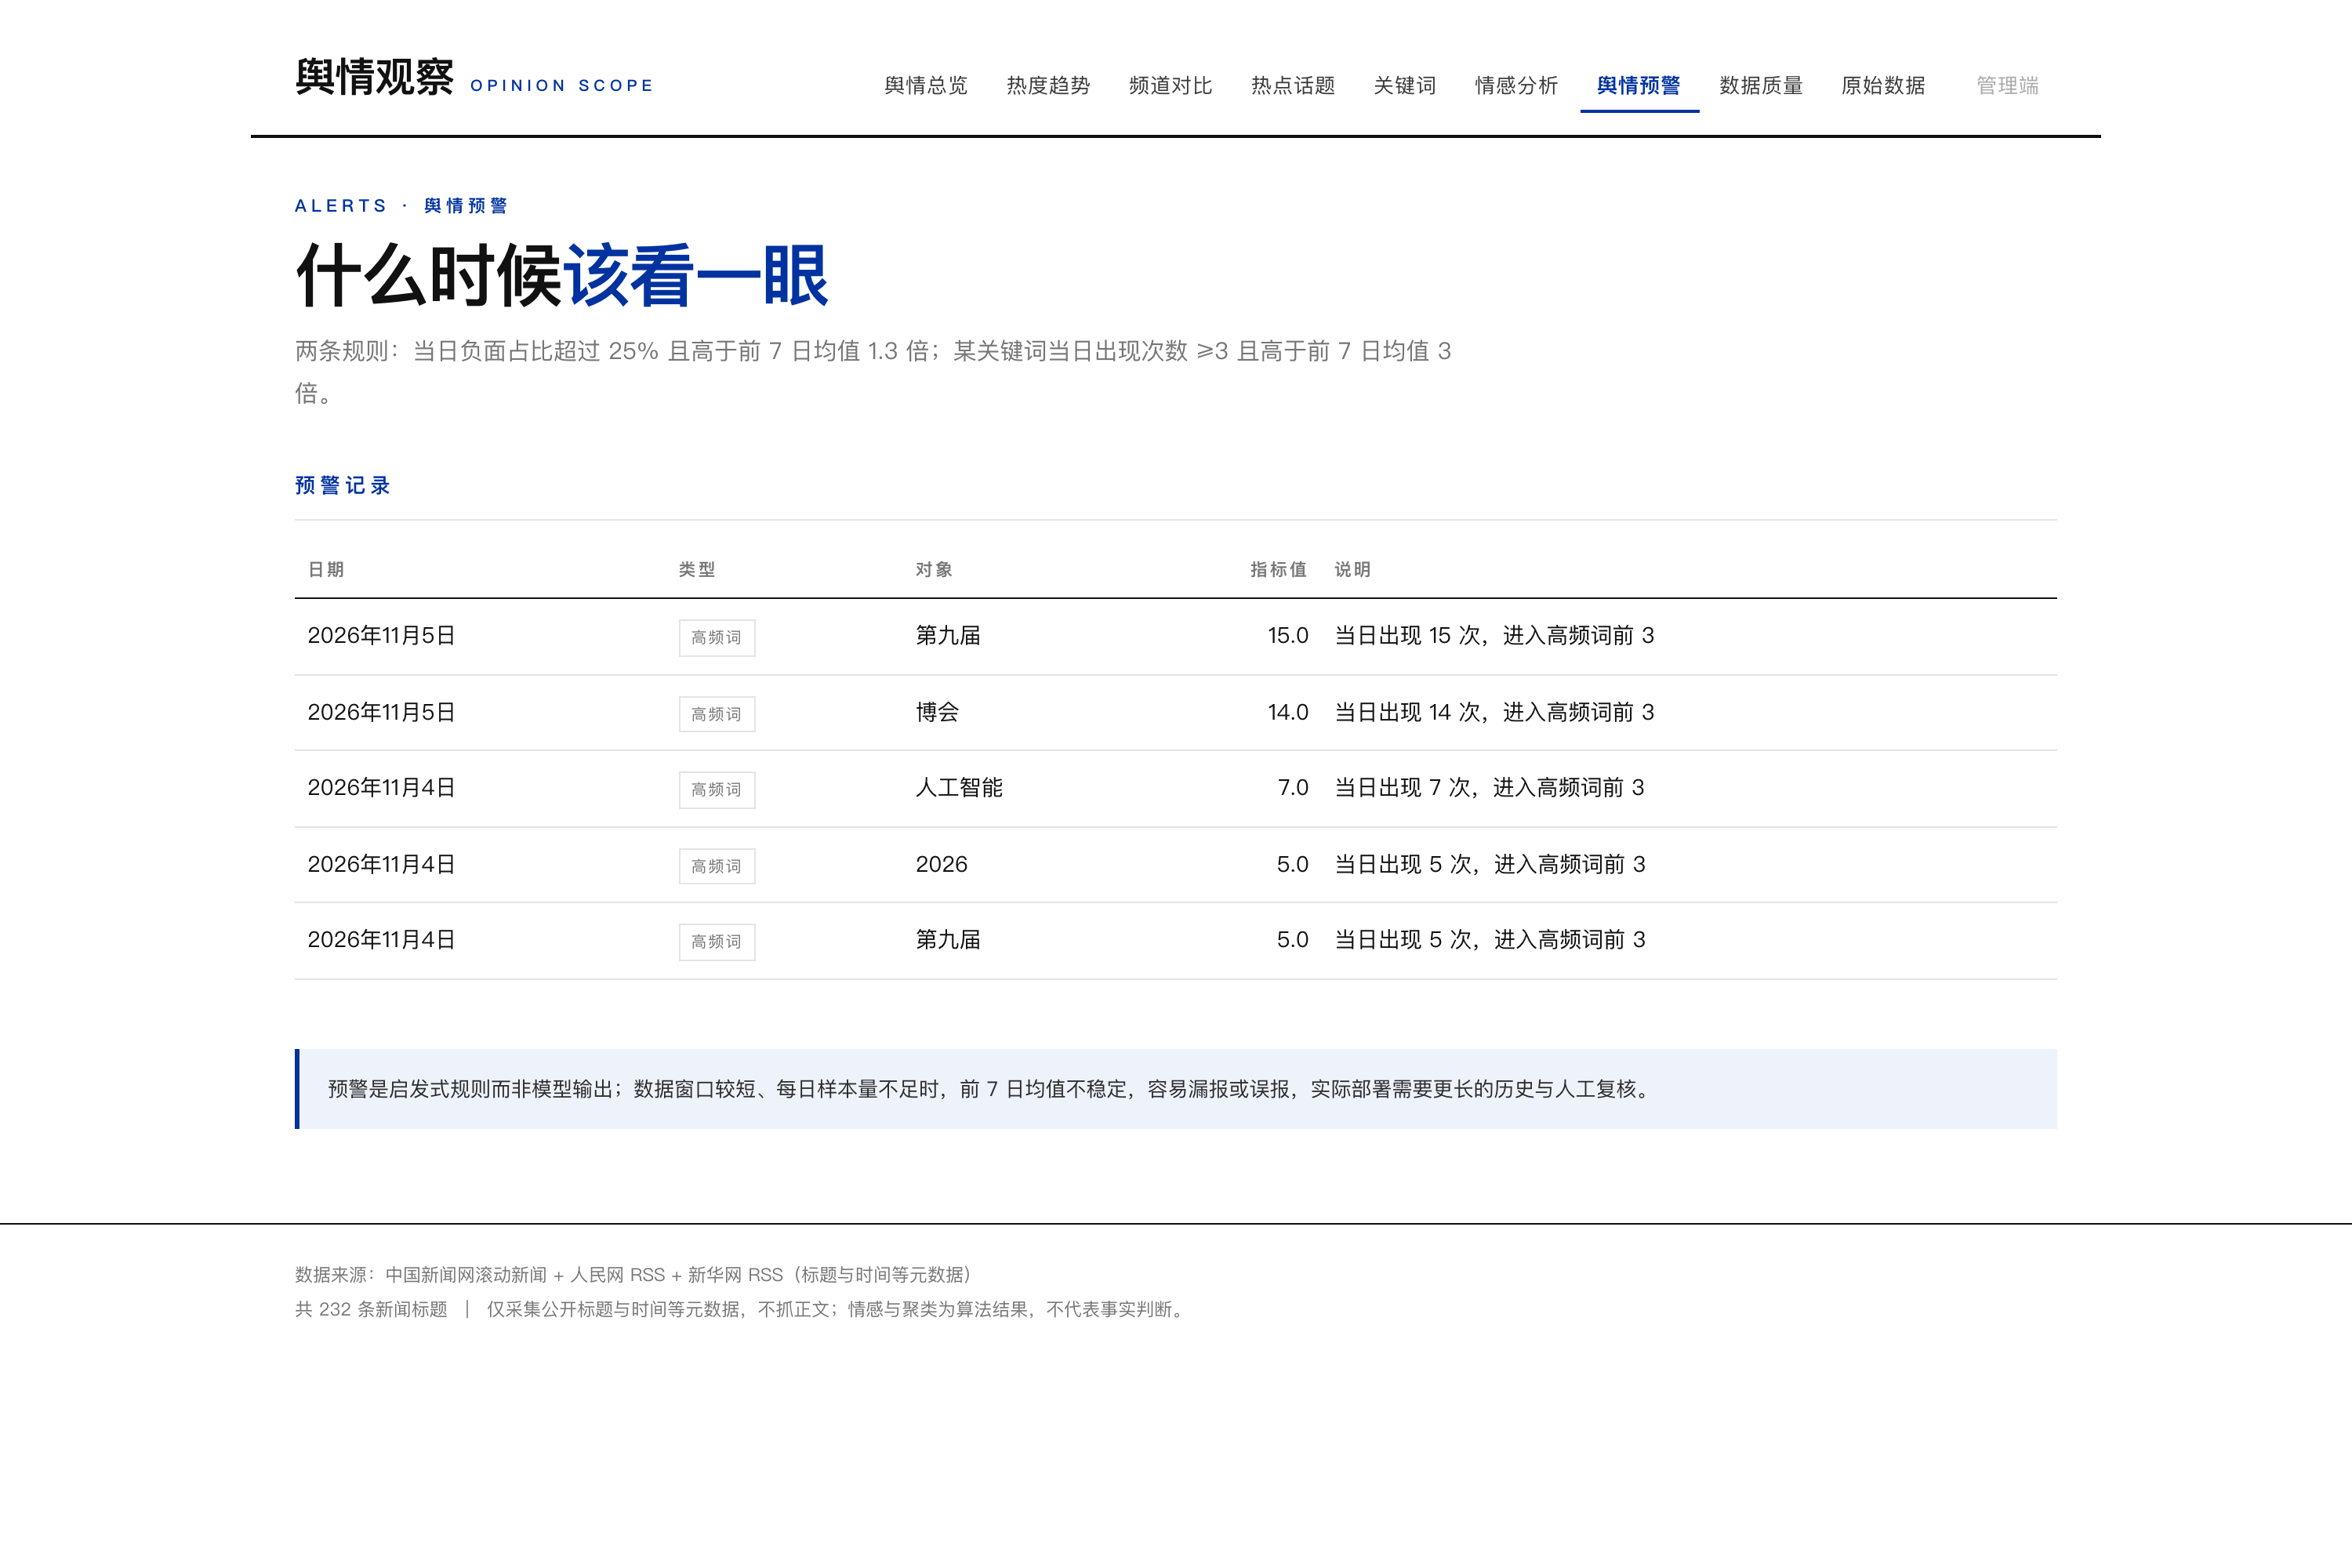
- 预警:负面占比 ≥25% 记一条、每日高频词取前三且 ≥5 次;因窗口仅 2 天,弃用不稳定的「7 日移动基线」,规则改动本身写进论文
- 9 个页面 + 原始 CSV 下载 + Django admin,ECharts 本地内置离线可用;第 20 套杂志特稿风(纯白 + 墨黑大字 + 克莱因蓝)
- 论文实验可复现:所有数字来自 data/analysis/findings.json,重跑 import_news 自动更新
运行环境
- 编程语言:Python 3.8 及以上
- 后端框架:Django 4.2
- 数据采集:requests 抓中新网滚动/频道页 + RSS 解析(低频、只取元数据)
- 文本分析:jieba 0.42(分词/TF-IDF)、SnowNLP(情感)、scikit-learn 1.3(TF-IDF + KMeans)
- 数据库:MySQL 8.0(交付默认 SQLite,免安装)
- 可视化:ECharts 5(已内置本地文件,离线可用)
- 数据规模:原始 725 条 / 清洗后 232 条 / 8 频道 / 2 天 / 8 话题
- 操作系统:Windows / macOS / Linux
- 启动方式:双击一键脚本,或 python manage.py runserver 8085
界面截图
文档预览
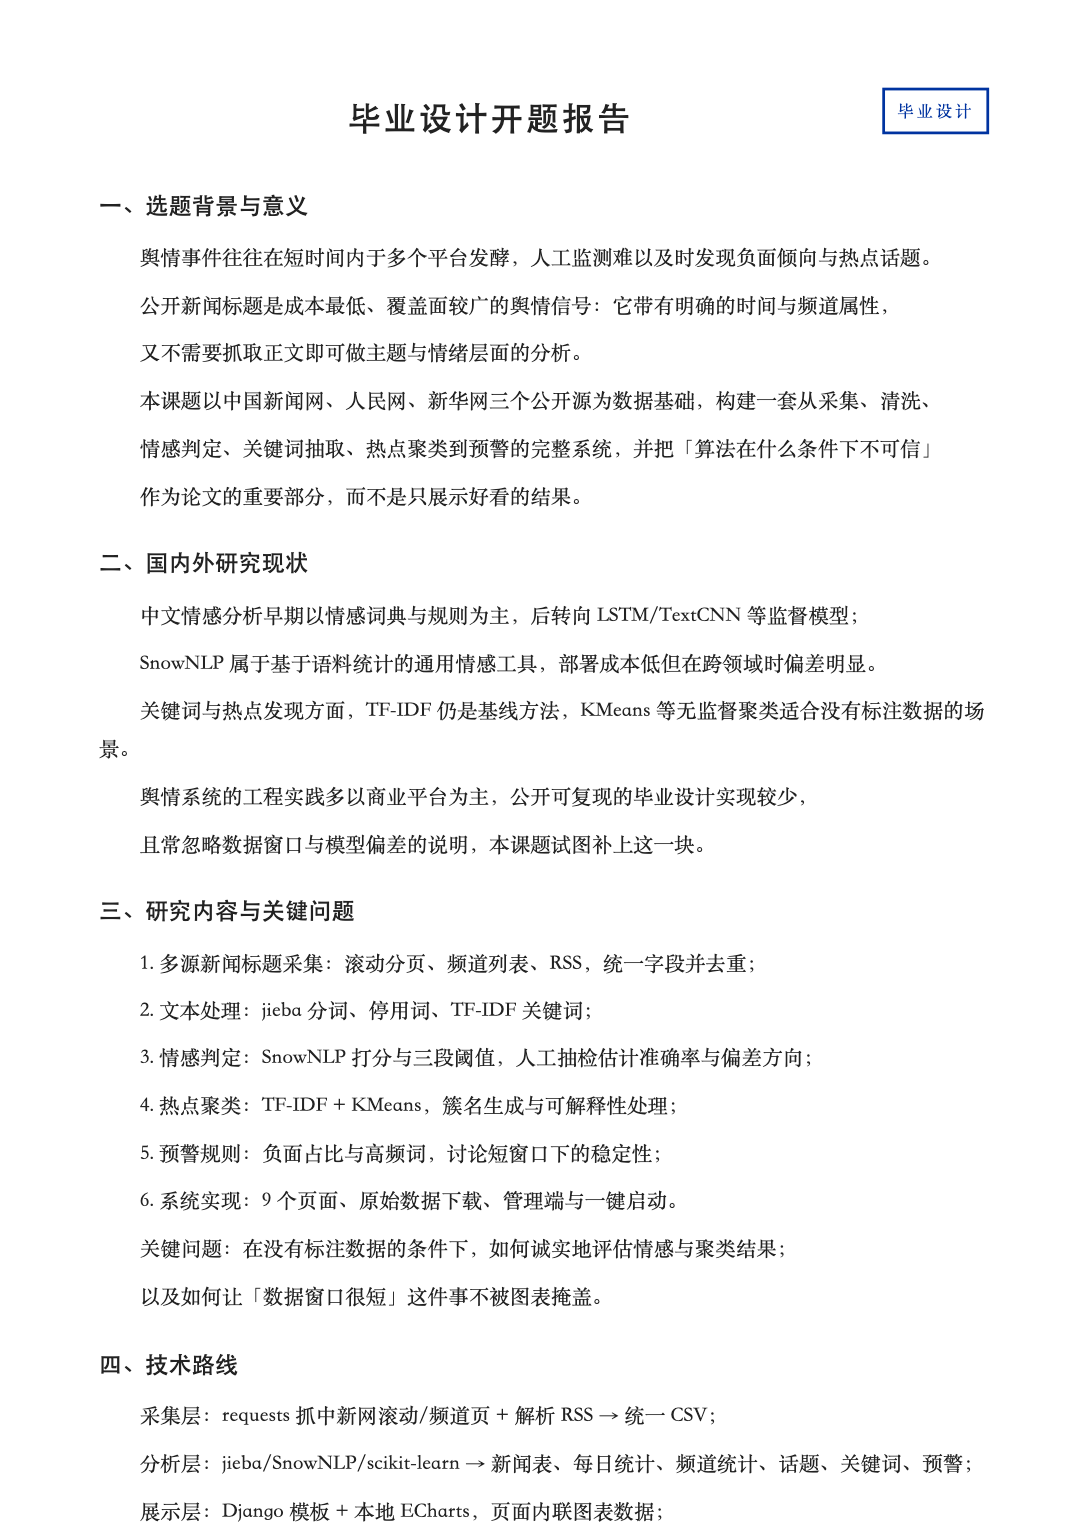
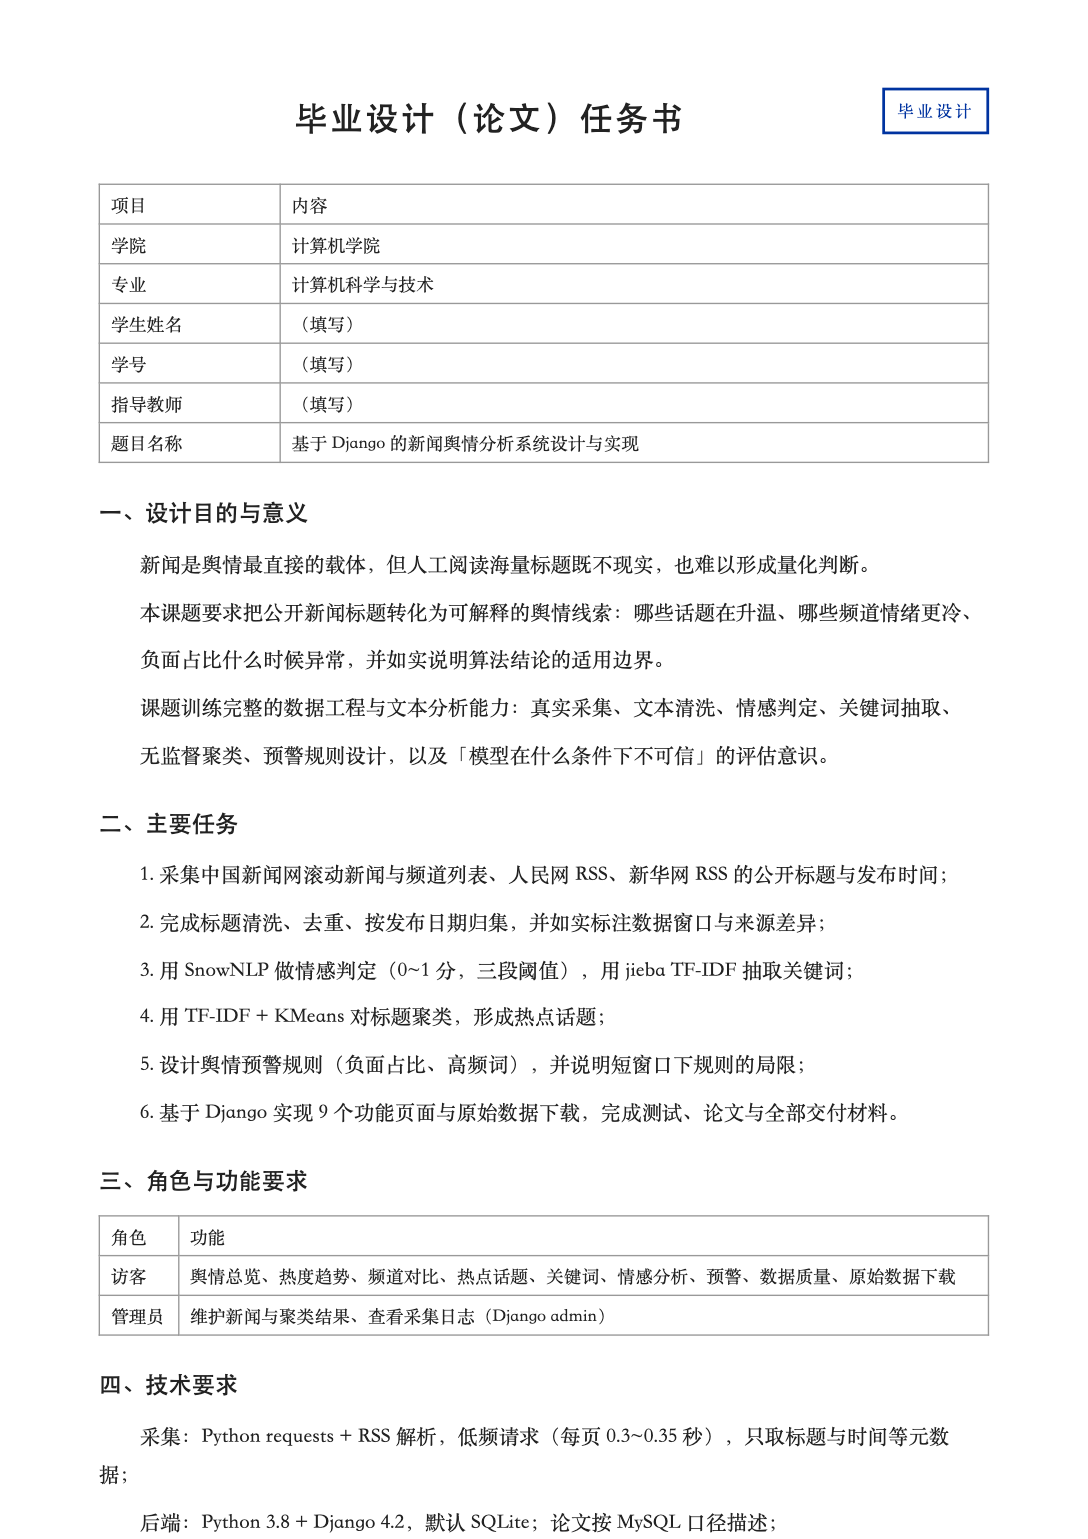
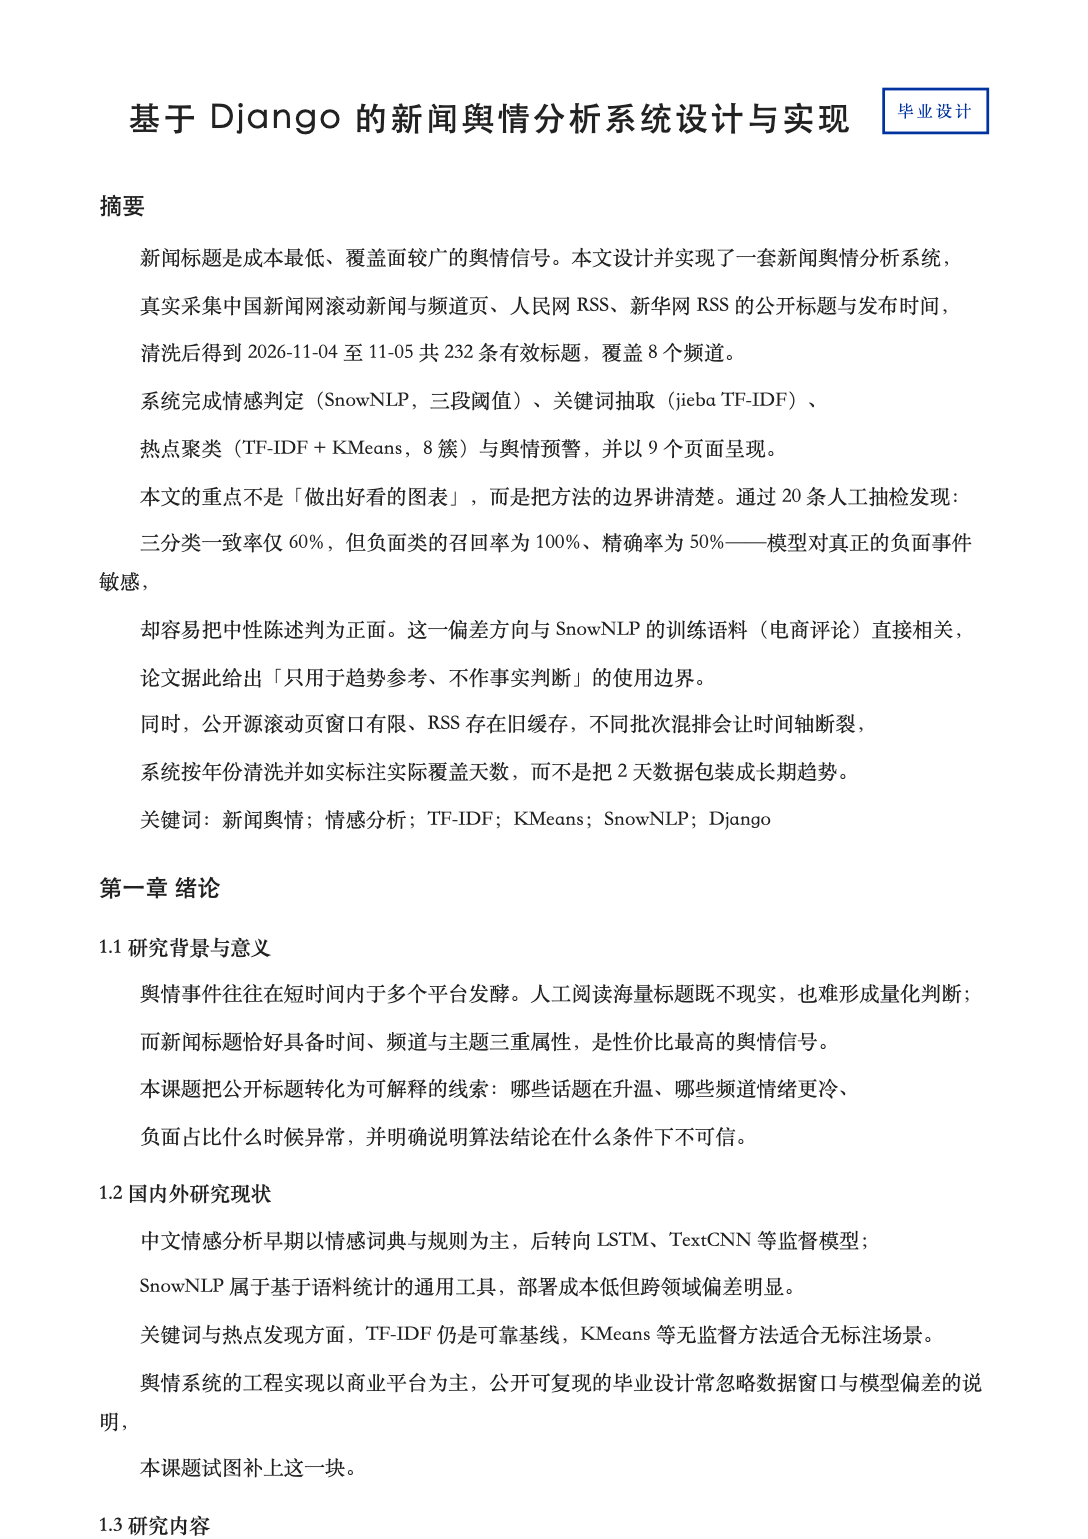
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览:
交付内容
- 完整源码(Django 工程 + 真实采集脚本 + 情感/关键词/聚类/预警导入命令)
- 原始新闻标题 CSV 与演示数据库、findings.json 实验产物
- 毕业设计任务书(Word)
- 毕业设计开题报告(Word)
- 毕业论文(Word,七章制,含人工抽检与模型偏差分析)
- 系统使用与二次开发说明(Word + md)
- 系统运行截图 11 张