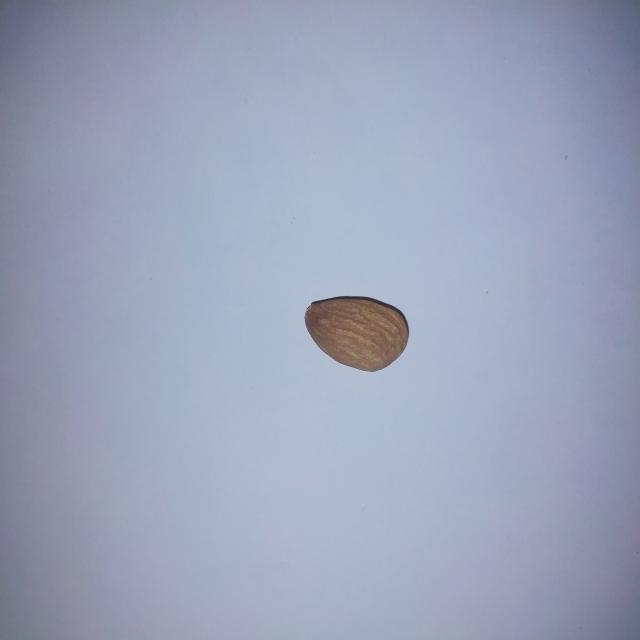
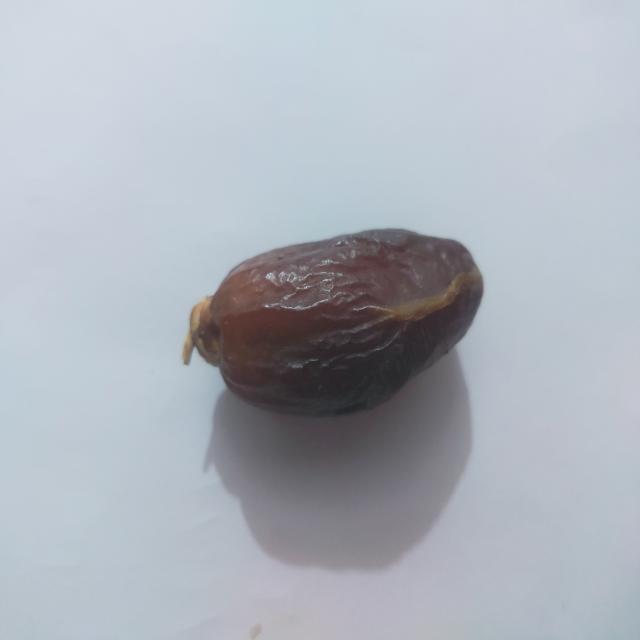
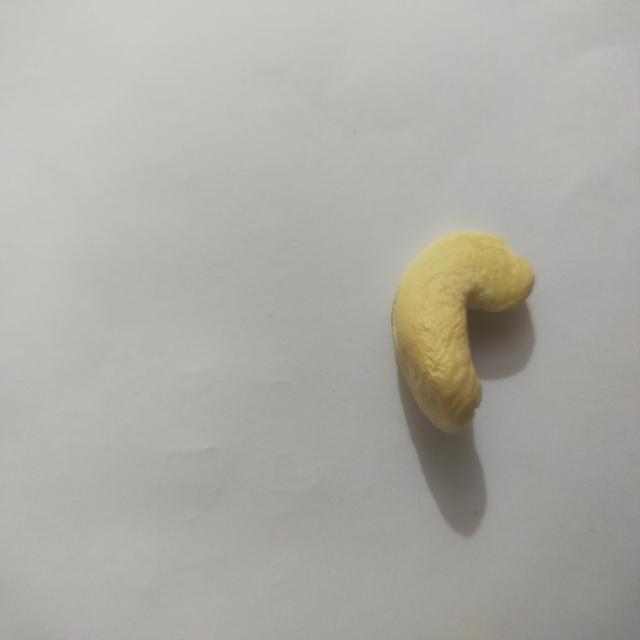
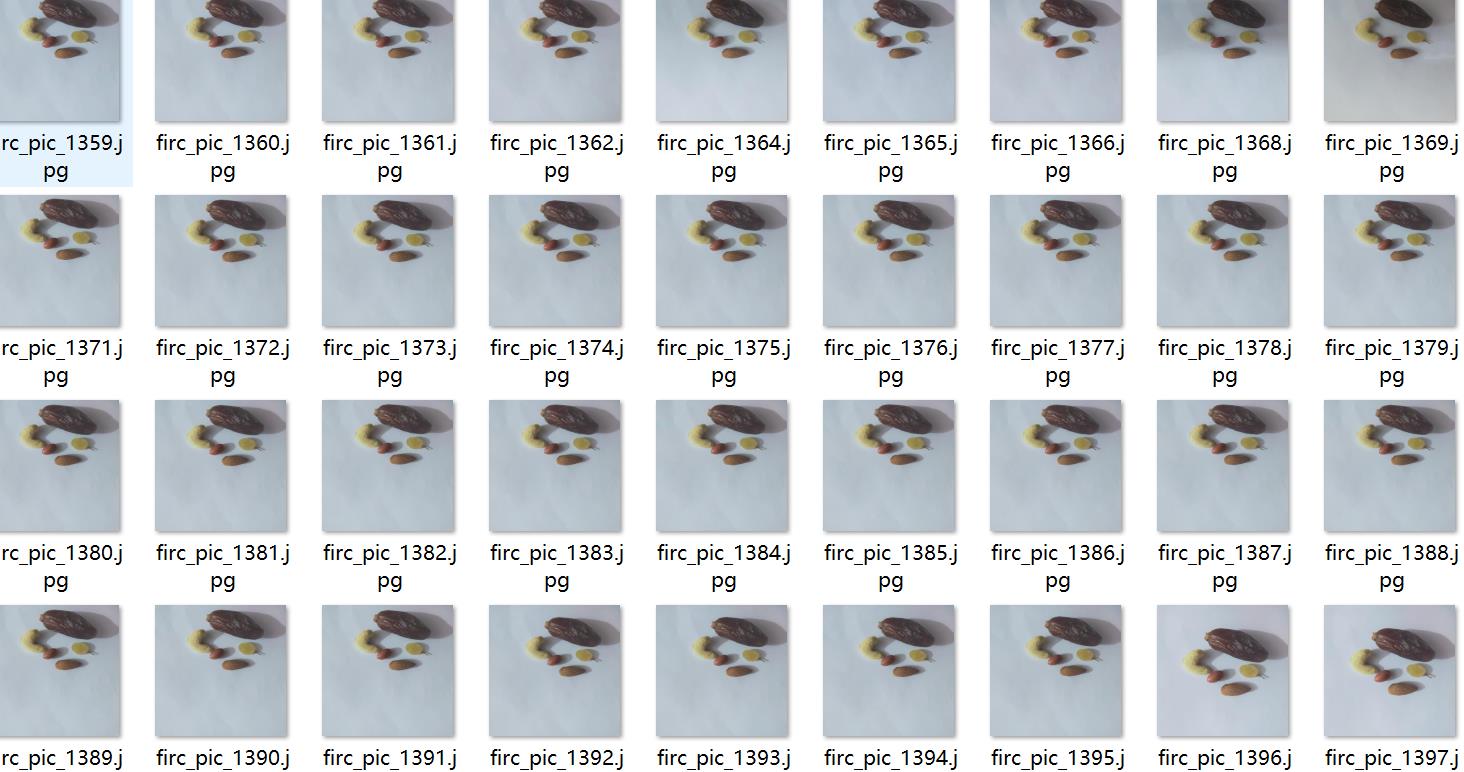
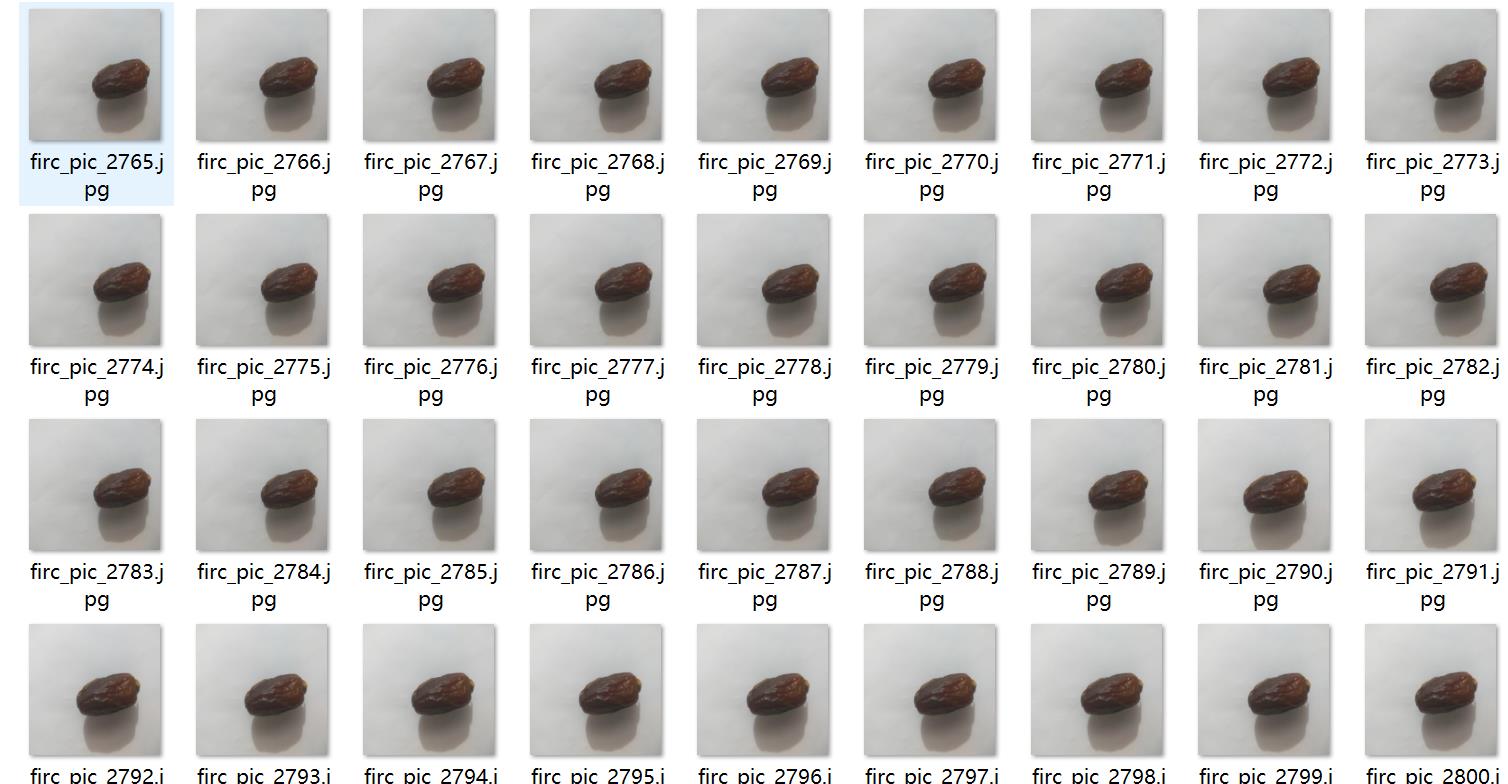
注意数据集中是多段视频抽帧形成图片因此看起来“重复”图片较多注意查看数据集图片
数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件)
图片数量(jpg文件个数):3772
标注数量(xml文件个数):3772
标注数量(txt文件个数):3772
标注类别数:5
所在github仓库:firc-dataset
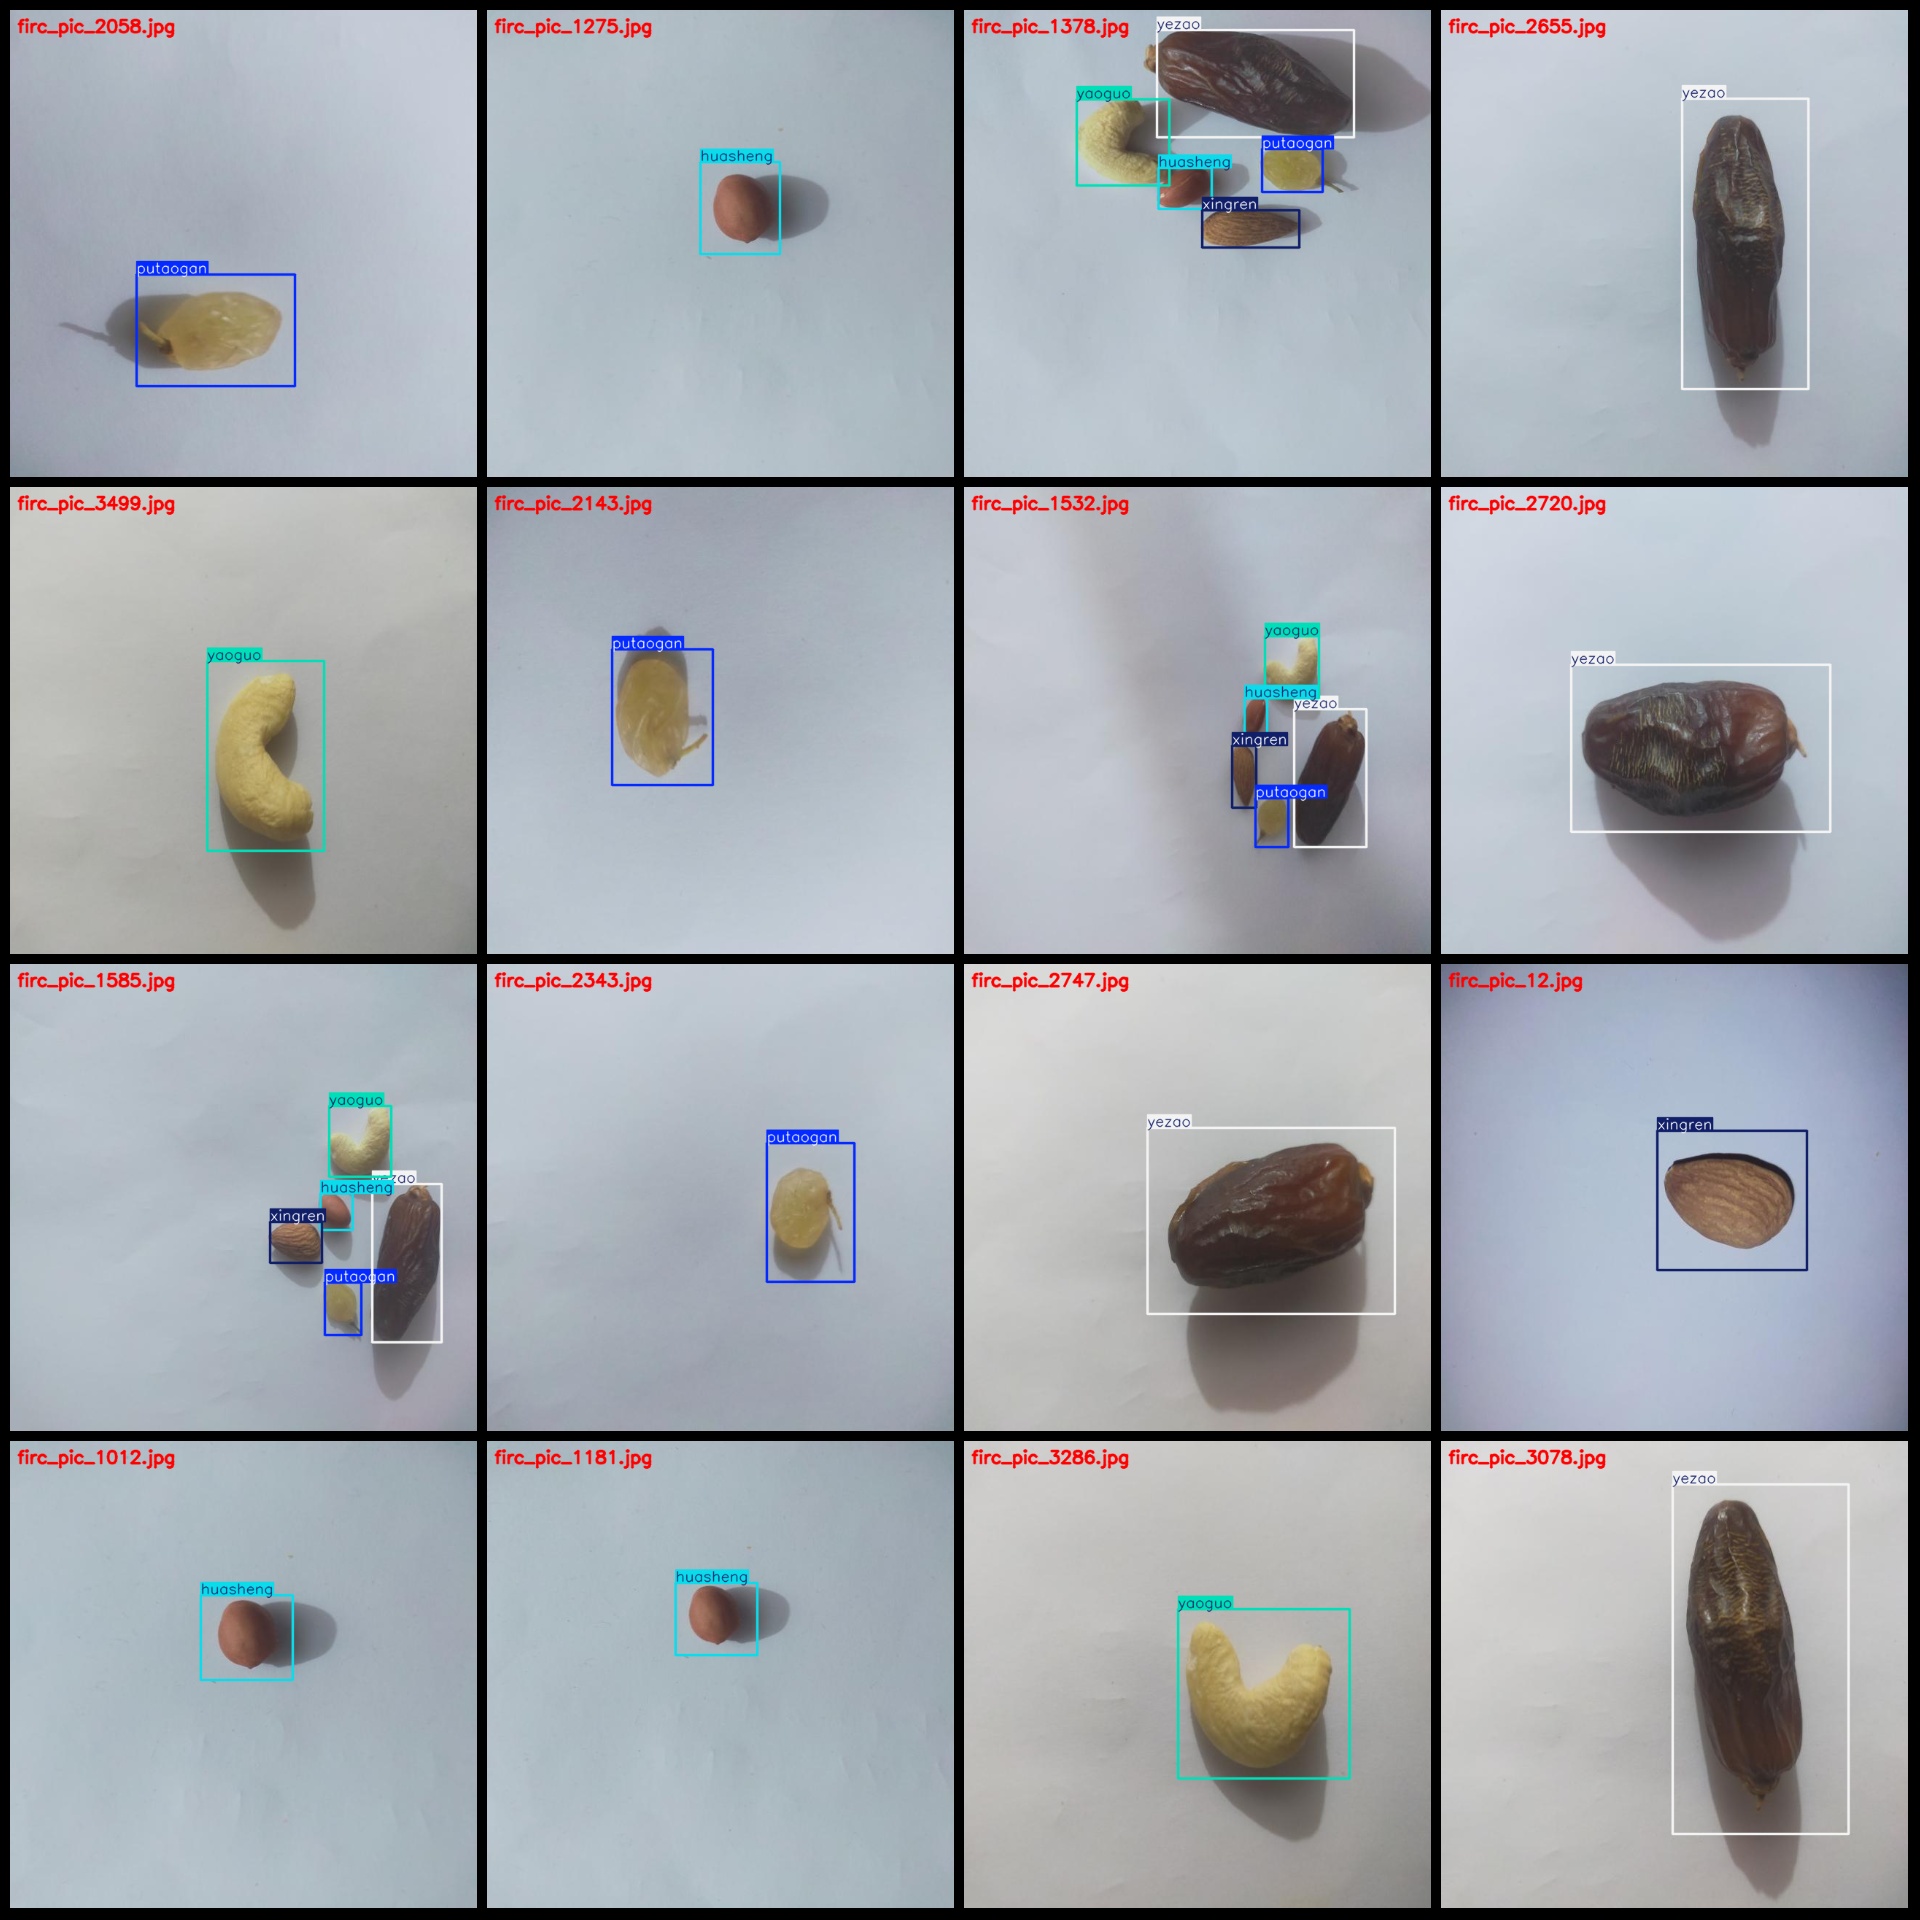
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["huasheng","putaogan","xingren","yaoguo","yezao"]
对应中文类别名:["花生", "葡萄干", "杏仁", "腰果", "椰枣"]
每个类别标注的框数和占有图片数:
huasheng 框数=1291,占有图片数=1289
putaogan 框数=1277,占有图片数=1263
xingren 框数=1282,占有图片数=1278
yaoguo 框数=1263,占有图片数=1257
yezao 框数=1277,占有图片数=1273
总框数:6390
图片分辨率:640x640
使用标注工具:labelImg
标注规则:对类别进行画矩形框
重要说明:数据集没有划分训练验证测试集需自行划分
特别声明:本数据集不对训练的模型或权重文件精度作任何保证
图片预览:
标注例子:
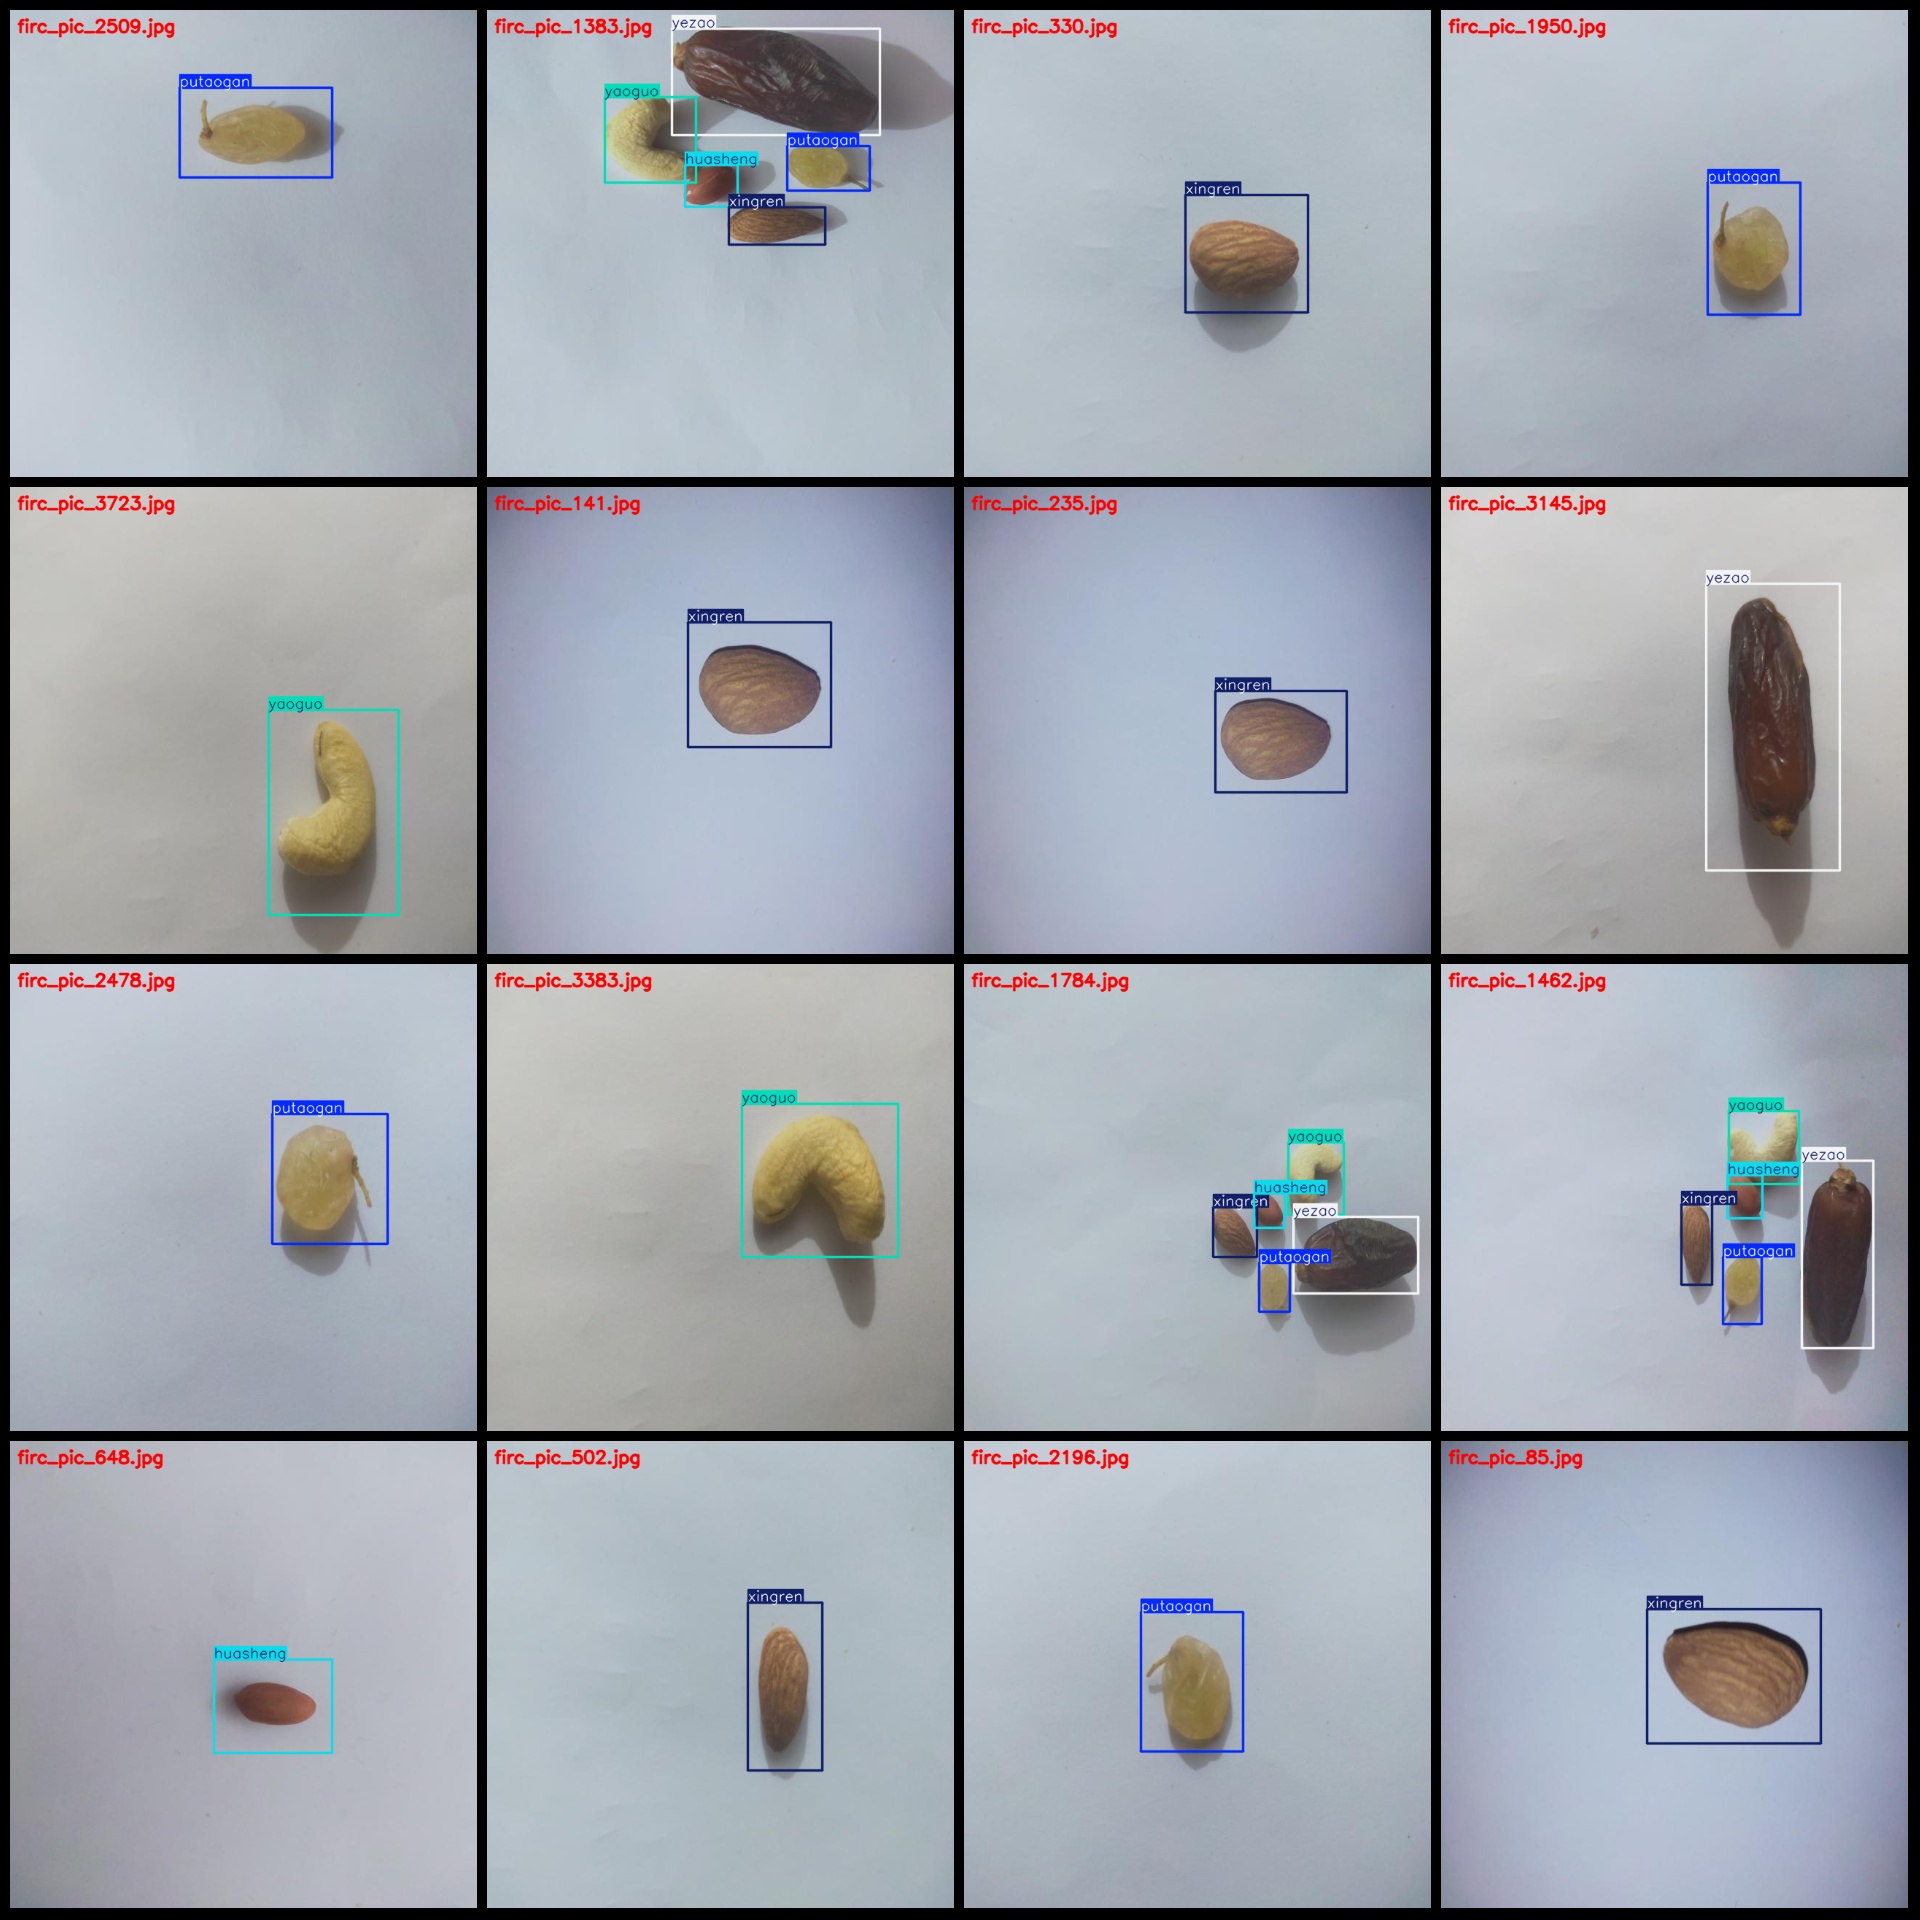
单张图片: