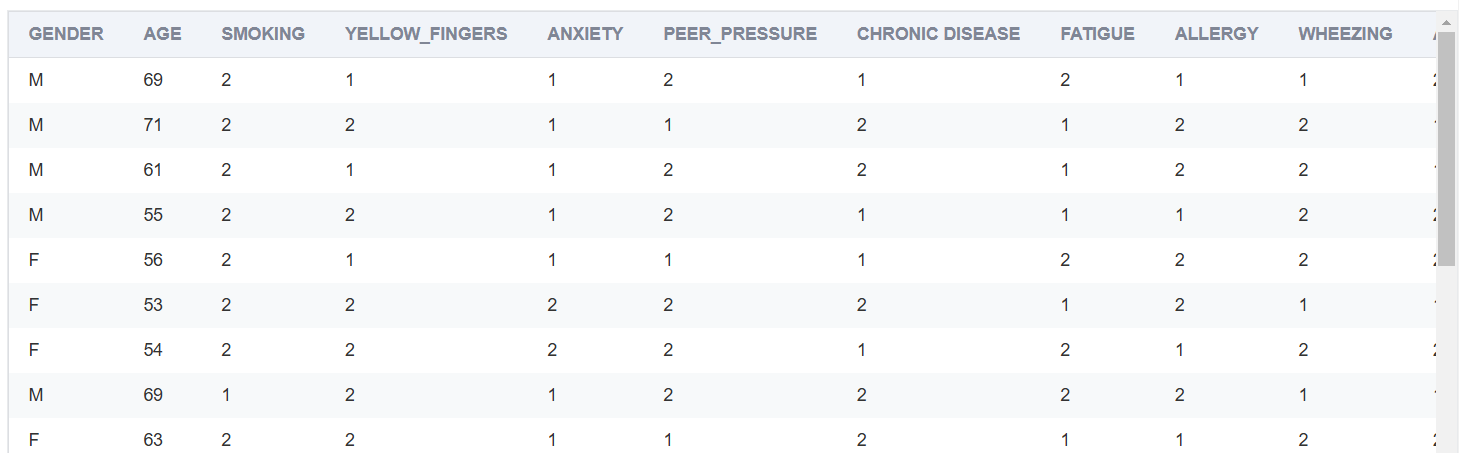
该数据集包含 20,000 条匿名患者记录,其中包含与肺癌风险因素和症状相关的 16 个属性(15 个特征 + 1 个目标变量)。它专为二元分类而设计,以根据人口统计学、生活方式和健康指标预测患者是否患有肺癌。
数据说明
特征 (自变量)
所有二元分类特征(除 和 外)都编码为:AgeGender
1 = 否(不存在)
2 = 是(存在)
特征 描述 可能的值
性 患者的性别 M(男)、(女)F
年龄 患者年龄(岁) 数字(例如,45、60)
吸烟 吸烟习惯 1(否)、(是)2
YELLOW_FINGERS 手指变黄 1(否)、(是)2
焦虑 存在焦虑 1(否)、(是)2
PEER_PRESSURE 暴露于同伴压力(例如,吸烟影响) 1(否)、(是)2
CHRONIC_DISEASE 存在慢性疾病 1(否)、(是)2
疲劳 疲劳程度 1(否)、(是)2
过敏 存在过敏 1(否)、(是)2
喘息 喘息症状 1(否)、(是)2
ALCOHOL_CONSUMING 饮酒 1(否)、(是)2
咳嗽 咳嗽严重程度 1(否)、(是)2
SHORTNESS_OF_BREATH 呼吸困难 1(否)、(是)2
SWALLOWING_DIFFICULTY 吞咽困难 1(否)、(是)2
CHEST_PAIN 存在胸痛 1(否)、(是)2
目标变量 (因变量)
特征 描述 可能的值
LUNG_CANCER 存在肺癌 YES,NO
数据集特征
实例数:20000
特征数量:16(15 个预测变量 + 1 个目标)
特征类型:
分类 (,GENDERLUNG_CANCER)
二进制 (, , etc.)SMOKINGYELLOW_FINGERS
数值 (AGE)
班级分布:
可能不平衡(常见于癌症病例少于非癌症病例的医学数据集)。
缺失值:
检查是否有任何要素包含缺失数据(例如 )。NaN
可能的用例
肺癌的早期发现
训练 ML 模型(Logistic Regression、Random Forest、XGBoost)以预测癌症风险。
风险因素分析
确定与肺癌密切相关的关键症状。
医疗决策支持
根据患者报告的症状协助医生进行初步诊断。
注意事项和限制
医学上不准确
这是一个合成/教育数据集,不应用于真正的医学诊断。
二进制编码 (1=否,2=是)
如果转换为 (NO) 和 (YES),某些模型的性能可能会更好。01
建议的预处理步骤
转换二进制特征(保持一致性):
更换 → (NO)10
替换 → (YES)21
对分类变量进行编码:
GENDER: → , →M1F0
LUNG_CANCER: → , →YES1NO0
归一化 AGE(如果使用基于距离的模型,如 KNN 或 SVM)。
处理类不平衡 (如果倾斜)。LUNG_CANCER