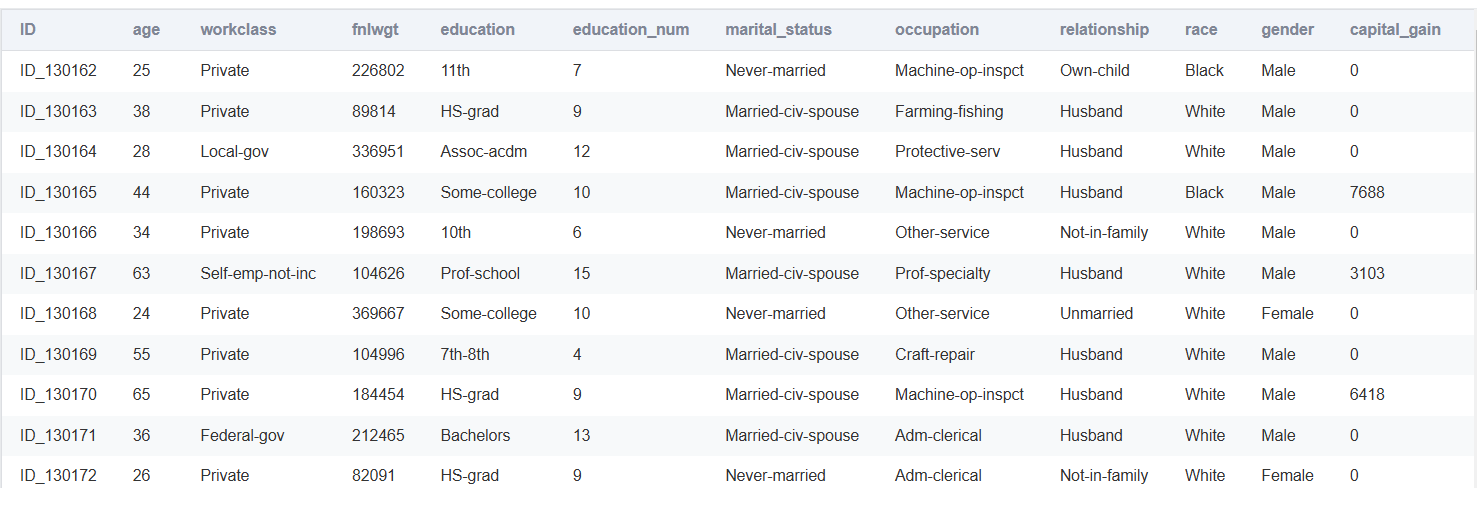
该数据从美国1994年人口普查数据库抽取而来,可以用来预测居民收入是否超过50K。该数据集类变量为年收入是否超过/𝑦𝑒𝑎𝑟。该数据集类变量为年收入是否超过50𝑘
,属性变量包含年龄,工种,学历,职业,人种等重要信息,14个属性变量中有7个类别型变量,是Classification/Regression模型训练的经典数据集。
如何在线使用数据集
Python用户,创建项目后,输入 !ls ../input/workshop/ 查看数据路径
R用户,创建项目后,输入 !list.files('../input/workshop/') 查看数据路径
数据说明
- 文件列表
- 该数据集包含2个文件:
income_census_train.csvincome_census_test.csv: 不包含类别label数据的测试集- 数据集的整体特征
数据集名称 | 数据类型 | 特征数 | 实例数 | 值缺失 | 相关任务
-------------| ------- |-----------| ---------| ---------|----------|--------
人口普查收入数据集 | 数值数据 | 14 | 45222 | 无 | 分类与预测
- 属性描述
- 文件
income_census_train.csv中包含16个字段,具体信息如下: - 每一行记录了一个人的人口普查结果。该数据集类变量为年收入是否超过50k$,属性变量包含年龄,工种,学历,职业,人种等重要信息,14个属性变量中有7个类别型变量。
No| 属性 | 数据类型 | 数值类型 | 字段描述 |
----|-----|------------|-------------|
1 | ID | - | String | 人的ID
2 | age | Numeric | Integer | 年龄
3 | workclass | Categorical | String | 工作类型
4 | fnlwgt | Continuous | Integer | 序号
5 | education | Categorical | String | 教育程度
6 | education_num | Numeric | Integer | 受教育时间 (年)
7 | marital_status | Categorical | String | 婚姻状态
8 | occupation | Categorical | String | 职业
9 | relationship | Categorical | String | 关系
10 | race | Categorical | String | 种族
11 | gender | Categorical | String | 性别
12 | capital_gain | Numeric | Integer | 资本收益
13 | capital_loss | Numeric | Integer | 资本损失
14 | hours_per_week | Numeric | Integer | 每周工作时长
15 | native_country | Categorical | String | 原国籍
16 | income_bracket | Categorical | Integer | 收入档次: 0-'<=50K', 1-'>50K'
文件 income_census_test.csv中包含15个字段,与文件 income_census_train.csv的前15个字段一致,但不包含类别字段。
数据集可探索、研究的方向
- 可以可视化探索数据
- 可以用来预测居民收入是否超过50K$/year